OpenAI、自社チップJalapeñoはワット当たりでNvidiaのGB300を上回ると主張
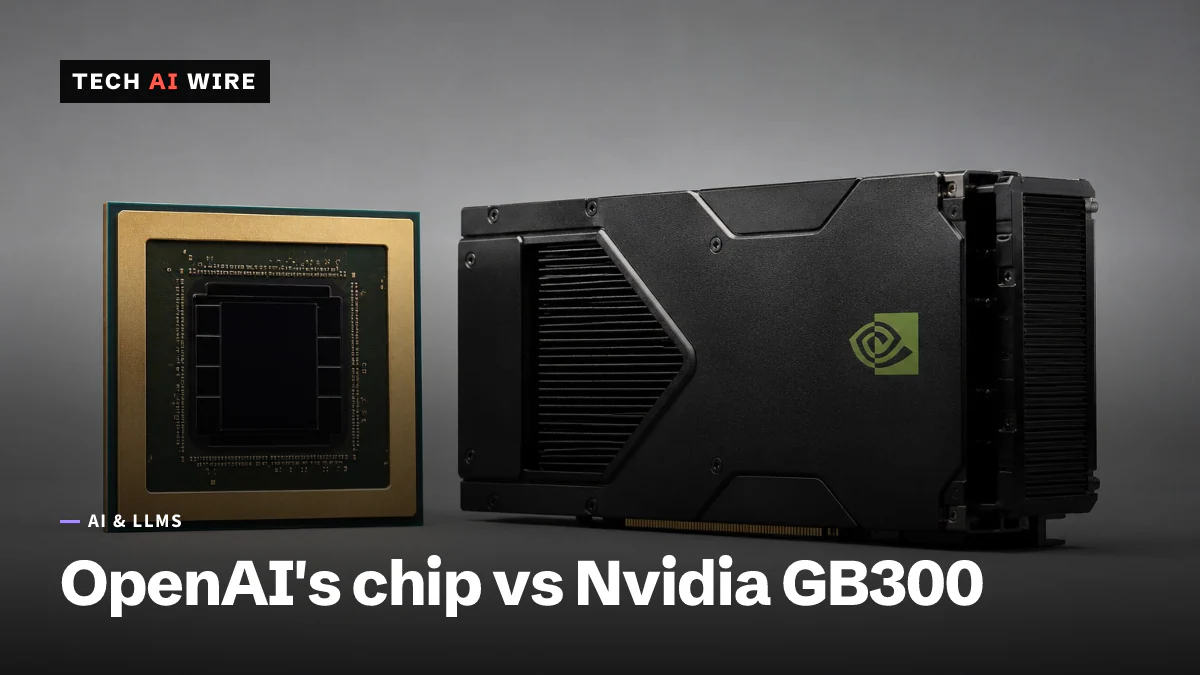
OpenAIが初めて公開したJalapeñoのベンチマークは、NvidiaのGB300に対してキロワット当たり1.5倍から1.9倍の処理を半分の電力で行うと主張する。数字はOpenAI自身のものだ。
4 分で読めます
数字で見る
- more throughput per kilowatt, per OpenAI
- 1.5-1.9x
- lower end-to-end latency at the top of the range
- 3.6x
- HBM4 memory on each chip
- 216 GB
- from first design to tape-out
- 9 months
- OpenAI Jalapeño
- 700W
- Nvidia GB300
- 1400W
OpenAIは、Broadcomと共同で作った推論チップJalapeñoの初のベンチマークを公開し、Nvidiaの旗艦製品を上回ると述べた。The RegisterとTechCrunchが2026年8月25日にその数字を報じた。OpenAIは、競合システムに対してキロワット当たり1.5倍から1.9倍のAI処理と、1.7倍から3.6倍低いレイテンシを主張している。チップの定格電力はNvidiaのGB300の半分だ。この数字がOpenAI自身のテストの外でも持ちこたえるなら、モデルを提供するコストに2つ目の供給元ができたことになる。
推論とは、学習済みモデルを動かしてリクエストに答える作業で、モデルを学習させることとは対をなす。製品に利用者がつけば、AI製品の電力の大半はそこに使われる。ワット当たりでより多くの推論をこなすチップは、請求書の最大の項目を削る。
OpenAIが公開した数字
Tom's Hardwareによれば、Jalapeñoの定格は700ワットで、NvidiaのGB300は1400ワットだ。これを根拠に、OpenAIはキロワット当たり最大1.9倍のスループットを主張している。The Registerは、超低レイテンシの処理では優位が2.1倍から4.1倍に広がると付け加え、チップの消費電力を競合GPUシステムの40%から60%と見積もっている。
The Registerによる、チップ単体の仕様は次の通りだ。
| 項目 | Jalapeño |
|---|---|
| MXFP4での演算性能 | 13.4 petaFLOPS |
| メモリ | 216 GB HBM4 |
| メモリ帯域幅 | 15.4 TB/s |
| 定格電力 | 700 W |
MXFP4は4ビットの数値形式で、重みを密に詰め込むことでモデルのより多くの部分が高速メモリに収まる。HBM4は高帯域幅メモリで、チップの隣に置かれる積層メモリだ。128チップを収めたフルラックでは、4ビット演算で1.7 exaFLOPS、メモリ27.5 TB、帯域幅は毎秒2ペタバイト近くに達する。
速さの源
設計上の賭けは、データの移動を減らすことにある。OpenAIのハードウェア責任者Richard HoはTechCrunchにこう語った。「私たちはデータの移動と通信の遅延を最小化するようJalapeñoを設計した」。The Registerは、大きなオンチップSRAMキャッシュと、KV cacheの慎重な配置を報じている。KV cacheとは、モデルが毎ステップ参照する過去トークンの保存領域だ。
それが重要なのは、推論に2つの段階があるからだ。プリフィルはプロンプト全体を一度に読み、デコードは答えを1トークンずつ生成する。遅いのはデコードで、チップがすでに知っていることをどれだけ速く取り出せるかに縛られる。そのデータを近くに置くことが、レイテンシの数字に反映されている。
このチップは異例の速さで作られてもいる。The Registerによれば、初期設計からテープアウト、つまり製造のために設計が確定する時点まで9か月だった。同誌はこれを「(一部は)AIによって、AIのために設計された」と表現している。TechCrunchは、OpenAI自身のモデルが設計を支援したことを確認している。
実際に使えるようになる時期
すぐではない。TechCrunchによれば、OpenAIは2026年末に「ごく少量」でJalapeñoを配備し、2027年により広く展開する見込みだ。プロジェクトは2025年10月に初めて発表され、TechCrunchはこれを複数世代にわたるプラットフォームと表現している。つまりこれは、シリーズの最初のチップだ。
Hoは、結果が何を意味すると考えるかを率直に語った。「要点は、この結果が最先端に対して非常に、非常に大きな性能の前進を示しているということだ」と彼はTechCrunchに述べた。さらに、Jalapeñoは「電力単位当たりでより多くのAI処理を提供しながら、応答もより速く返せる」と付け加えた。
これが開発者にとって意味すること
すべての数字を、一つの事実を目の前に置いて読みたい。この数字はOpenAIから出ている。独立した研究機関はまだ再現しておらず、比較対象はNvidiaが公表した定格電力だ。ベンダーが自社チップについて出す最初のベンチマークは主張であり、測定ではない。注視する理由として扱い、計画を組み替える理由にはしない。
大規模に推論を回しているなら、借りるべき指標はキロワット当たりの処理量だ。多くのチームはいまもGPUの台数で予算を組んでいる。データセンターの上限を実際に決める制約は電力であり、OpenAIが戦う軸として選んだのもそこだ。自分のワークロードについて、キロワット時当たりのトークン数を今から追い始めたい。そうすれば、このチップを含むどのチップも、出荷されたときに評価できる。
あなたがJalapeñoを買うことはない。報道が描くのは、OpenAI自身のフリート向けに作られ、当初は少量のチップだ。あなたに届く経路は、早くても2027年の、OpenAIのAPI価格とレイテンシを通してだ。製品が速いデコードに依存しているなら、最初の本物のシグナルとして、来年のOpenAIのトークン当たりレイテンシの数字を見ておきたい。
覚えておく価値があるのは、9か月でのテープアウトだ。フロンティア研究所が、自社のモデルの助けを借りて、1年足らずで競争力のある推論チップを設計した。これが本当なら、カスタムシリコンは最大手の企業だけができる5年がかりの賭けではなくなる。Nvidiaが守れる立場は、ソフトウェアと供給になり、生の効率ではなくなる。
出典
関連記事
OpenAI Agents API、ホスト型ブラウザーでのコンピューター操作に対応
9月10日からパブリックベータのOpenAIのAgents API(エージェントAPI)は、2026年9月29日のDevDayでコンピューター操作に対応し、OpenAIがホストするブラウザーをエージェントが操作できるようになりました。