Cloudflare Clef:文章ではなく判断を返すオープンウェイトモデル
CloudflareのClef(クレフ、27B)とClef-flash(9B)は、文章を書く代わりに型付きの質問に答えます。レイテンシの中央値は209ミリ秒と39ミリ秒で、ライセンスはApache 2.0です。
3 分で読めます
数字で見る
- parameters in Clef, built on Qwen 3.8-27B
- 27B
- parameters in Clef-flash, built on Qwen 3.5-9B
- 9B
- Clef-flash median latency
- 38.8 ms
- token context window
- 64k
- Clef-flash
- 38.8 ms
- Clef
- 209.3 ms
- Jev
- 524.1 ms
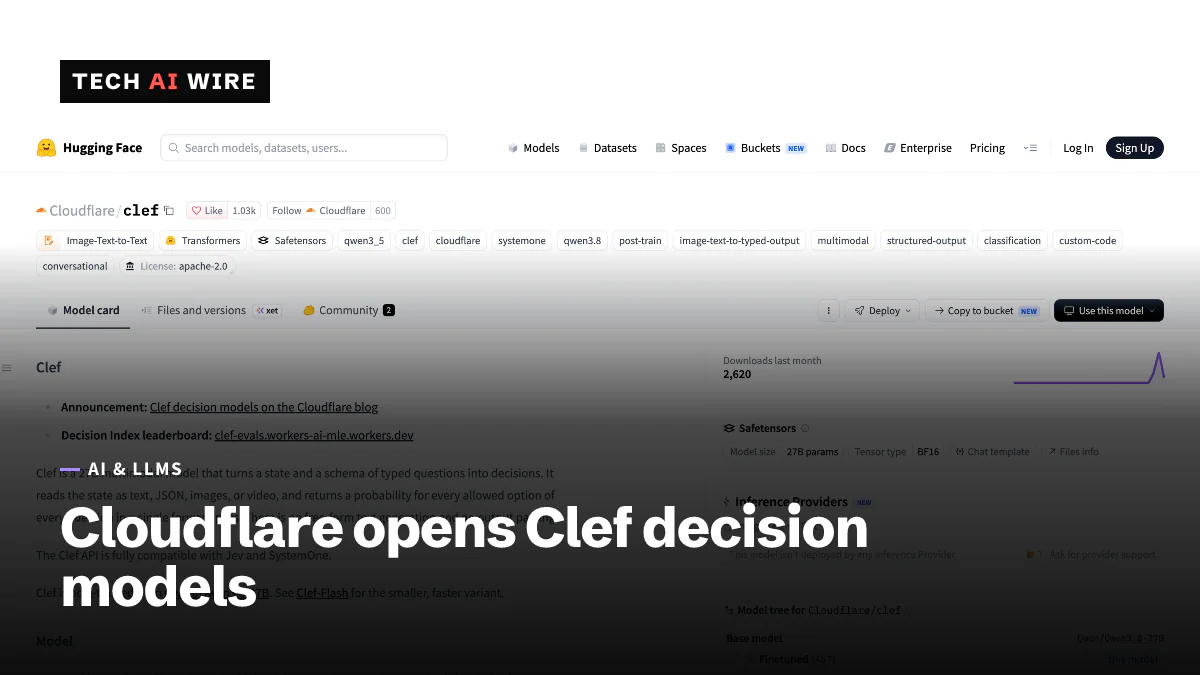
Cloudflareは2026年10月1日、オープンウェイトの判断モデルであるClefとClef-flashの2つを公開しました。これらは文章を書きません。入力を読み、あらかじめ決まった型付きの質問に確率つきで答えます。これにより、AIエージェントは次の行動をすばやく選べます。Cloudflareの発表によると、どちらもApache 2.0ライセンスのもとで無料でダウンロードでき、Cloudflareのホスト型サービスであるWorkers AIで動作します。
判断モデルとは
「判断モデルは、一定の確率に基づいて分類を行い、エージェントがどう行動するかを決める手助けをします」とCloudflareは書いています。チャットモデルは回答を1トークンずつ生成します。Clefはその工程を省きます。Cloudflareはこの設計を非自己回帰型と呼んでいます。つまり、出力を1語ずつ生成しないということです。
Traictoryは仕組みを説明しています。各モデルは入力全体を1回で読み込み、考えられるすべての答えを並列でスコアづけします。何も生成しないため、待つべき推論トークンもありません。
これは、9月15日に公開されたクローズドモデルであるTypeSafeのJevや、その4日後に公開された4億2100万パラメータのオープンモデルであるConvaiのLayaと同じ発想です。Clefは、この発想を多くの開発者がすでに使っているホスト型プラットフォームにもたらします。
2つのモデル
| Clef | Clef-flash | |
|---|---|---|
| パラメータ数 | 270億 | 90億 |
| ベースモデル | Qwen 3.8-27B | Qwen 3.5-9B |
| レイテンシの中央値 | 209.3ミリ秒 | 38.8ミリ秒 |
| コンテキストウィンドウ | 64kトークン | 64kトークン |
| ライセンス | Apache 2.0 | Apache 2.0 |
Cloudflareは、Clef-flashの95パーセンタイルのレイテンシを122.4ミリ秒と報告しています。これは、リクエストの95%がその時間内に完了したという意味です。
どちらのモデルも、Alibabaのオープンモデル群であるQwenを土台にしています。Traictoryによると、ベースのQwenは凍結されたままです。Cloudflareはその上に、ランク256の低ランクアダプターと呼ばれる小さな追加層を学習させました。
Clefにはビジョンエンコーダーもあるため、画像を入力として受け取れます。Cloudflareはこれを、テキストしか扱えないJevとの違いとして示しています。
速度と価格の主張
Cloudflareは、自社の脅威インテリジェンスのテストで、どちらのモデルもOpenAIのオープンモデルgpt-oss-120bと比べてレイテンシを半分にしたと述べています。43のベンチマークでモデルを評価したとも述べています。
価格は注目を集めました。Traictoryによると、Workers AIでのClefの価格は100万トークンあたり0.24ドルで、Jevは100万トークンあたり0.042ドルです。つまりClefはトークンあたりで6倍近く高くなります。TraictoryはJevのレイテンシの中央値を524.1ミリ秒としており、Clefは209.3ミリ秒です。
ホスト型での利用について、Cloudflareは「リクエストを読んだり、保存したり、学習に使ったりしない」としています。重みはHugging Faceでも公開されています。そのため、チームは自前のハードウェアで動かし、トークンごとの料金を完全に避けることもできます。同じ発表では、こうしたモデルを学習させるための新しい強化学習ファインチューニング基盤も紹介されています。
未解決の疑問
Traictoryによると、Hacker Newsのコメント投稿者は価格とベンチマークの手法の両方に疑問を投げかけました。「公開ベンチマークは簡単にごまかせる」とあるコメント投稿者は書いています。Traictoryはさらに、品質に関する主張について「第三者による実行は引用されていない」とも指摘しています。
Traictoryは3つの欠けている点を挙げています。独立した検証、Jevの現行バージョンとの比較テスト、実際の本番運用から得たデータです。どれもまだ存在しません。
開発者にとっての意味
エージェントが各ステップの前に行っている判断を見直しましょう。リクエストの振り分け、メッセージのフラグ付け、ツールの選択は、どれも分類の仕事です。今それを大規模なチャットモデルが担っているなら、判断モデルによってその工程を秒単位からミリ秒単位に短縮できる可能性があります。
まずはClef-flashから始めましょう。中央値が38.8ミリ秒なら、稼働中のアプリのリクエスト経路に置けるほど高速です。27Bモデルに移るのは、自社のテストで小さいほうのモデルの誤答が多すぎるとわかった場合だけにしましょう。
切り替える前に、自分たちで評価を行いましょう。公開されている数値はCloudflareによるもので、外部のグループは再現していません。ログから実際の入力を200〜500件取り出し、正解のラベルを付けて、Clefと現在使っているものを比べてください。
コストは両方の方法で比べましょう。Workers AIではトークンごとに料金を払います。Apache 2.0の重みを使えば、代わりに自前のGPUの費用を払います。利用の多い分類ステップなら、セルフホストのほうが安くなることがあり、データも社内にとどまります。
出典
関連記事
Strands Decider 2Bはエージェントの判断を115ミリ秒で下す
AWSのStrands Decider 2Bは、テキストを書かずに選択肢から選ぶオープンソースのデシジョンモデルだ。RTX 3090で115ミリ秒で答え、JevBenchで72.3%を記録した。
AstaBrief 8B:引用付きの研究レポートを書くAi2のオープンモデル
Ai2は、Qwen3-8BをベースにしたApache 2.0ライセンスのモデル、AstaBrief 8B(アスタブリーフ)を公開しました。引用付きの研究レポートを51.1秒で書き、AstaのThinkingモードより3.5倍高速です。
Qwenの研究用ライセンス「Qwen Research License」を解説
Qwen Research License(Qwenのリサーチライセンス)では、誰でもQwen-Image-2.1をダウンロードできるが、用途は研究または評価に限られる。商用利用には、Qwenから別のライセンスを得る必要がある。