La Decisions API d'OpenAI s'ouvre à tous les développeurs en bêta
La Decisions API d'OpenAI est en bêta publique. Elle renvoie une probabilité, un choix ou un score au lieu de texte, tourne sur GPT-6 Luna et coûte 0,10 dollar par million de tokens d'entrée.
3 min de lecture
En chiffres
- per 1M input tokens, with no output charge
- $0.10
- per request in OpenAI's demo, vs 1.6 s via the Responses API
- ~150 ms
- answer types: predicate, choice and score
- 3
- steps right in Every's preview test, vs 73 for Jev
- 76 of 78
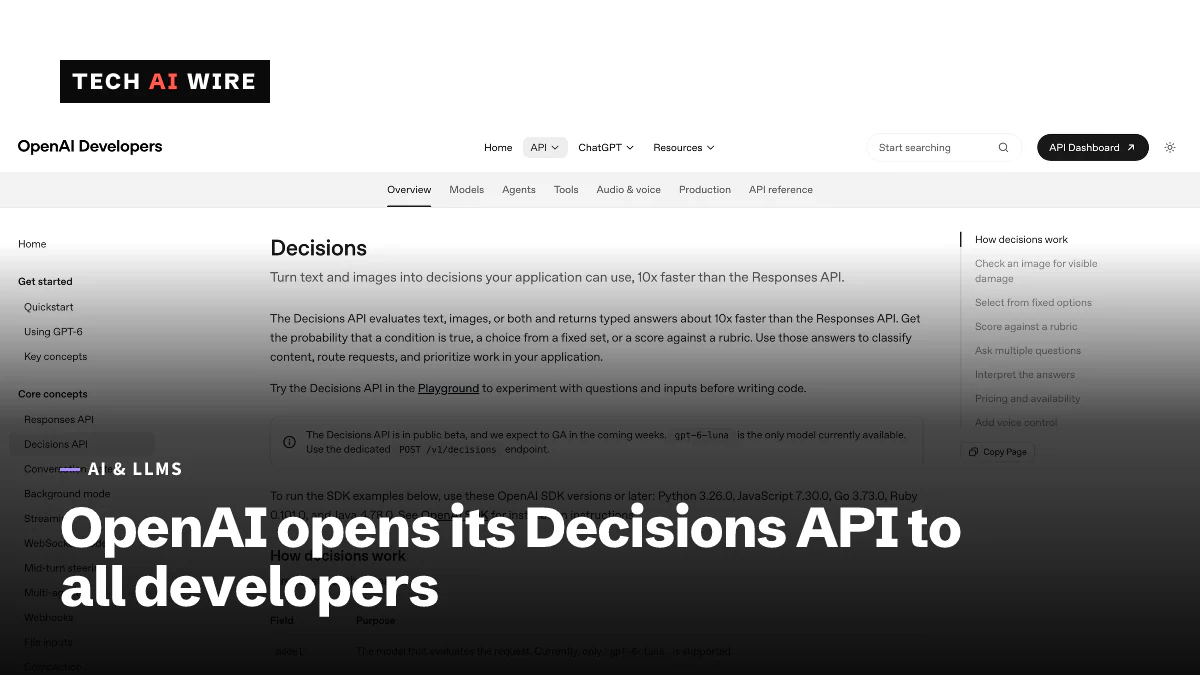
OpenAI a ouvert sa Decisions API à tous les développeurs en bêta publique le 6 octobre 2026, selon AlphaSignal. L'API n'écrit pas de texte. Elle répond à une question fixe par une probabilité, un choix dans une liste ou un score. OpenAI affirme qu'elle est ainsi environ 10 fois plus rapide que la même question posée via sa Responses API. Pour les applications qui font des milliers de petits choix, comme le routage des tickets d'assistance, la vitesse et le prix sont tout l'enjeu.
Ce que fait la Decisions API
La plupart des applications d'IA demandent à un grand modèle de langage, ou LLM, de faire de petits choix toute la journée. Ce message est-il un spam ? Quelle équipe doit recevoir ce ticket ? Le modèle écrit sa réponse sous forme de texte, mot après mot, puis l'application la relit.
La Decisions API saute l'étape d'écriture. Vous lui envoyez des éléments, qui peuvent être du texte, des images ou les deux, ainsi qu'une question. Elle renvoie une réponse typée au lieu de prose. La documentation d'OpenAI liste trois types de réponse :
| Type de réponse | Ce que vous recevez |
|---|---|
| Predicate (prédicat) | Une probabilité entre 0 et 1, pour les questions par oui ou non |
| Choice (choix) | L'une des options que vous avez fournies, avec des probabilités et une valeur de confiance |
| Score | Un score pondéré par les probabilités sur des niveaux ordonnés, avec une confiance |
Les appels passent par un nouveau point de terminaison, POST /v1/decisions. Le seul modèle qu'il fait tourner aujourd'hui est GPT-6 Luna, indique la documentation.
Prix, limites et disponibilité
La documentation indique un prix de 0,10 dollar par million de tokens d'entrée. Les tokens sont les petits morceaux de texte qu'un modèle lit. Les sorties, les lectures de cache et les écritures de cache ne sont pas facturées. Le traitement régional et les entrées très longues coûtent plus cher, mais la page ne donne pas ces tarifs. AlphaSignal a rapporté le jour du lancement qu'aucun tarif propre à Decisions n'avait encore été publié, donc ce chiffre a peut-être été ajouté depuis.
Autres détails tirés de la documentation :
- Statut : bêta publique, avec une disponibilité générale attendue « dans les prochaines semaines »
- Images : elles doivent être envoyées en ligne sous forme d'URL de données base64 ; les liens vers des images hébergées et les identifiants de fichiers ne fonctionnent pas
- Données : résidence des données aux États-Unis et en Europe, plus Zero Data Retention et prise en charge de HIPAA pour les clients éligibles
- SDK : Python 3.26.0, JavaScript 7.30.0, Go 3.73.0, Ruby 0.101.0 et Java 4.78.0
Les limites de débit, la taille maximale des entrées et le nombre maximal d'options ne sont pas précisés.
Quelle est sa vitesse ?
L'argument de la vitesse vient de la propre démonstration d'OpenAI. Celle-ci a routé 10 000 demandes de clients entre les équipes Facturation, Technique et Ventes. Chaque décision a pris environ 150 millisecondes, contre 1,6 seconde via la Responses API, rapporte AlphaSignal. OpenAI n'a publié aucune méthode pour ce test.
La publication Every a mené des vérifications précoces pendant la préversion. Lors d'une relecture hors ligne d'une tâche d'utilisation d'ordinateur, la Decisions API a réussi 76 étapes sur 78, rapporte AlphaSignal. Jev de TypeSafe, un service de décision concurrent, en a réussi 73. Pour le tri de fils de messages, les deux ont fait jeu égal en précision et Jev était plus rapide. Les deux échantillons étaient petits.
Une nouvelle catégorie déjà encombrée
OpenAI a d'abord présenté l'API en préversion limitée le 29 septembre, rapporte XenoSpectrum. Elle arrive dans un domaine très actif. Jev de TypeSafe a été lancé en septembre et revendique de 70 à 500 millisecondes par réponse. Cloudflare a suivi avec Clef, des modèles de décision à poids ouverts, et AWS a publié Strands Decider 2B.
XenoSpectrum estime que l'idée est moins nouvelle qu'il n'y paraît. Les Structured Outputs peuvent déjà forcer un modèle à choisir parmi des options fixes. Ce qui change, c'est une API distincte conçue pour de nombreux appels rapides et répétés.
Ce que cela signifie pour les développeurs
- Déplacez d'abord vos appels à choix fixe. Le routage, la détection de spam, les garde-fous et le choix d'outils correspondent aux trois types de réponse. Laissez l'écriture et le raisonnement à un modèle classique.
- Utilisez la probabilité comme barrière. Agissez selon les réponses à haute confiance et envoyez celles à faible confiance à un modèle plus grand ou à une personne.
- Faites votre propre test de latence. Le chiffre de 150 ms vient d'OpenAI, sans méthode publiée. Mesurez-le sur votre trafic réel avant de refondre quoi que ce soit autour.
- Budgétez uniquement sur l'entrée. À 0,10 dollar par million de tokens d'entrée sans frais de sortie, le coût dépend de la quantité d'éléments que vous envoyez. Raccourcissez les longs prompts et redimensionnez les images.
- Encodez d'abord les images. Les URL d'images hébergées sont refusées, convertissez-les donc en base64 avant l'appel.
- Traitez-la comme une bêta. Figez la version de votre SDK et gardez une solution de repli jusqu'à la disponibilité générale.
Commencez par rejouer dans l'API une journée de décisions enregistrées. Comparez ensuite ses réponses avec les choix de votre modèle actuel et vérifiez à quelle fréquence ils concordent.
Sources
- Decisions API guide - OpenAI
- OpenAI's Decisions API Promises Routing Answers 10x Faster for Developers - AlphaSignal
- OpenAI Decisions API preview on GPT-6 Luna - XenoSpectrum
Articles liés
L'Agents API d'OpenAI ajoute l'usage d'ordinateur dans un navigateur hébergé
L'Agents API d'OpenAI, en bêta publique depuis le 10 septembre, a gagné l'usage d'ordinateur au DevDay du 29 septembre 2026 : les agents pilotent un navigateur hébergé par OpenAI.

GPT-6 Astra est en disponibilité générale sur Bedrock et dans Copilot
GPT-6 Astra est en disponibilité générale sur Amazon Bedrock à 10 dollars par million de tokens d'entrée, et dans GitHub Copilot pour les forfaits Pro+, Max, Business et Enterprise.
Amazon Bedrock Managed Agents pour OpenAI entre en préversion
AWS a ouvert le 29 septembre 2026 une préversion publique de Bedrock Managed Agents : des agents sur modèles OpenAI qui tournent dans votre compte AWS, dans trois régions américaines.