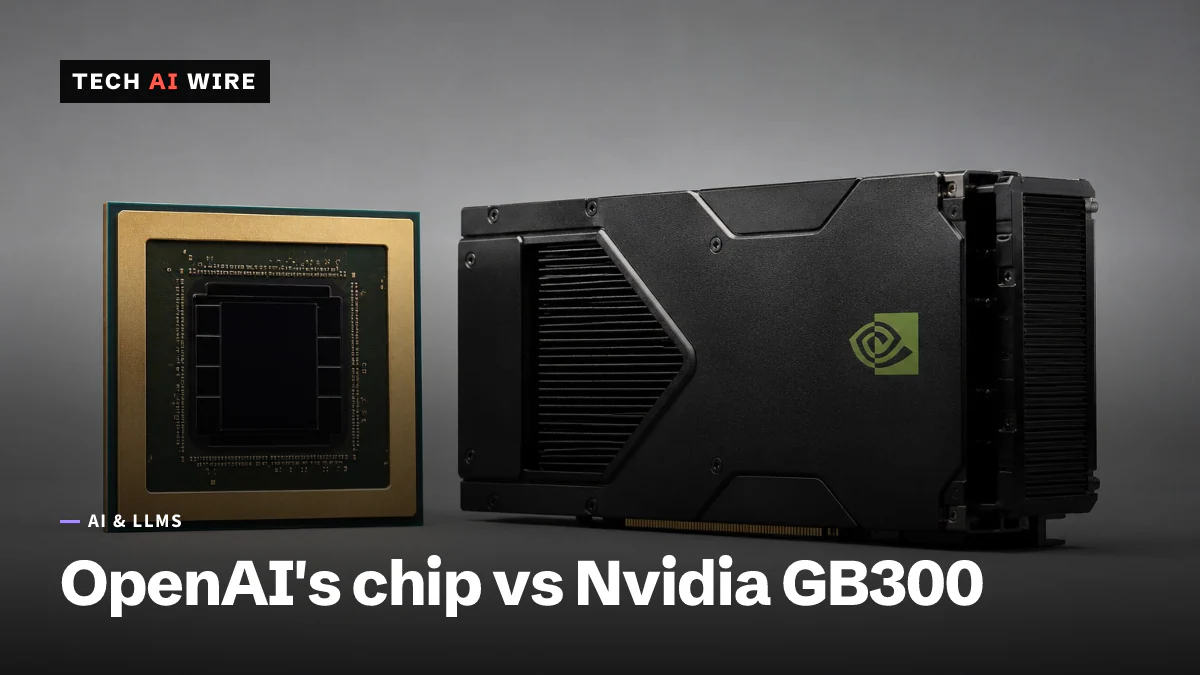
OpenAI affirme que sa puce Jalapeño bat la GB300 de Nvidia par watt
Les premiers benchmarks publiés par OpenAI pour Jalapeño revendiquent 1,5 à 1,9 fois plus de travail par kilowatt que la GB300 de Nvidia, pour moitié moins de puissance. Les chiffres sont ceux d'OpenAI.
4 min de lecture
En chiffres
- more throughput per kilowatt, per OpenAI
- 1.5-1.9x
- lower end-to-end latency at the top of the range
- 3.6x
- HBM4 memory on each chip
- 216 GB
- from first design to tape-out
- 9 months
- OpenAI Jalapeño
- 700W
- Nvidia GB300
- 1400W
OpenAI a publié les premiers benchmarks de Jalapeño, la puce d'inférence qu'elle a conçue avec Broadcom, et affirme qu'elle bat le fleuron de Nvidia. The Register et TechCrunch ont rapporté les chiffres le 25 août 2026. OpenAI revendique 1,5 à 1,9 fois plus de travail d'IA par kilowatt que les systèmes concurrents, et une latence 1,7 à 3,6 fois plus faible. La puce est donnée pour la moitié de la puissance de la GB300 de Nvidia. Si les chiffres tiennent en dehors des propres tests d'OpenAI, le coût de servir un modèle vient de gagner un second fournisseur.
L'inférence est le travail consistant à exécuter un modèle entraîné pour répondre aux requêtes, par opposition à son entraînement. C'est là que va l'essentiel de l'électricité d'un produit d'IA une fois qu'il a des utilisateurs. Une puce qui fait plus d'inférence par watt réduit la plus grosse ligne de la facture.
Les chiffres publiés par OpenAI
Tom's Hardware rapporte que Jalapeño est donnée pour 700 watts contre 1 400 watts pour la GB300 de Nvidia. Sur cette base, OpenAI revendique jusqu'à 1,9 fois le débit par kilowatt. The Register ajoute que pour les travaux à très faible latence, l'avantage monte à 2,1 à 4,1 fois. The Register estime aussi la consommation de la puce à 40 % à 60 % de celle des systèmes GPU concurrents.
Les spécifications d'une seule puce, selon The Register :
| Mesure | Jalapeño |
|---|---|
| Calcul en MXFP4 | 13,4 pétaFLOPS |
| Mémoire | 216 Go HBM4 |
| Bande passante mémoire | 15,4 To/s |
| Puissance nominale | 700 W |
MXFP4 est un format de nombres sur 4 bits, qui compacte les poids pour qu'une plus grande part du modèle tienne dans la mémoire rapide. HBM4 est de la mémoire à haute bande passante, la mémoire empilée qui se trouve à côté de la puce. Un rack complet de 128 puces atteint 1,7 exaFLOPS de calcul 4 bits, 27,5 To de mémoire, et près de 2 pétaoctets par seconde de bande passante.
Comment elle obtient cette vitesse
Le pari de conception est de déplacer moins les données. Richard Ho, responsable du matériel chez OpenAI, a déclaré à TechCrunch : « Nous avons conçu Jalapeño pour minimiser les déplacements de données et les délais de communication. » The Register rapporte un grand cache SRAM sur la puce et un placement soigné du KV cache, la réserve de tokens passés qu'un modèle consulte à chaque étape.
Cela compte parce que l'inférence a deux phases. Le prefill lit tout le prompt d'un coup, et le décodage produit la réponse un token à la fois. Le décodage est la partie lente, et il est limité par la vitesse à laquelle la puce peut aller chercher ce qu'elle sait déjà. Garder ces données à proximité est ce que reflètent les chiffres de latence.
La puce a aussi été conçue exceptionnellement vite. The Register rapporte 9 mois entre la première conception et le tape-out, le moment où un design est gelé pour la fabrication. The Register la décrit comme « conçue (en partie) par l'IA, pour l'IA ». TechCrunch confirme que les propres modèles d'OpenAI ont aidé à la conception.
Quand vous pourriez vraiment l'utiliser
Pas bientôt. TechCrunch rapporte qu'OpenAI prévoit de déployer Jalapeño en « très petits volumes » fin 2026, avec un déploiement plus large en 2027. Le projet a été annoncé pour la première fois en octobre 2025, et TechCrunch le décrit comme une plateforme multigénérationnelle, il s'agit donc de la première puce d'une lignée.
Ho a été direct sur ce que signifient, selon lui, les résultats. « En résumé, les résultats montrent une avancée de performance très, très significative par rapport à l'état de l'art », a-t-il déclaré à TechCrunch. Il a ajouté que Jalapeño « peut servir plus de travail d'IA par unité de puissance, tout en renvoyant les réponses plus rapidement ».
Ce que cela signifie pour les développeurs
Lisez chaque chiffre avec un fait sous les yeux : les nombres viennent d'OpenAI. Aucun laboratoire indépendant ne les a encore reproduits, et la comparaison se fait avec la puissance nominale publiée par Nvidia. Le premier benchmark d'un fournisseur sur sa propre puce est une affirmation, pas une mesure. Traitez-le comme une raison de surveiller, pas comme une raison de tout replanifier.
Si vous faites de l'inférence à grande échelle, la métrique à emprunter est le travail par kilowatt. La plupart des équipes budgétisent encore en nombre de GPU. La puissance est la contrainte qui plafonne réellement un centre de données, et c'est l'axe qu'OpenAI a choisi pour se battre. Commencez dès maintenant à suivre les tokens par kilowattheure pour votre propre charge de travail, afin de pouvoir évaluer n'importe quelle puce, y compris celle-ci, quand elle sortira.
Vous n'achèterez pas de Jalapeño. Les articles décrivent une puce conçue pour la propre flotte d'OpenAI, en petits volumes d'abord. Elle vous atteindra par les prix et la latence de l'API d'OpenAI, en 2027 au plus tôt. Si votre produit dépend d'un décodage rapide, surveillez l'an prochain les chiffres de latence par token d'OpenAI pour le premier vrai signal.
Le tape-out en neuf mois est la partie à retenir. Un laboratoire de pointe a conçu une puce d'inférence compétitive en moins d'un an, avec l'aide de ses propres modèles. Si cela se confirme, le silicium sur mesure cesse d'être un pari à cinq ans que seules les plus grandes entreprises peuvent faire. La position défendable pour Nvidia devient le logiciel et l'approvisionnement, pas l'efficacité brute.
Sources
Articles liés
La puce d'inférence Groq 3 LPX de Nvidia entre en production
Nvidia met son accélérateur d'inférence dédié en pleine production : les GPU traitent le contexte, les nouvelles puces s'occupent de la génération de jetons.
Fujitsu MONAKA livre 144 cœurs Armv9 en novembre
Le MONAKA 144 cœurs de Fujitsu sera en vente en novembre, avec des cœurs en 2nm empilés sur un cache en 5nm et un support déjà présent dans GCC 15.
L'Agents API d'OpenAI ajoute l'usage d'ordinateur dans un navigateur hébergé
L'Agents API d'OpenAI, en bêta publique depuis le 10 septembre, a gagné l'usage d'ordinateur au DevDay du 29 septembre 2026 : les agents pilotent un navigateur hébergé par OpenAI.