Z.ai lanza GLM-Legal, un modelo de IA para el trabajo jurídico
GLM-Legal de Z.ai, basado en GLM-5.3-Flash, obtiene un 19,2 % en Harvey's Legal Agent Benchmark, frente al 6,7 % de su modelo base. El acceso es una beta de API con solicitud previa.
4 min de lectura
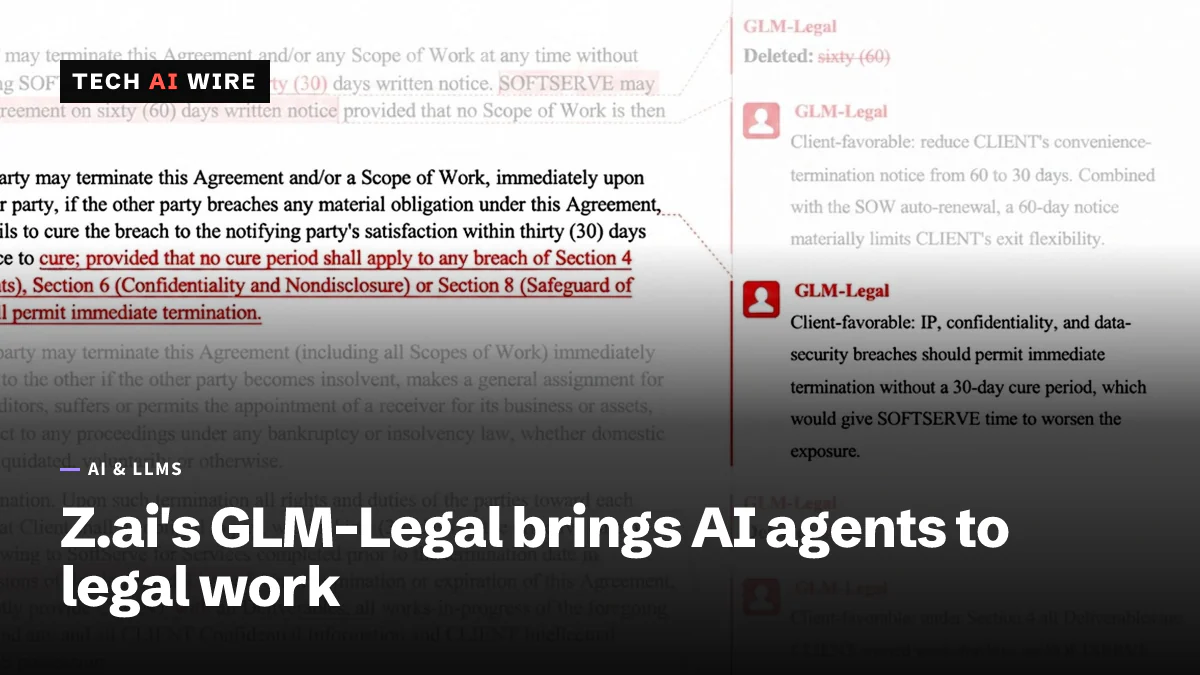
Z.ai, la empresa detrás de la familia de modelos de IA GLM, anunció GLM-Legal el 12 de octubre de 2026. Es una versión de su modelo GLM-5.3-Flash entrenada para el trabajo jurídico, como la revisión de contratos, el análisis de pruebas y la investigación de cumplimiento normativo. Según Z.ai, obtiene un 19,2 % en Harvey's Legal Agent Benchmark, frente al 6,7 % del modelo base. Por ahora, el acceso se limita a una beta para la que las empresas deben presentar una solicitud.
Qué es GLM-Legal
El anuncio de Z.ai dice que GLM-Legal está «construido sobre la base ligera de GLM-5.3-Flash». Z.ai lanzó GLM-5.3-Flash con pesos abiertos en agosto. AlphaSignal describe el modelo base como un diseño de mezcla de expertos (mixture-of-experts), que usa solo una parte del modelo para cada palabra que procesa. Tiene 320 mil millones de parámetros en total, 18 mil millones activos a la vez, y una ventana de contexto anunciada de 1 millón de tokens.
La página de Z.ai no da ningún tamaño para el propio GLM-Legal. Solo dice que el modelo funciona con una «huella de parámetros significativamente más reducida» que los modelos cerrados de frontera.
El entrenamiento se hizo en dos etapas. Primero, Z.ai siguió entrenando el modelo con un conjunto más amplio de textos jurídicos. Después usó aprendizaje por refuerzo, que recompensa a un modelo por buenos resultados, en «decenas de miles de entornos jurídicos realistas». Z.ai construyó el modelo junto con su «Harness», el software que ejecuta el agente y sus herramientas. «La arquitectura del Harness y el entrenamiento del modelo iteran a la par», dice la publicación. Unite.AI añade que una de las etapas convierte los comentarios de profesionales del derecho en señales de entrenamiento.
Z.ai explica por qué eligió el derecho: «El trabajo jurídico concentra estos desafíos, lo que lo convierte en una prueba de estrés ideal para entrenar modelos que operen en entornos profesionales de alto riesgo».
Resultados de GLM-Legal en benchmarks
Z.ai publicó un gráfico que compara GLM-Legal con su modelo base y con tres modelos rivales. Todas las cifras de abajo proceden de ese gráfico.
| Benchmark | GLM-Legal | GLM-5.3-Flash | Kimi K3 | Claude Fable 5 | GPT-6 Astra |
|---|---|---|---|---|---|
| Harvey's Legal Agent Benchmark | 19.2 | 6.7 | 12.9 | 11.3 | 5.4 |
| LegalBench | 86.2 | 83.9 | 86.2 | 88.6 | 87.1 |
| PLawBench | 77.3 | 73.8 | 76.2 | 77.7 | 69.1 |
Según AlphaSignal, el benchmark de Harvey evalúa flujos de trabajo jurídicos de varios pasos que requieren planificación y uso de herramientas. Z.ai dice que abarca 24 áreas de práctica. Su puntuación es una tasa de aprobación total: una tarea solo cuenta si la respuesta cumple todos los criterios de evaluación. LegalBench evalúa tareas aisladas de razonamiento jurídico. PLawBench, según Z.ai, abarca la práctica jurídica china: consultas, análisis de casos y redacción de documentos.
GLM-Legal encabeza el gráfico en el benchmark de Harvey. En LegalBench empata con Kimi K3 y queda por detrás de Claude Fable 5 y GPT-6 Astra. En PLawBench queda 0,4 puntos por detrás de Claude Fable 5. Z.ai describe estos resultados como «a la altura de los modelos cerrados de frontera».
Las cifras del modelo base coinciden con pruebas externas. AlphaSignal publicó puntuaciones de Vals AI, una empresa de evaluación, para GLM-5.3-Flash: 83,93 % en LegalBench y 6,7 % en el benchmark de Harvey.
Cómo obtener acceso
GLM-Legal está en beta. El acceso a la API requiere un formulario de solicitud en el sitio de Z.ai. Z.ai invita a bufetes de abogados, empresas de tecnología jurídica, equipos jurídicos internos y profesionales independientes. Z.ai y Unite.AI dicen que el modelo llegará «pronto» a AutoClaw, la aplicación de agente de escritorio de Z.ai. Según AlphaSignal, los nuevos usuarios de AutoClaw reciben 200 millones de tokens promocionales, que Z.ai valora en $24.
Hay varios datos que no se han revelado. Entre ellos están el precio, la licencia de GLM-Legal, si se publicarán sus pesos, las regiones, los límites de uso y la retención de datos. El modelo base usa la licencia MIT, según AlphaSignal.
Qué muestran las demos
La publicación de Z.ai presenta tres demos que comparan GLM-Legal con su modelo base:
- Revisión de contratos: el modelo revisa las cláusulas de rescisión y traspaso de un contrato de servicios de software. AutoClaw escribe los cambios en Word «con control de cambios y comentarios».
- Análisis de pruebas: encuentra contradicciones en los informes de avance de un proveedor a lo largo de 40 documentos de una disputa. Cada hallazgo cita el número Bates del documento, el identificador que los abogados estampan en los archivos compartidos en un pleito.
- Investigación de cumplimiento: redacta un plan de privacidad para un sitio web que se lanza en Singapur, Malasia e Indonesia, citando secciones de la ley de protección de datos de cada país.
Qué significa para los desarrolladores
- Trate las puntuaciones como afirmaciones del proveedor. Z.ai eligió los benchmarks y realizó la comparación. Pruebe GLM-Legal con sus propios documentos antes de construir sobre él.
- Planifique una revisión humana. Una tasa de aprobación total del 19,2 % significa que cerca de cuatro de cada cinco tareas de varios pasos fallaron al menos una comprobación. Las herramientas jurídicas basadas en él siguen necesitando a un abogado en el proceso.
- Pregunte por los datos antes de enviar archivos de clientes. La retención y las regiones no están publicadas. Obtenga ambas cosas por escrito durante la beta.
- Compruebe la jurisdicción. PLawBench abarca la práctica china y las demos abarcan el Sudeste Asiático. Puede que los resultados no se trasladen al derecho bajo el que trabajan sus usuarios.
- El autoalojamiento empieza por el modelo base. GLM-5.3-Flash tiene pesos abiertos bajo MIT. Por ahora, GLM-Legal solo se ofrece mediante una API de acceso restringido, así que los equipos que deben ejecutar los modelos internamente aún no pueden usarlo.
Fuentes
Artículos relacionados
Claude Haiku 5.5 rebaja los precios un 90 % frente a Haiku 4.5
Claude Haiku 5.5 cuesta 0,10 dólares por millón de tokens de entrada y 0,50 de salida, un 90 % menos que Haiku 4.5, y logra un 39,2 % en Terminal-Bench 4.0 frente a un 0 %.
Microsoft ThinkingBox evalúa a los agentes de IA por la base de datos
ThinkingBox, de Microsoft, comprueba lo que un agente de IA escribió en la base de datos. El 67,24 % de 79.853 ejecuciones fallidas terminó limpiamente, con llamadas a herramientas válidas y datos erróneos.
Claude Sonnet 5.5 se acerca a Opus 5.5 a mitad de precio
Claude Sonnet 5.5 logra un 70,6 % en Terminal-Bench 4.0 a 2/10 dólares por millón de tokens, la mitad del precio de Opus 5.5. Sonnet 4.5 se retira el 30 de noviembre de 2026.