OpenAI dice que su chip Jalapeño supera al GB300 de Nvidia por vatio
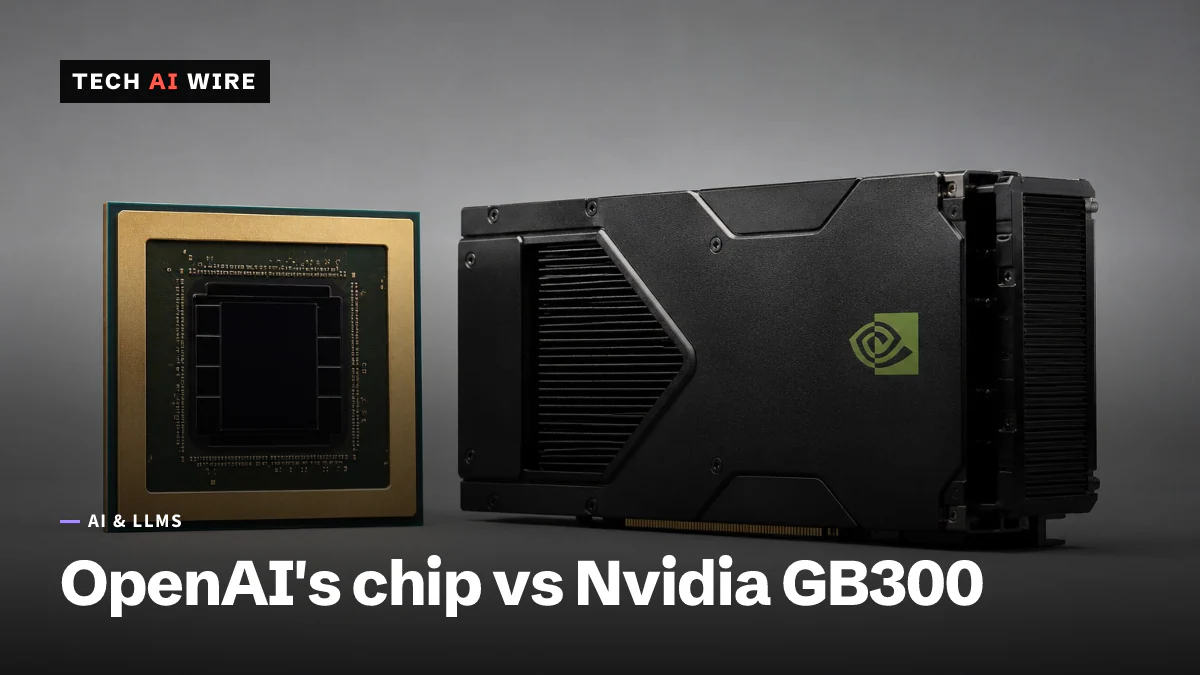
Los primeros benchmarks de Jalapeño publicados por OpenAI afirman entre 1,5 y 1,9 veces más trabajo por kilovatio que el GB300 de Nvidia, con la mitad de potencia. Las cifras son de la propia OpenAI.
4 min de lectura
En cifras
- more throughput per kilowatt, per OpenAI
- 1.5-1.9x
- lower end-to-end latency at the top of the range
- 3.6x
- HBM4 memory on each chip
- 216 GB
- from first design to tape-out
- 9 months
- OpenAI Jalapeño
- 700W
- Nvidia GB300
- 1400W
OpenAI ha publicado los primeros benchmarks de Jalapeño, el chip de inferencia que construyó con Broadcom, y dice que supera al buque insignia de Nvidia. The Register y TechCrunch informaron de las cifras el 25 de agosto de 2026. OpenAI afirma entre 1,5 y 1,9 veces más trabajo de IA por kilovatio que los sistemas competidores, y entre 1,7 y 3,6 veces menos latencia. El chip tiene una potencia nominal que es la mitad de la del GB300 de Nvidia. Si las cifras se sostienen fuera de las propias pruebas de OpenAI, el coste de servir un modelo acaba de ganar un segundo proveedor.
La inferencia es el trabajo de ejecutar un modelo ya entrenado para responder peticiones, a diferencia de entrenarlo. Es a donde va la mayor parte de la electricidad de un producto de IA una vez que el producto tiene usuarios. Un chip que hace más inferencia por vatio recorta la línea más grande de la factura.
Las cifras que publicó OpenAI
Tom's Hardware informa de que Jalapeño tiene una potencia nominal de 700 vatios frente a los 1.400 vatios del GB300 de Nvidia. Sobre esa base, OpenAI afirma hasta 1,9 veces el rendimiento por kilovatio. The Register añade que para trabajo de latencia ultrabaja la ventaja sube a entre 2,1 y 4,1 veces. También estima el consumo del chip en entre el 40 % y el 60 % de los sistemas GPU competidores.
Las especificaciones de un solo chip, según The Register:
| Medida | Jalapeño |
|---|---|
| Cómputo en MXFP4 | 13,4 petaFLOPS |
| Memoria | 216 GB HBM4 |
| Ancho de banda de memoria | 15,4 TB/s |
| Potencia nominal | 700 W |
MXFP4 es un formato numérico de 4 bits, que empaqueta los pesos de forma compacta para que quepa más modelo en la memoria rápida. HBM4 es memoria de alto ancho de banda, la memoria apilada que se sitúa junto al chip. Un rack completo de 128 chips alcanza 1,7 exaFLOPS de cómputo de 4 bits, 27,5 TB de memoria y casi 2 petabytes por segundo de ancho de banda.
Cómo consigue la velocidad
La apuesta del diseño es mover menos los datos. Richard Ho, responsable de hardware de OpenAI, dijo a TechCrunch: «Diseñamos Jalapeño para minimizar el movimiento de datos y los retrasos de comunicación». The Register informa de una gran caché SRAM en el propio chip y de una colocación cuidadosa de la KV cache. Esa caché es el almacén de tokens pasados que un modelo consulta en cada paso.
Eso importa porque la inferencia tiene dos fases. El prefill lee todo el prompt de una vez, y el decode produce la respuesta token a token. El decode es la parte lenta, y está limitado por lo rápido que el chip puede recuperar lo que ya sabe. Mantener esos datos cerca es lo que reflejan las cifras de latencia.
El chip también se construyó inusualmente rápido. The Register informa de 9 meses desde el primer diseño hasta el tape-out, el punto en que un diseño se congela para fabricarlo. Lo describe como «diseñado (en parte) por IA, para IA». TechCrunch confirma que los propios modelos de OpenAI ayudaron en el diseño.
Cuándo podrías usarlo de verdad
No pronto. TechCrunch informa de que OpenAI espera desplegar Jalapeño en «volúmenes muy pequeños» a finales de 2026, con un despliegue más amplio en 2027. El proyecto se anunció por primera vez en octubre de 2025, y TechCrunch lo describe como una plataforma multigeneracional, así que este es el primer chip de una línea.
Ho fue directo sobre lo que cree que significan los resultados. «La conclusión es que los resultados muestran un avance de rendimiento muy, muy significativo sobre el estado del arte», dijo a TechCrunch. Añadió que Jalapeño «puede servir más trabajo de IA por unidad de potencia, y además devolver respuestas más rápido».
Qué significa esto para los desarrolladores
Lee cada cifra con un hecho delante: los números vienen de OpenAI. Ningún laboratorio independiente los ha reproducido todavía, y la comparación es contra la potencia nominal publicada por Nvidia. El primer benchmark de un fabricante sobre su propio chip es una afirmación, no una medición. Trátalo como una razón para vigilar, no como una razón para replanificar.
Si ejecutas inferencia a escala, la métrica que conviene robar es el trabajo por kilovatio. La mayoría de los equipos todavía presupuesta por número de GPU. La potencia es la restricción que de verdad limita un centro de datos, y es el eje en el que OpenAI eligió pelear. Empieza ahora a seguir los tokens por kilovatio-hora de tu propia carga de trabajo, para poder evaluar cualquier chip, incluido este, cuando salga.
No vas a comprar un Jalapeño. Los informes describen un chip construido para la propia flota de OpenAI, en volúmenes pequeños al principio. La forma en que te llega es a través de los precios y la latencia de la API de OpenAI, en 2027 como muy pronto. Si tu producto depende de un decode rápido, vigila el año que viene las cifras de latencia por token de OpenAI para la primera señal real.
El tape-out en nueve meses es la parte que conviene recordar. Un laboratorio de frontera diseñó un chip de inferencia competitivo en menos de un año, con la ayuda de sus propios modelos. Si eso se sostiene, el silicio a medida deja de ser una apuesta a cinco años que solo pueden hacer las empresas más grandes. La posición defendible para Nvidia pasa a ser el software y el suministro, no la eficiencia bruta.
Fuentes
Artículos relacionados
El chip de inferencia Groq 3 LPX de Nvidia entra en producción
Nvidia pone su acelerador de inferencia dedicado en plena producción: las GPU se ocupan del contexto y los chips nuevos, de generar los tokens.
Fujitsu MONAKA llega con 144 núcleos Armv9 en noviembre
El MONAKA de 144 núcleos de Fujitsu sale a la venta en noviembre, con núcleos de 2nm apilados sobre caché de 5nm y soporte ya presente en GCC 15.
La Agents API de OpenAI añade uso del ordenador en un navegador alojado
La Agents API de OpenAI, en beta pública desde el 10 de septiembre, sumó uso del ordenador en el DevDay del 29 de septiembre de 2026: los agentes manejan un navegador alojado por OpenAI.