Jev, de TypeSafe, devuelve decisiones tipadas, no texto
Jev responde en 70 a 500 milisegundos y cuesta 0,042 dólares por millón de tokens de entrada, con salida gratis. No sabe generar texto en absoluto.
3 min de lectura

En cifras
- end-to-end latency TypeSafe reports
- 70-500 ms
- per million input tokens, with output free
- $0.042
- type-error rate the company reports
- 0%
TypeSafe AI presentó el 15 de septiembre de 2026 un modelo que no puede escribir una frase. Jev toma como entrada el estado desordenado de un programa en ejecución y devuelve un valor estructurado y tipado. El anuncio de la empresa dice que produce ese valor completo en una sola pasada, y no token a token. TypeSafe lo llama un modelo System One, una clase que según dice está hecha para la automatización y no para la conversación.
El intercambio es explícito. Jev renuncia por completo a generar texto y, a cambio, la empresa promete una latencia de 70 a 500 milisegundos y un precio de entrada de 0,042 dólares por millón de tokens, con la salida gratis.
Qué hace distinto un modelo System One
Un modelo de lenguaje normal escribe de izquierda a derecha, eligiendo un token cada vez, y una respuesta estructurada es algo que hay que sacarle a ese flujo. TypeSafe lo invierte. A Jev se le da la estructura por adelantado y la rellena de golpe.
Las salidas llevan probabilidades calibradas. Es decir, cada decisión viene con un número de confianza pensado para coincidir con la frecuencia real de acierto. TypeSafe dice que entrenó el modelo con un método que llama Reinforcement Learning for Calibrated Decisions, y no con el enfoque RLHF de los modelos de conversación. El objetivo declarado son números de confianza que sigan la precisión real.
Artificial Intelligence News informa de un mecanismo concreto detrás del tamaño de esas elecciones. En selecciones con muchas opciones, hasta 255, Jev puntúa a los candidatos en dos etapas independientes antes de elegir.
El fundador es Diogo Almeida, que trabajó en la investigación de ChatGPT en OpenAI. Tanto la empresa como Gigazine dicen que TypeSafe pasó dos años en modo sigiloso antes de este lanzamiento.
Las cifras, y quién las produjo
Todas las cifras de abajo vienen de TypeSafe o de coberturas que recogen sus afirmaciones. Todavía no existe ninguna medición independiente.
| Afirmación | Cifra |
|---|---|
| Latencia | 70 a 500 milisegundos de extremo a extremo |
| Velocidad frente a modelos de frontera | 40 a 200 veces según TypeSafe; Gigazine indica 20 a 200 veces |
| En flujos de varios pasos | 193,6 veces más rápido y 444,6 veces más barato |
| Precio de entrada | 0,042 dólares por millón de tokens, frente a 0,20 a 10 dólares de los modelos de conversación |
| Errores de tipo | 0% |
| Demostración | Un bot de DOOM a unas 10 consultas por segundo, a 7 dólares la hora |
La cifra de DOOM es la más útil, porque es un ritmo y no una proporción. Diez decisiones por segundo a siete dólares la hora es un número que puedes comparar con tu propia carga.
La afirmación principal exige cuidado. TypeSafe dice que la alucinación es matemáticamente imposible, y el mecanismo que describe es la seguridad de tipos: la salida debe ajustarse a la estructura que definiste. Eso garantiza la forma de una respuesta, no su verdad. Una decisión puede estar perfectamente tipada, pasar la validación y seguir siendo errónea. Para eso está, justamente, el número de confianza.
Qué significa esto para los desarrolladores
La forma honesta de evaluarlo es como sustituto de una llamada concreta, no de tu modelo. Imagina un paso de una tubería que pide a un LLM elegir una de un conjunto fijo de opciones y devolver JSON. Esa es la forma para la que está hecho Jev. Clasificación, enrutado, ordenación y elección de herramienta encajan. Cualquier cosa que deba producir prosa no encaja, porque el modelo no puede.
Calcula la comparación con tu propio tráfico antes de creer los multiplicadores. Los tokens de salida gratis cambian la cuenta sobre todo cuando la respuesta es pequeña y la entrada grande, que es exactamente la forma de una llamada de decisión. Una carga de resumen no obtendría ninguna ventaja.
Trata las pruebas del proveedor como este sitio trató las cifras de CRM Bench de Salesforce: como una afirmación que hay que reproducir, no como una medición sobre la que planificar. La cifra de 193,6 veces es lo bastante concreta para ser comprobable, así que pruébala en una decisión real de tu pila.
Dos límites prácticos antes de planificar nada. El acceso es temprano, por lista de espera, con documentación en docs.typesafe.ai, así que no es algo que puedas poner en producción esta semana. Y la promesa de calibración es la parte que conviene verificar tú mismo: registra los números de confianza junto a los resultados durante una semana y comprueba si un 0,7 significa de verdad el setenta por ciento.
Fuentes
- Introducing System One Models & Jev - TypeSafe AI
- ChatGPT pioneer launches Jev model for programmatic logic - Artificial Intelligence News
- ChatGPT co-developers have created 'Jev', an AI model that processes tasks using a different method than LLM - Gigazine
Artículos relacionados
DeepSeek avisa a los desarrolladores de una subida significativa del precio de su API
DeepSeek avisó a los desarrolladores el 6 de agosto de que los precios de su API subirán 'significativamente' pronto, sin cifras ni fechas, mientras V4-Flash es el modelo conocido más barato de ejecutar.

GPT-6 Astra ya está disponible de forma general en Bedrock y Copilot
GPT-6 Astra está disponible de forma general en Amazon Bedrock a 10 dólares por millón de tokens de entrada, y en GitHub Copilot para los planes Pro+, Max, Business y Enterprise.
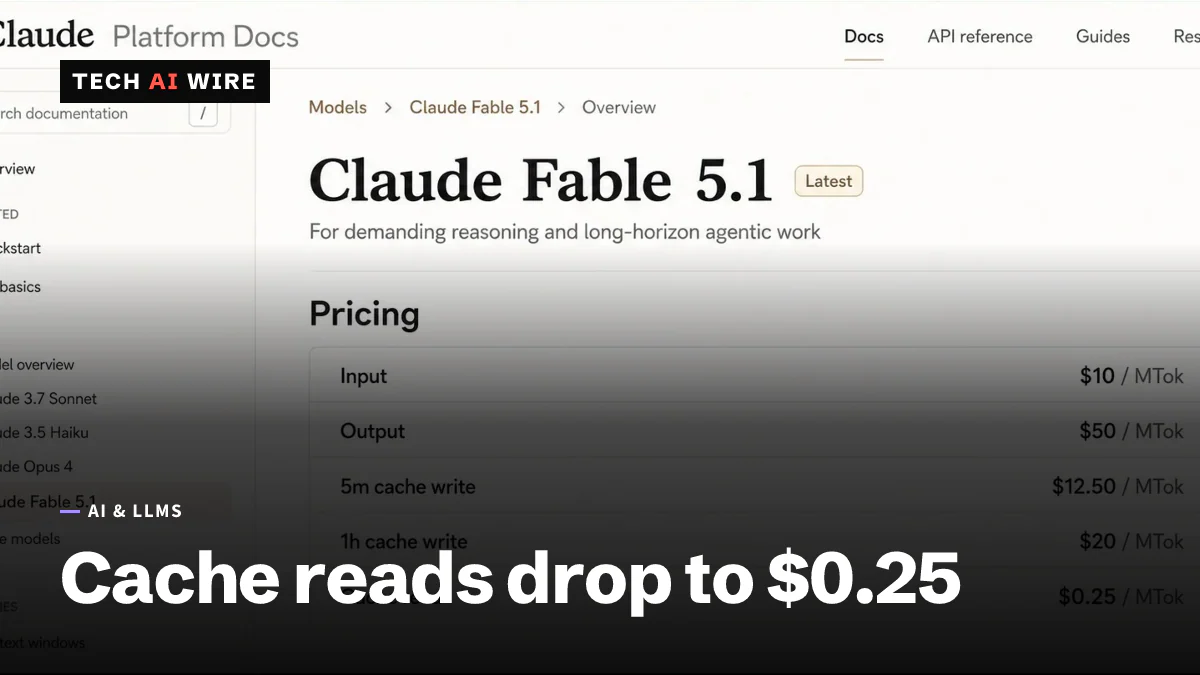
Claude Fable 5.1 recorta un 75% el coste de leer de caché
Fable 5.1 mantiene la entrada y la salida en 10 y 50 dólares por millón de tokens, y baja la lectura de caché de 1,00 a 0,25 dólares. Mythos 5.1 sigue siendo por invitación.