Intel LLM-Scaler-vLLM 1.5 springt auf Arc-GPUs zu vLLM 0.26
Intels LLM-Scaler-vLLM 1.5 hebt den Docker-Stack für Arc-GPUs von vLLM 0.14 auf 0.26 und ergänzt Gemma-4- und Qwen3.8-Modelle sowie Optionen für FP8 und INT4.
3 Min. Lesezeit
Die Zahlen
- vLLM version inside the Docker image
- 0.14 → 0.26
- current upstream vLLM release, per Phoronix
- 0.31
- newly supported Qwen and Gemma 4 models
- 5
- PyTorch version, up from 2.10
- 2.12
Intel hat am 16. Oktober 2026 Version 1.5 von LLM-Scaler-vLLM veröffentlicht. Es ist ein fertiges Docker-Image, mit dem große Sprachmodelle auf Intels Arc-Grafikkarten laufen. Das Update hebt den Kern von vLLM 0.14 auf vLLM 0.26 und ergänzt neuere Qwen- und Gemma-4-Modelle. Wer Modelle auf Intel-GPUs bereitstellt, schließt damit einen Großteil der Lücke zu dem Code, den Nvidia-Nutzer bereits verwenden.
vLLM ist eine beliebte Open-Source-Engine, um Sprachmodelle bereitzustellen. Sie nimmt Anfragen an, bündelt sie und liefert schnell Antworten. Intels Image enthält eine gepatchte Version davon und alles andere, was für den Betrieb auf Arc-Hardware nötig ist.
Was sich in Version 1.5 geändert hat
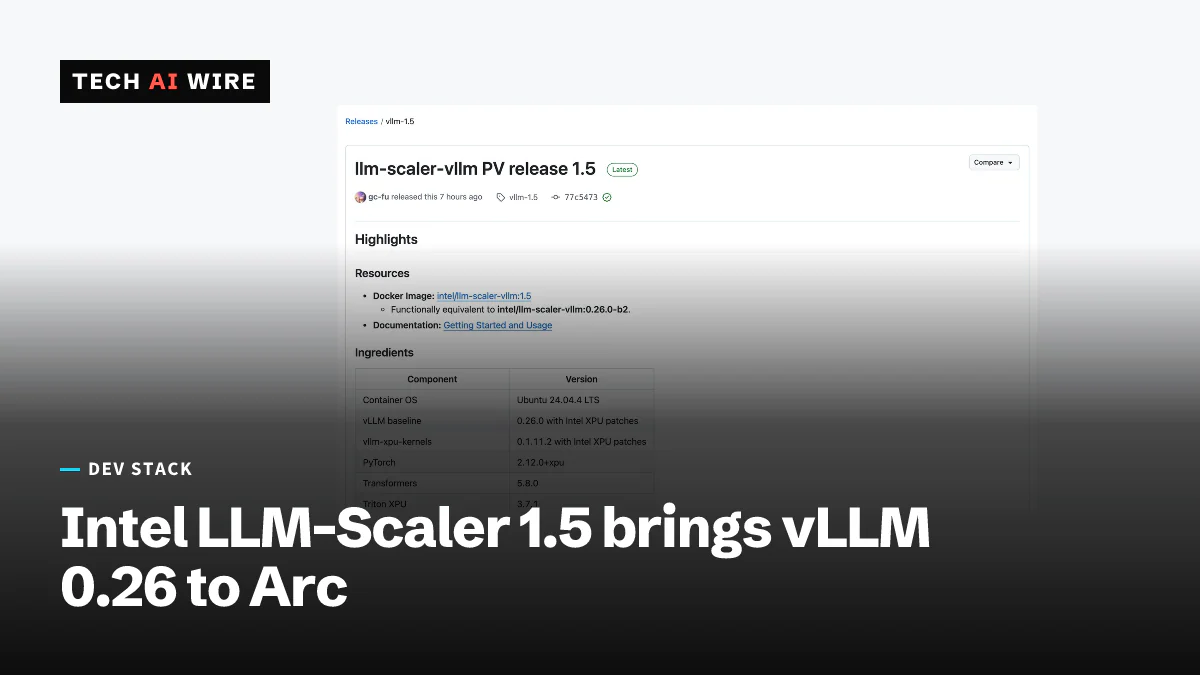
Das Release bringt fast jede Schicht des Stacks voran, laut Intels Release Notes auf GitHub. Das Image läuft auf Ubuntu 24.04.4 LTS.
| Komponente | Vorher | In 1.5 |
|---|---|---|
| vLLM | 0.14.0 | 0.26.0, mit Intel-XPU-Patches |
| PyTorch | 2.10 | 2.12.0+xpu |
| Transformers | nicht aufgeführt | 5.8.0 |
| Triton XPU | nicht aufgeführt | 3.7.1 |
| vllm-xpu-kernels | nicht aufgeführt | 0.1.11.2 |
Der Sprung ist groß, doch das Image liegt weiter hinter dem Hauptprojekt zurück. Upstream steht vLLM bei 0.31, schreibt Phoronix. Intel entwickelt den Stack im Rahmen von Project Battlematrix, seinem Vorhaben, Arc-Karten zu KI-Workstations zu machen. Phoronix beschreibt das Release als Vorarbeit für Intels kommende Rechenzentrums-GPU Crescent Island.
Das neue Docker-Image ist intel/llm-scaler-vllm:1.5. Laut Intel ist es funktional identisch mit der Beta 0.26.0-b2, die das Unternehmen am 9. September veröffentlicht hat.
Neue Modelle und Formate
Version 1.5 unterstützt fünf neue Modelle:
- Qwen3.6-27B
- Qwen3.8-27B
- Qwen3.6-35B-A3B
- gemma-4-26B-A4B-it
- gemma-4-31B-it
Außerdem kommen neue Wege hinzu, Modelle zu verkleinern. Quantisierung speichert die Zahlen eines Modells mit geringerer Genauigkeit, damit es in weniger Speicher passt. Das Release unterstützt Online-Quantisierung in FP8 und symmetrischem INT4 sowie Checkpoints, die bereits in Block-FP8 gespeichert sind. Auch den KV-Cache kann es in FP8 halten, also den Speicher, in dem ein Modell das bisherige Gespräch ablegt.
Weitere Neuerungen sind LoRA-Serving und MTP. LoRA-Adapter sind kleine Zusatzgewichte, die ein Modell für eine Aufgabe anpassen. MTP, kurz für Multi-Token-Prediction, lässt ein Modell mehrere Tokens auf einmal vorschlagen. Intel nennt außerdem Unterstützung für DFlash, auch für Muse-Glimmer-30B.
Intel meldet eine kürzere Time to First Token für Qwen- und Gemma-4-Modelle. Das ist die Zeit, die ein Nutzer wartet, bevor die Antwort beginnt. Außerdem nennt Intel Beschleunigungen beim MTP-Decoding, beim LoRA-Serving und beim FP8-KV-Cache.
Behobene Fehler und bekannte Probleme
Das Release behebt drei Fehler, die falsche Ergebnisse lieferten:
- Prefix Caching funktionierte mit MTP nicht korrekt. Prefix Caching verwendet Arbeit wieder, wenn viele Prompts gleich beginnen.
- Auf symmetrisches INT4 quantisierte Modelle konnten falsche Ausgaben liefern.
- Block-FP8-Modelle konnten ihre Ausgabe beschädigen, wenn sie mehrere Anfragen gleichzeitig decodierten.
Intel nennt zwei bekannte Probleme. „Die XPU-Graph-Unterstützung ist experimentell“, heißt es in den Release Notes. Die multimodale Nutzung von Muse-Glimmer braucht zudem Transformers 5.15.0, während das Image 5.8.0 mitbringt.
Was das für Entwickler bedeutet
Wenn Sie Modelle auf Arc-Karten mit einem älteren LLM-Scaler-Image bereitstellen, aktualisieren Sie. Schon die Korrekturen für INT4 und Block-FP8 zählen, denn beide Fehler lieferten falsche Antworten, ohne abzustürzen.
Prüfen Sie Ihre Starteinstellungen gegen das neuere vLLM. Zwischen 0.14 und 0.26 liegen zwölf Minor-Versionen, und Flags oder Standardwerte können sich dazwischen geändert haben. Testen Sie auf einem Staging-System, bevor Sie das Produktions-Image austauschen.
Wenn Sie Muse-Glimmer mit Bildern nutzen wollen, warten Sie oder bauen Sie ein eigenes Image. Die mitgelieferte Transformers-Version ist dafür laut Intels eigenen Release Notes zu alt. Lassen Sie den XPU-Graph-Modus in der Produktion ausgeschaltet, solange Intel ihn experimentell nennt.
Das größere Signal ist das Tempo. Intel liefert jetzt ein vLLM, das nur fünf Versionen hinter Upstream liegt. Das macht Arc zu einer realistischeren Option, um Modelle lokal und on-premises bereitzustellen.
Quellen
- Intel LLM-Scaler-vLLM PV 1.5 Brings Big Improvements - Phoronix
- llm-scaler releases - GitHub (Intel)
Ähnliche Artikel
Qwen3.5-9B braucht 32KB pro Token für den KV-Cache
Qwen3.5-9B nutzt volle Attention in nur 8 seiner 32 Schichten, daher kostet sein KV-Cache 32KB pro Token. Dieses Verhältnis entscheidet, ob er in 8GB passt.
AMD GAIA 0.25 fasst seine lokalen KI-Agenten zu einem zusammen
AMDs Open-Source-App für lokale Agenten führt nur noch einen Agenten aus, verkleinert ihr Windows-Python-Setup von 0,9 GB auf 0,1 GB und stürzt auf 16-GB-Laptops nicht mehr ab.
Strands Decider 2B trifft Agenten-Entscheidungen in 115 ms
Strands Decider 2B von AWS ist ein Open-Source-Modell, das aus einer Liste auswählt, statt Text zu schreiben. Auf einer RTX 3090 antwortet es in 115 ms und erreicht 72,3 % bei JevBench.