Intel LLM-Scaler-vLLM 1.5 passe à vLLM 0.26 sur les GPU Arc
LLM-Scaler-vLLM 1.5 d'Intel fait passer sa pile Docker pour GPU Arc de vLLM 0.14 à 0.26 et ajoute les modèles Gemma 4 et Qwen3.8, ainsi que des options FP8 et INT4.
3 min de lecture
En chiffres
- vLLM version inside the Docker image
- 0.14 → 0.26
- current upstream vLLM release, per Phoronix
- 0.31
- newly supported Qwen and Gemma 4 models
- 5
- PyTorch version, up from 2.10
- 2.12
Intel a publié la version 1.5 de LLM-Scaler-vLLM le 16 octobre 2026. Il s'agit d'une image Docker prête à l'emploi pour exécuter de grands modèles de langage sur les cartes graphiques Arc d'Intel. La mise à jour fait passer son moteur central de vLLM 0.14 à vLLM 0.26 et ajoute des modèles Qwen et Gemma 4 plus récents. Pour qui sert des modèles sur des GPU Intel, elle comble une grande partie de l'écart avec le code que les utilisateurs de Nvidia exécutent déjà.
vLLM est un moteur open source populaire pour servir des modèles de langage. Il reçoit les requêtes, les regroupe par lots et renvoie rapidement les réponses. L'image d'Intel embarque une version modifiée de vLLM avec tout le reste nécessaire pour le faire tourner sur du matériel Arc.
Ce qui change dans la version 1.5
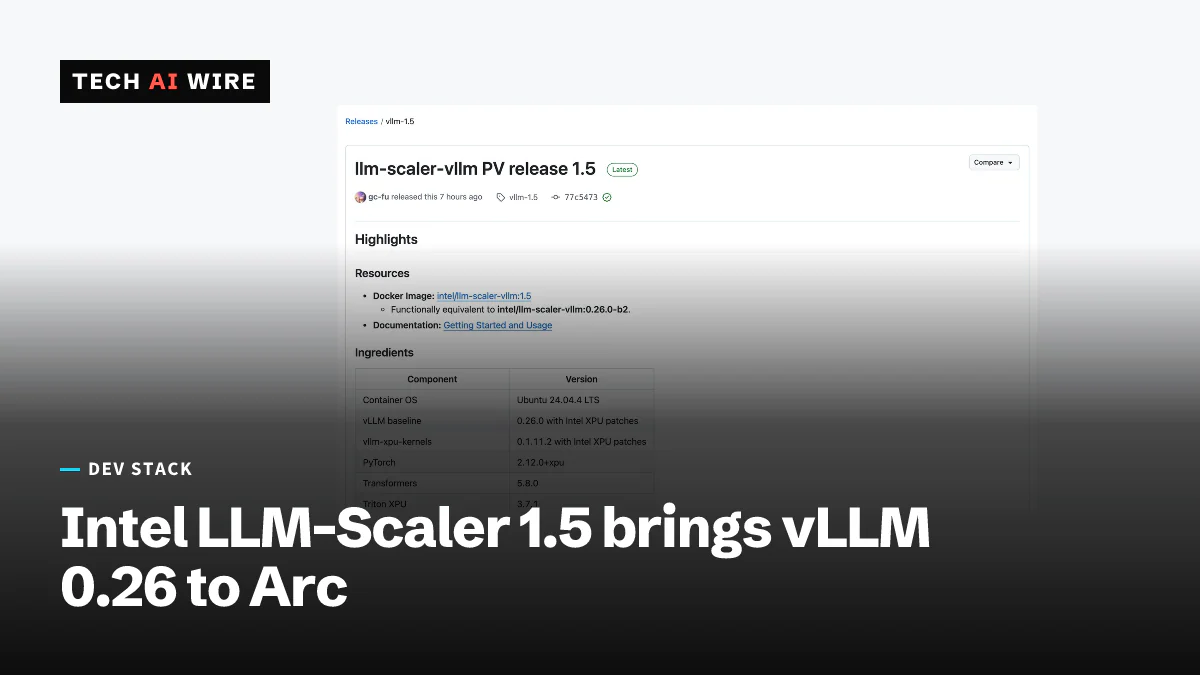
La version fait avancer presque toutes les couches de la pile, selon les notes de version d'Intel sur GitHub. L'image tourne sur Ubuntu 24.04.4 LTS.
| Composant | Avant | Dans la 1.5 |
|---|---|---|
| vLLM | 0.14.0 | 0.26.0, avec les correctifs XPU d'Intel |
| PyTorch | 2.10 | 2.12.0+xpu |
| Transformers | non indiqué | 5.8.0 |
| Triton XPU | non indiqué | 3.7.1 |
| vllm-xpu-kernels | non indiqué | 0.1.11.2 |
Le saut est important, mais la pile reste en retard sur le projet principal. Le vLLM amont en est à la version 0.31, note Phoronix. Intel construit cette pile dans le cadre de Project Battlematrix, son initiative pour transformer les cartes Arc en stations de travail pour l'IA. Phoronix présente cette version comme un travail préparatoire pour Crescent Island, le futur GPU pour centres de données d'Intel.
La nouvelle image Docker est intel/llm-scaler-vllm:1.5. Intel indique qu'elle est fonctionnellement identique à la bêta 0.26.0-b2 publiée le 9 septembre.
Nouveaux modèles et formats
La version 1.5 ajoute la prise en charge de cinq modèles :
- Qwen3.6-27B
- Qwen3.8-27B
- Qwen3.6-35B-A3B
- gemma-4-26B-A4B-it
- gemma-4-31B-it
Elle ajoute aussi de nouvelles façons de réduire la taille des modèles. La quantification stocke les nombres d'un modèle avec une précision moindre, pour qu'il tienne dans moins de mémoire. La version prend en charge la quantification FP8 en ligne et INT4 symétrique, ainsi que les checkpoints déjà enregistrés en block-FP8. Elle peut aussi conserver en FP8 le cache KV, la mémoire qu'utilise un modèle pour retenir la conversation en cours.
Les autres ajouts comprennent le service LoRA et le MTP. Les adaptateurs LoRA sont de petits poids complémentaires qui adaptent un modèle à une tâche. Le MTP, ou prédiction multi-tokens (multi-token prediction), permet à un modèle de proposer plusieurs tokens à la fois. Intel mentionne aussi la prise en charge de DFlash, y compris pour Muse-Glimmer-30B.
Intel annonce un temps avant le premier token plus court pour les modèles Qwen et Gemma 4. C'est le temps qu'attend un utilisateur avant que la réponse commence. Intel cite aussi des gains de vitesse pour le décodage MTP, le service LoRA et le cache KV FP8.
Bogues corrigés et problèmes connus
La version corrige trois bogues qui produisaient des résultats erronés :
- Le cache de préfixes ne fonctionnait pas correctement avec le MTP. Le cache de préfixes réutilise le travail déjà fait quand de nombreux prompts commencent de la même façon.
- Les modèles quantifiés en INT4 symétrique pouvaient renvoyer une sortie incorrecte.
- Les modèles block-FP8 pouvaient corrompre leur sortie lors du décodage de plusieurs requêtes à la fois.
Intel signale deux problèmes connus. « La prise en charge des graphes XPU est expérimentale », indiquent les notes. L'usage multimodal de Muse-Glimmer nécessite aussi Transformers 5.15.0, alors que l'image embarque la version 5.8.0.
Ce que cela signifie pour les développeurs
Si vous servez des modèles sur des cartes Arc avec une image LLM-Scaler plus ancienne, faites la mise à jour. Les correctifs INT4 et block-FP8 suffisent à la justifier, car ces deux bogues renvoyaient de mauvaises réponses sans planter.
Vérifiez vos paramètres de lancement avec la nouvelle version de vLLM. Douze versions mineures séparent la 0.14 et la 0.26, et des options ou des valeurs par défaut ont pu changer entre-temps. Faites un test sur une machine de préproduction avant de remplacer l'image en production.
Si vous voulez utiliser Muse-Glimmer avec des images, attendez ou construisez votre propre image. La version de Transformers incluse est trop ancienne pour cela, d'après les propres notes d'Intel. Laissez le mode graphe XPU désactivé en production tant qu'Intel le qualifie d'expérimental.
Le signal le plus important, c'est le rythme. Intel livre désormais un vLLM qui n'a que cinq versions de retard sur l'amont. Cela fait d'Arc une option plus réaliste pour servir des modèles en local et sur site.
Sources
- Intel LLM-Scaler-vLLM PV 1.5 Brings Big Improvements - Phoronix
- llm-scaler releases - GitHub (Intel)
Articles liés
Qwen3.5-9B dépense 32 Ko par jeton pour son cache KV
Qwen3.5-9B n'utilise l'attention complète que sur 8 de ses 32 couches, donc son cache KV coûte 32 Ko par jeton. Ce rapport décide s'il tient dans 8 Go.
AMD GAIA 0.25 regroupe ses agents d'IA locaux en un seul
L'application open source d'agents locaux d'AMD n'exécute plus qu'un agent, réduit son installation Python sous Windows de 0,9 Go à 0,1 Go et ne plante plus sur les portables de 16 Go.
Strands Decider 2B tranche les choix d'agents en 115 ms
Strands Decider 2B d'AWS est un modèle open source qui choisit dans une liste au lieu d'écrire du texte. Il répond en 115 ms sur une RTX 3090 et obtient 72,3 % sur JevBench.