Intel LLM-Scaler-vLLM 1.5、Arc GPUでvLLM 0.26に一気に移行
Intel(インテル)のLLM-Scaler-vLLM 1.5は、Arc GPU向けのDockerスタックをvLLM 0.14から0.26に移行しました。Gemma 4とQwen3.8のモデル、FP8とINT4のオプションも追加しています。
3 分で読めます
数字で見る
- vLLM version inside the Docker image
- 0.14 → 0.26
- current upstream vLLM release, per Phoronix
- 0.31
- newly supported Qwen and Gemma 4 models
- 5
- PyTorch version, up from 2.10
- 2.12
Intelは2026年10月16日、LLM-Scaler-vLLMのバージョン1.5を公開しました。IntelのArcグラフィックスカードで大規模言語モデルを動かすための、すぐに使えるDockerイメージです。今回の更新で中核のエンジンがvLLM 0.14からvLLM 0.26に移行し、新しいQwenとGemma 4のモデルが加わりました。Intel GPUでモデルを提供する人にとっては、Nvidiaのユーザーがすでに使っているコードとの差の多くが埋まります。
vLLMは、言語モデルを提供(サービング)するための人気のオープンソースエンジンです。リクエストを受け取り、まとめて処理し、すばやく回答を返します。Intelのイメージは、パッチを当てたvLLMと、Arcのハードウェアで動かすのに必要なものをすべてまとめています。
バージョン1.5の変更点
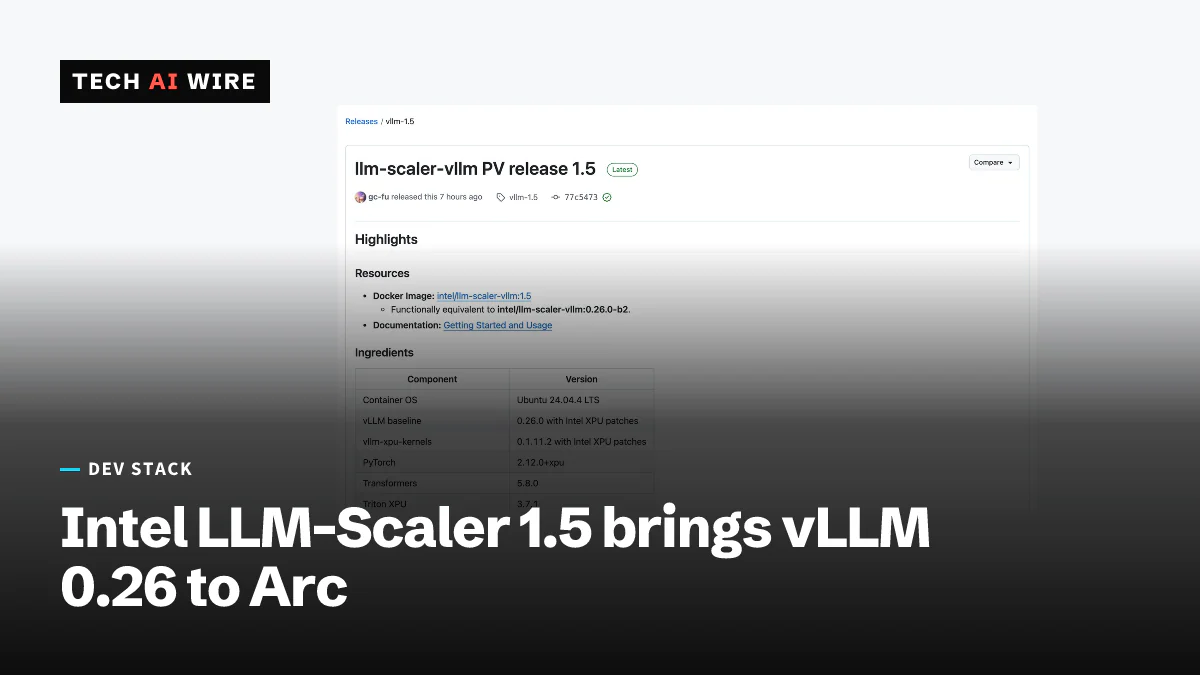
GitHubにあるIntelのリリースノートによると、今回のリリースではスタックのほぼすべての層が新しくなりました。イメージはUbuntu 24.04.4 LTS上で動作します。
| コンポーネント | 以前 | 1.5 |
|---|---|---|
| vLLM | 0.14.0 | 0.26.0(Intel XPU向けパッチ適用) |
| PyTorch | 2.10 | 2.12.0+xpu |
| Transformers | 記載なし | 5.8.0 |
| Triton XPU | 記載なし | 3.7.1 |
| vllm-xpu-kernels | 記載なし | 0.1.11.2 |
大きな飛躍ですが、本家のプロジェクトにはまだ遅れています。Phoronixによると、上流のvLLMは0.31です。Intelはこのスタックを、ArcカードをAIワークステーションに変える取り組み「Project Battlematrix」の一環として開発しています。Phoronixは今回のリリースを、Intelが今後投入するデータセンター向けGPU「Crescent Island」への布石と位置づけています。
新しいDockerイメージはintel/llm-scaler-vllm:1.5です。Intelによると、機能的には9月9日に公開したベータ版0.26.0-b2と同じです。
新しいモデルと形式
バージョン1.5では、5つのモデルに新たに対応しました。
- Qwen3.6-27B
- Qwen3.8-27B
- Qwen3.6-35B-A3B
- gemma-4-26B-A4B-it
- gemma-4-31B-it
モデルを小さくする新しい方法も加わりました。量子化とは、モデルの数値を低い精度で保存し、少ないメモリーに収めることです。今回のリリースは、オンラインのFP8量子化と対称INT4量子化に対応します。すでにblock-FP8で保存されたチェックポイントも使えます。KVキャッシュをFP8で保持することもできます。KVキャッシュとは、モデルがそれまでの会話を保持するために使うメモリーです。
ほかに、LoRAによるサービングとMTPも追加されました。LoRAアダプターは、モデルを1つのタスク向けに調整する小さな追加の重みです。MTP(マルチトークン予測)は、モデルが一度に複数のトークンを提案できるようにする仕組みです。IntelはDFlashへの対応も挙げており、Muse-Glimmer-30Bでも使えます。
Intelによると、QwenとGemma 4のモデルで最初のトークンが出るまでの時間(time to first token)が短くなりました。これは、ユーザーが回答の始まりを待つ時間のことです。MTPのデコード、LoRAのサービング、FP8 KVキャッシュの高速化も挙げています。
修正されたバグと既知の問題
今回のリリースでは、誤った結果を生む3つのバグが修正されました。
- プレフィックスキャッシュが、MTPと組み合わせると正しく動作しませんでした。プレフィックスキャッシュは、多くのプロンプトが同じ書き出しで始まるときに、処理を再利用する仕組みです。
- 対称INT4に量子化されたモデルが、誤った出力を返すことがありました。
- block-FP8のモデルが、複数のリクエストを同時にデコードする際に、出力を壊すことがありました。
Intelは既知の問題を2つ挙げています。ノートには「XPUグラフのサポートは実験的です」とあります。また、Muse-Glimmerをマルチモーダルで使うにはTransformers 5.15.0が必要ですが、イメージに含まれているのは5.8.0です。
開発者にとっての意味
古いLLM-Scalerのイメージを使ってArcカードでモデルを提供しているなら、アップグレードしてください。INT4とblock-FP8の修正だけでも重要です。どちらのバグも、クラッシュせずに誤った回答を返していたからです。
起動設定を、新しいvLLMと照らし合わせて確認してください。0.14と0.26の間には12のマイナーバージョンがあり、その間にフラグやデフォルト値が変わっている可能性があります。本番のイメージを入れ替える前に、ステージング環境でテストしましょう。
Muse-Glimmerを画像付きで使いたいなら、待つか、自分でイメージをビルドしてください。Intel自身のノートによると、同梱のTransformersのバージョンは古すぎて対応していません。Intelが実験的と位置づけている間は、本番環境でXPUグラフモードを無効にしておきましょう。
より大きなシグナルは、そのペースです。Intelが提供するvLLMは、上流からわずか5バージョン遅れになりました。これにより、Arcはローカルやオンプレミスでのモデル提供に向けた、より現実的な選択肢になります。
出典
- Intel LLM-Scaler-vLLM PV 1.5 Brings Big Improvements - Phoronix
- llm-scaler releases - GitHub (Intel)
関連記事
Qwen3.5-9B、KVキャッシュに1トークン32KBを使う
Qwen3.5-9Bは32層のうち8層だけがフルアテンション(全体参照型の注意機構)で、KVキャッシュの費用は1トークン32KBです。この比率が8GBに収まるかを決めます。
AMD GAIA 0.25、ローカルAIエージェントを1つに統合
AMDのオープンソースのローカルエージェントアプリGAIA(ガイア)は、1つのエージェントだけを動かすようになりました。WindowsのPython環境は0.9GBから0.1GBに縮み、16GBのノートPCでもクラッシュしなくなりました。
Strands Decider 2Bはエージェントの判断を115ミリ秒で下す
AWSのStrands Decider 2Bは、テキストを書かずに選択肢から選ぶオープンソースのデシジョンモデルだ。RTX 3090で115ミリ秒で答え、JevBenchで72.3%を記録した。