Intel LLM-Scaler-vLLM 1.5 salta para o vLLM 0.26 nas GPUs Arc
O LLM-Scaler-vLLM 1.5 da Intel leva sua pilha Docker para GPUs Arc do vLLM 0.14 ao 0.26 e adiciona modelos Gemma 4 e Qwen3.8, além de opções FP8 e INT4.
3 min de leitura
Em números
- vLLM version inside the Docker image
- 0.14 → 0.26
- current upstream vLLM release, per Phoronix
- 0.31
- newly supported Qwen and Gemma 4 models
- 5
- PyTorch version, up from 2.10
- 2.12
A Intel lançou a versão 1.5 do LLM-Scaler-vLLM em 16 de outubro de 2026. É uma imagem Docker pronta para rodar grandes modelos de linguagem nas placas de vídeo Arc da Intel. A atualização leva seu motor principal do vLLM 0.14 ao vLLM 0.26 e adiciona modelos Qwen e Gemma 4 mais novos. Para quem serve modelos em GPUs da Intel, ela reduz boa parte da distância em relação ao código que os usuários da Nvidia já rodam.
O vLLM é um motor open source popular para servir modelos de linguagem. Ele recebe requisições, agrupa-as em lotes e devolve respostas rapidamente. A imagem da Intel traz uma versão modificada dele com tudo o mais que é preciso para rodá-lo em hardware Arc.
O que mudou na versão 1.5
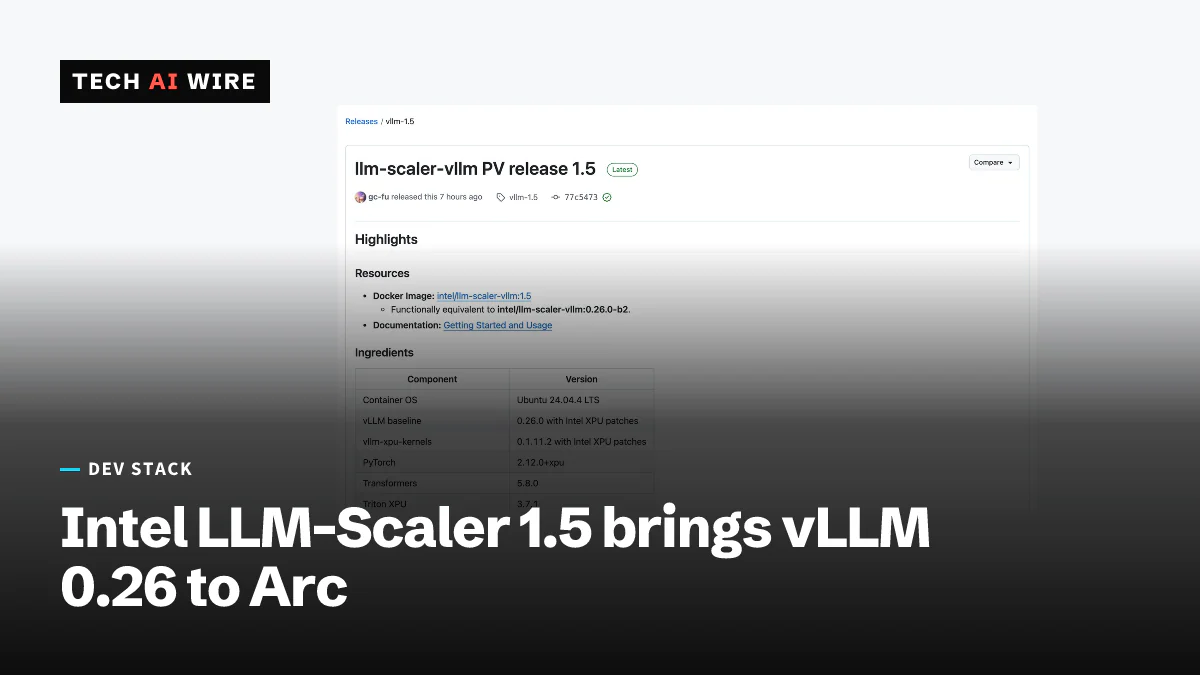
A versão leva adiante quase todas as camadas da pilha, segundo as notas de lançamento da Intel no GitHub. A imagem roda no Ubuntu 24.04.4 LTS.
| Componente | Antes | Na 1.5 |
|---|---|---|
| vLLM | 0.14.0 | 0.26.0, com patches da Intel para XPU |
| PyTorch | 2.10 | 2.12.0+xpu |
| Transformers | não listado | 5.8.0 |
| Triton XPU | não listado | 3.7.1 |
| vllm-xpu-kernels | não listado | 0.1.11.2 |
O salto é grande, mas a pilha ainda fica atrás do projeto principal. O vLLM upstream está na 0.31, observa o Phoronix. A Intel constrói a pilha dentro do Project Battlematrix, seu esforço para transformar as placas Arc em estações de trabalho de IA. O Phoronix descreve o lançamento como uma preparação para a futura GPU de data center Crescent Island da Intel.
A nova imagem Docker é intel/llm-scaler-vllm:1.5. A Intel diz que ela é funcionalmente igual à beta 0.26.0-b2, publicada em 9 de setembro.
Novos modelos e formatos
A versão 1.5 adiciona suporte a cinco modelos:
- Qwen3.6-27B
- Qwen3.8-27B
- Qwen3.6-35B-A3B
- gemma-4-26B-A4B-it
- gemma-4-31B-it
Ela também adiciona novas formas de encolher modelos. A quantização armazena os números de um modelo com menor precisão para que ele caiba em menos memória. A versão suporta quantização FP8 online e INT4 simétrica, além de checkpoints já salvos em block-FP8. Ela também pode manter em FP8 o KV cache, a memória que um modelo usa para guardar a conversa até ali.
Outras novidades incluem o serving de LoRA e o MTP. Adaptadores LoRA são pequenos pesos adicionais que ajustam um modelo para uma tarefa. O MTP, ou multi-token prediction (previsão de múltiplos tokens), permite que um modelo proponha vários tokens de uma vez. A Intel também lista suporte ao DFlash, inclusive para o Muse-Glimmer-30B.
A Intel informa um time to first token mais rápido para os modelos Qwen e Gemma 4. É quanto tempo o usuário espera até a resposta começar. Ela também lista ganhos de velocidade na decodificação com MTP, no serving de LoRA e no KV cache em FP8.
Bugs corrigidos e problemas conhecidos
A versão corrige três bugs que produziam resultados errados:
- O prefix caching não funcionava corretamente com MTP. O prefix caching reaproveita trabalho quando muitos prompts começam da mesma forma.
- Modelos quantizados em INT4 simétrico podiam devolver saídas incorretas.
- Modelos block-FP8 podiam corromper sua saída ao decodificar várias requisições ao mesmo tempo.
A Intel lista dois problemas conhecidos. "O suporte a grafos XPU é experimental", dizem as notas. O uso multimodal do Muse-Glimmer também exige o Transformers 5.15.0, enquanto a imagem traz o 5.8.0.
O que isso significa para desenvolvedores
Se você serve modelos em placas Arc com uma imagem antiga do LLM-Scaler, atualize. Só as correções de INT4 e block-FP8 já importam, porque os dois bugs devolviam respostas erradas sem travar.
Confira suas configurações de inicialização com o vLLM mais novo. Doze versões menores separam a 0.14 da 0.26, e flags ou padrões podem ter mudado no meio do caminho. Teste em uma máquina de staging antes de trocar a imagem de produção.
Se você quer o Muse-Glimmer com imagens, espere ou monte sua própria imagem. A versão do Transformers incluída é antiga demais para isso, segundo as próprias notas da Intel. Mantenha o modo de grafos XPU desligado em produção enquanto a Intel o chamar de experimental.
O sinal maior é o ritmo. A Intel agora entrega um vLLM apenas cinco versões atrás do upstream. Isso torna as placas Arc uma opção mais realista para servir modelos localmente e on-premises.
Fontes
- Intel LLM-Scaler-vLLM PV 1.5 Brings Big Improvements - Phoronix
- llm-scaler releases - GitHub (Intel)
Artigos relacionados
Qwen3.5-9B gasta 32 KB por token no cache KV
O Qwen3.5-9B usa atenção completa em apenas 8 das suas 32 camadas, então o cache KV custa 32 KB por token. Essa proporção decide se ele cabe em 8 GB.
AMD GAIA 0.25 reúne seus agentes de IA locais em um só
O app de código aberto da AMD para agentes locais agora roda um único agente, reduz o ambiente Python no Windows de 0,9 GB para 0,1 GB e para de travar em notebooks de 16 GB.
Strands Decider 2B toma decisões de agentes em 115 ms
O Strands Decider 2B, da AWS, é um modelo de código aberto que escolhe em uma lista em vez de escrever texto. Ele responde em 115 ms em uma RTX 3090 e marca 72,3% no JevBench.