Intel LLM-Scaler-vLLM 1.5 salta a vLLM 0.26 en las GPU Arc
LLM-Scaler-vLLM 1.5 de Intel lleva su pila Docker para GPU Arc de vLLM 0.14 a 0.26 y añade modelos Gemma 4 y Qwen3.8, además de opciones FP8 e INT4.
3 min de lectura
En cifras
- vLLM version inside the Docker image
- 0.14 → 0.26
- current upstream vLLM release, per Phoronix
- 0.31
- newly supported Qwen and Gemma 4 models
- 5
- PyTorch version, up from 2.10
- 2.12
Intel publicó la versión 1.5 de LLM-Scaler-vLLM el 16 de octubre de 2026. Es una imagen Docker lista para usar que ejecuta grandes modelos de lenguaje en las tarjetas gráficas Arc de Intel. La actualización lleva su motor principal de vLLM 0.14 a vLLM 0.26 y añade modelos Qwen y Gemma 4 más recientes. Para quien sirve modelos en GPU de Intel, cierra buena parte de la distancia con el código que los usuarios de Nvidia ya ejecutan.
vLLM es un popular motor de código abierto para servir modelos de lenguaje. Recibe solicitudes, las agrupa en lotes y devuelve las respuestas con rapidez. La imagen de Intel incluye una versión parcheada de vLLM junto con todo lo demás necesario para ejecutarlo en hardware Arc.
Qué cambió en la versión 1.5
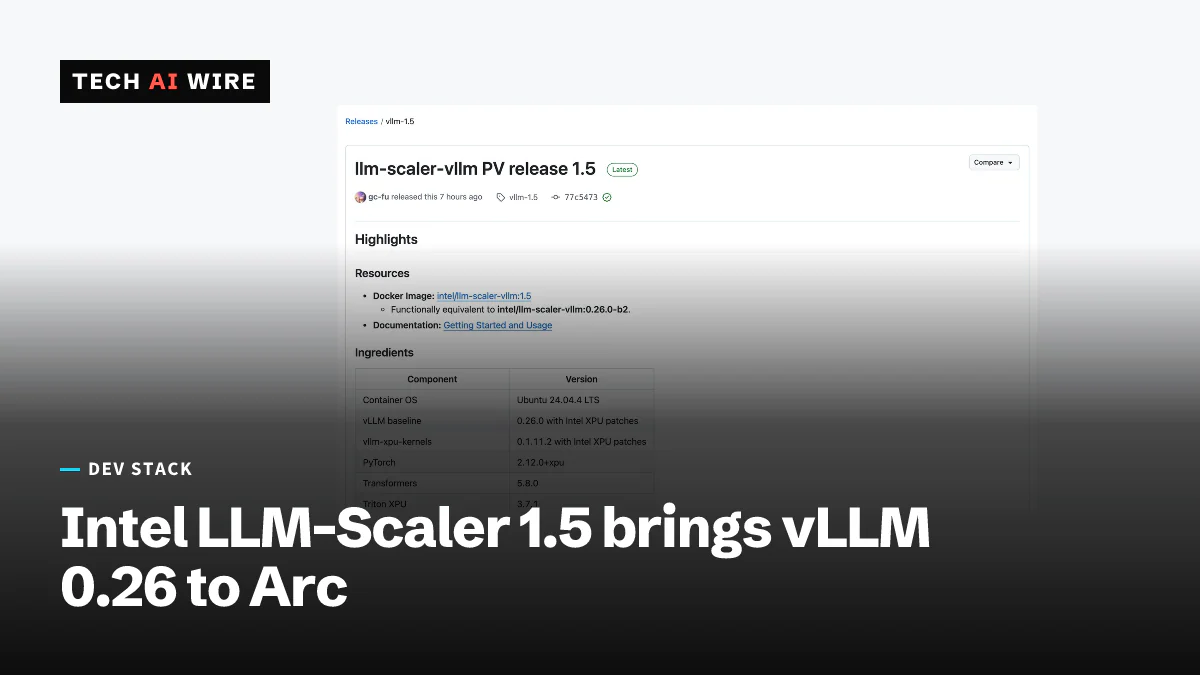
La versión hace avanzar casi todas las capas de la pila, según las notas de la versión de Intel en GitHub. La imagen funciona sobre Ubuntu 24.04.4 LTS.
| Componente | Antes | En 1.5 |
|---|---|---|
| vLLM | 0.14.0 | 0.26.0, con parches XPU de Intel |
| PyTorch | 2.10 | 2.12.0+xpu |
| Transformers | no indicado | 5.8.0 |
| Triton XPU | no indicado | 3.7.1 |
| vllm-xpu-kernels | no indicado | 0.1.11.2 |
El salto es grande, pero la pila sigue por detrás del proyecto principal. El vLLM de upstream ya va por la 0.31, señala Phoronix. Intel desarrolla la pila dentro de Project Battlematrix, su iniciativa para convertir las tarjetas Arc en estaciones de trabajo de IA. Phoronix describe la versión como la base para Crescent Island, la próxima GPU de Intel para centros de datos.
La nueva imagen Docker es intel/llm-scaler-vllm:1.5. Intel dice que es funcionalmente igual que la beta 0.26.0-b2 que publicó el 9 de septiembre.
Nuevos modelos y formatos
La versión 1.5 añade compatibilidad con cinco modelos:
- Qwen3.6-27B
- Qwen3.8-27B
- Qwen3.6-35B-A3B
- gemma-4-26B-A4B-it
- gemma-4-31B-it
También añade nuevas formas de reducir el tamaño de los modelos. La cuantización guarda los números de un modelo con menos precisión para que quepa en menos memoria. La versión admite cuantización FP8 en línea e INT4 simétrica, además de checkpoints ya guardados en block-FP8. También puede guardar en FP8 la caché KV, la memoria que usa un modelo para retener la conversación hasta ese momento.
Otras novedades son el servicio de LoRA y MTP. Los adaptadores LoRA son pequeños pesos adicionales que ajustan un modelo para una tarea. MTP, o predicción de múltiples tokens, permite que un modelo proponga varios tokens a la vez. Intel también menciona compatibilidad con DFlash, incluido Muse-Glimmer-30B.
Intel informa de un menor tiempo hasta el primer token en los modelos Qwen y Gemma 4. Es el tiempo que espera un usuario antes de que empiece la respuesta. También indica que la decodificación MTP, el servicio de LoRA y la caché KV en FP8 son más rápidos.
Errores corregidos y problemas conocidos
La versión corrige tres errores que producían resultados incorrectos:
- La caché de prefijos no funcionaba bien con MTP. La caché de prefijos reutiliza trabajo cuando muchos prompts empiezan igual.
- Los modelos cuantizados en INT4 simétrica podían devolver resultados incorrectos.
- Los modelos block-FP8 podían corromper su salida al decodificar varias solicitudes a la vez.
Intel indica dos problemas conocidos. «La compatibilidad con grafos XPU es experimental», dicen las notas. El uso multimodal de Muse-Glimmer también necesita Transformers 5.15.0, mientras que la imagen incluye la 5.8.0.
Qué significa esto para los desarrolladores
Si sirve modelos en tarjetas Arc con una imagen anterior de LLM-Scaler, actualice. Las correcciones de INT4 y block-FP8 importan por sí solas, porque ambos errores devolvían respuestas incorrectas sin provocar un fallo.
Revise su configuración de arranque frente al vLLM más reciente. Entre 0.14 y 0.26 hay doce versiones menores, y es posible que hayan cambiado opciones o valores por defecto entre medias. Pruebe en un equipo de staging antes de cambiar la imagen de producción.
Si quiere usar Muse-Glimmer con imágenes, espere o cree su propia imagen. La versión de Transformers incluida es demasiado antigua para ello, según las propias notas de Intel. Mantenga desactivado el modo de grafos XPU en producción mientras Intel lo considere experimental.
La señal más importante es el ritmo. Intel ya distribuye un vLLM que va solo cinco versiones por detrás de upstream. Eso convierte a Arc en una opción más realista para servir modelos en local y en instalaciones propias.
Fuentes
- Intel LLM-Scaler-vLLM PV 1.5 Brings Big Improvements - Phoronix
- llm-scaler releases - GitHub (Intel)
Artículos relacionados
Qwen3.5-9B gasta 32 KB por token en la caché KV
Qwen3.5-9B usa atención completa en solo 8 de sus 32 capas, así que su caché KV cuesta 32 KB por token. Esa proporción decide si cabe en 8 GB.
AMD GAIA 0.25 unifica sus agentes de IA locales en uno solo
La app de código abierto de AMD para agentes locales ahora ejecuta un solo agente, reduce su entorno de Python en Windows de 0,9 GB a 0,1 GB y ya no falla en portátiles de 16 GB.
Strands Decider 2B toma decisiones de agentes en 115 ms
Strands Decider 2B de AWS es un modelo de código abierto que elige de una lista en lugar de escribir texto. Responde en 115 ms en una RTX 3090 y obtiene un 72,3 % en JevBench.