DeepSeek V4.1-Flash-1017 steigert Agenten-Werte, der Preis bleibt gleich
DeepSeeks Update V4.1-Flash-1017 erreicht 77,0 % auf DeepSWE, nach 74,2 %, bei unveränderten API-Preisen. Neu sind Search- und Fetch-APIs für 0,75 $ pro 1.000 Aufrufe.
3 Min. Lesezeit
Die Zahlen
- parameters in the open-weight model
- 763B
- tokens of context
- 1M
- DeepSWE v1.1 score, up from 74.2%
- 77.0%
- per 1,000 calls to the new Search or Fetch API
- $0.75
- V4.1-Flash-1017
- 77%
- V4.1-Flash (September)
- 74.2%
- Opus 5
- 74%
- GPT-5.6 Sol
- 73%
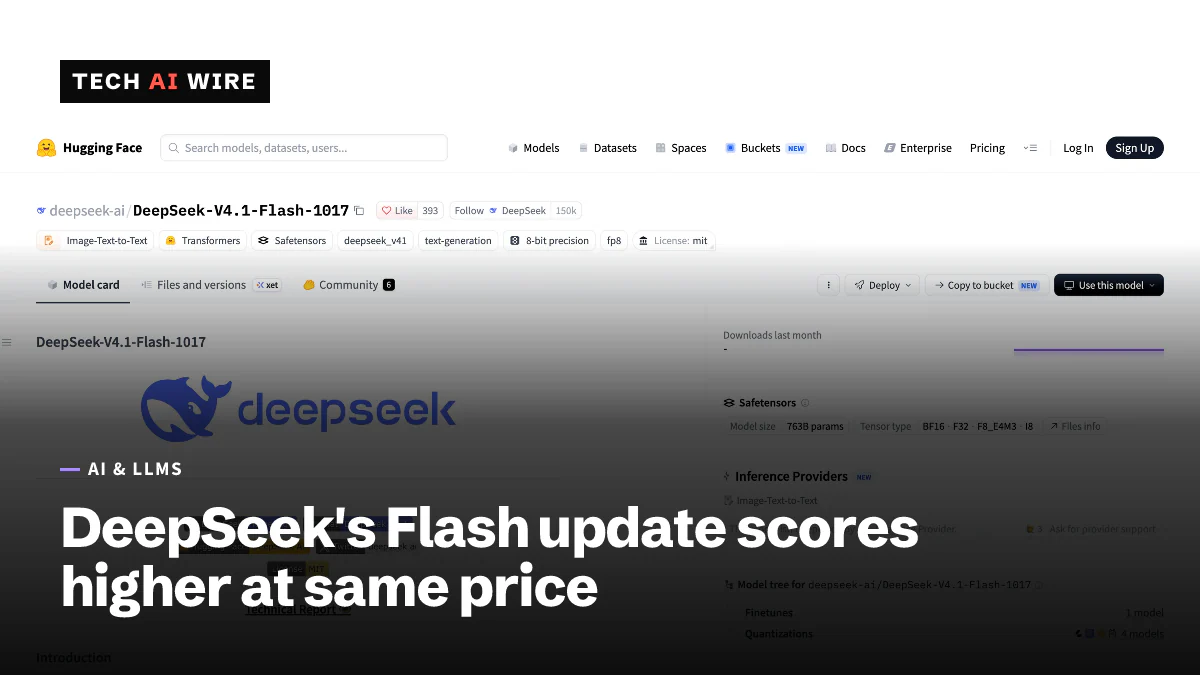
DeepSeek hat am 17. Oktober 2026 DeepSeek-V4.1-Flash-1017 veröffentlicht, ein Update des Modells V4.1 Flash, das am 10. September erschienen war. Die neue Version erzielt höhere Werte in Coding- und Agenten-Benchmarks und kostet im Aufruf genauso viel. Entwickler, die den API-Namen deepseek-flash nutzen, bekommen sie automatisch, und die Gewichte stehen unter der MIT-Lizenz kostenlos zum Download bereit.
Was DeepSeek geändert hat
DeepSeeks API-Changelog meldet, V4.1 Flash sei auf die Version 1017 "aktualisiert worden". Aufrufer müssen nichts ändern: Der Modellname deepseek-flash liefert jetzt den neuen Checkpoint. Ein Checkpoint ist eine gespeicherte Version eines trainierten Modells. "Die Art des API-Aufrufs und die Preise bleiben unverändert", heißt es im Changelog.
Die Modellkarte auf Hugging Face nennt 763 Milliarden Parameter und ein Kontextfenster von 1 Million Token. Das Kontextfenster gibt an, wie viel Text das Modell auf einmal lesen kann. DeepSeek hat nicht angegeben, wie viele Parameter pro Token aktiv sind.
The Decoder berichtet, dass DeepSeek das Update "eine Pareto-Verbesserung" beim Abwägen zwischen Leistung und Kosten nennt. Einfach gesagt: Es ist besser, ohne teurer zu sein.
Wie sich die Benchmarks verändert haben
DeepSeeks eigene Tabelle vergleicht das Update mit der Version vom September und mit zwei geschlossenen Frontier-Modellen. Es sind DeepSeeks Zahlen, keine unabhängigen Tests.
| Benchmark | V4.1-Flash-1017 | V4.1-Flash | GPT-5.6 Sol | Opus 5 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 42,3 | 31,2 | 39,9 | 51,8 |
| DeepSWE v1.1 | 77,0 | 74,2 | 73,0 | 74,0 |
| ProgramBench | 29,1 | 20,3 | 23,0 | 37,0 |
| NL2Repo-Bench | 68,2 | 65,4 | 56,8 | 75,3 |
| Automation-Bench v1.0.6 | 60,5 | 54,8 | 45,8 | 50,3 |
| Humanity's Last Exam, ohne Werkzeuge | 42,6 | 36,8 | 44,5 | 56,3 |
Der größte Sprung gelingt auf Terminal-Bench 4.0, einem Test mit Kommandozeilen-Aufgaben, den DeepSeek in Claude Code ausgeführt hat. Der Wert stieg um 11,1 Punkte. Bei den Coding- und Agenten-Tests der Tabelle liegt Opus 5 noch in drei von fünf vorn, während 1017 bei DeepSWE und Automation-Bench führt.
Die Kosten pro Aufgabe
Der Preis pro Token ist bei Agenten, die viele Schritte lang laufen können, nur die halbe Wahrheit. The Decoder hat sich die Kosten pro erledigter Aufgabe auf DeepSWE angesehen. In der höchsten Einstellung erreichte 1017 77,0 % für knapp unter 0,20 $ pro Aufgabe. Eine niedrigere Einstellung schaffte immer noch 72 % für etwa 0,10 $.
Die Version vom September erreichte 74,2 % bei rund 0,50 $ pro Durchlauf. The Decoder beziffert GPT-6 Astra, Gemini 3.8 Flash und Claude Opus 5 auf 2 $ bis mehr als 10 $ pro Aufgabe. Der neue Checkpoint ist also sowohl genauer als auch günstiger pro Aufgabe als der, den er ersetzt.
Neue Search- und Fetch-APIs
Laut Changelog hat DeepSeek am selben Tag außerdem eine Search- und Fetch-API bereitgestellt. Agenten nutzen solche Werkzeuge, um während der Arbeit Dinge im Web nachzuschlagen. The Decoder nennt einen Preis von 0,75 $ pro 1.000 Aufrufe für jeden Endpunkt.
Beide sind bis zum 31. Oktober 2026 um 16:00 Uhr UTC kostenlos, für API-Nutzer, die sie über serverseitige Werkzeuge in DeepSeek Harness, Claude Code oder Codex aufrufen, so The Decoder.
DeepSeek sagt, das Modell sei auf DeepSeek Harness, Tencent CodeBuddy und WorkBuddy abgestimmt, und empfiehlt Harness 0.2.1-rc.1 oder neuer. Harness ist DeepSeeks eigene Open-Source-Laufzeitumgebung für Agenten, die am 2. Oktober eine Desktop-App für macOS und Windows bekam.
Wo es das Modell gibt
| Kanal | Detail |
|---|---|
| DeepSeek API | deepseek-flash, gleicher Preis wie zuvor |
| Gewichte | Hugging Face, MIT-Lizenz |
| OpenRouter | deepseek/deepseek-v4.1-flash-1017 |
| Routing innerhalb der EU auf OpenRouter | Noch nicht verfügbar |
Was das für Entwickler bedeutet
Wenn Sie deepseek-flash schon aufrufen, läuft Ihr Traffic seit heute auf 1017. Lassen Sie Ihr eigenes Evaluationsset diese Woche erneut laufen, denn ein stiller Modellwechsel kann Länge und Format der Ausgaben ändern. Kürzere Antworten sparen Geld, können aber Parser stören, die eine feste Form erwarten.
Wenn Sie Modelle nach den Kosten pro erledigter Aufgabe auswählen, testen Sie DeepSeek erneut gegen Ihre aktuelle Wahl. Nach den Zahlen von The Decoder kostet 1017 auf DeepSWE ein Zehntel oder weniger dessen, was die geschlossenen Modelle kosten. Die einzige Zahl, die zählt, ist die Ihrer eigenen Agenten-Schleife.
Das kostenlose Zeitfenster für Search und Fetch endet am 31. Oktober. Testen Sie damit, ob DeepSeeks Suche eine kostenpflichtige Such-API in Ihrem Agenten ersetzen kann. Planen Sie danach 0,75 $ pro 1.000 Aufrufe und Endpunkt ein.
Teams in der EU, die eine Verarbeitung innerhalb der Region brauchen, sollten die Lücke bei OpenRouter beachten. Vorerst sind die selbst gehosteten MIT-Gewichte der Weg, Daten lokal zu halten.
Quellen
- Change Log - DeepSeek API Docs
- deepseek-ai/DeepSeek-V4.1-Flash-1017 - Hugging Face
- Deepseek V4.1 Flash 1017 beats larger rivals in agentic tasks while once again massively cutting per-task costs - The Decoder
- DeepSeek: DeepSeek v4.1 Flash 1017 - OpenRouter
Ähnliche Artikel
Reflection AI stellt Beam vor, ein Open-Weight-Modell mit 501 Milliarden Parametern
Beam von Reflection AI hat 501 Milliarden Parameter, nutzt aber 23 Milliarden pro Token, erreicht 80,9 bei SWE-Bench Verified, und die Gewichte erscheinen später im Oktober unter Apache 2.0.
DeepSeek warnt Entwickler vor einer deutlichen API-Preiserhöhung
DeepSeek warnte Entwickler am 6. August, dass die API-Preise bald 'deutlich' steigen - ohne Zahlen oder Termine, während V4-Flash das günstigste namhafte Modell im Betrieb ist.
StepFun Step 5 Preview: 600B-Agentenmodell mit offenen Gewichten
Step 5 Preview von StepFun, ein Modell mit 600B Parametern, davon 27B aktiv, und 1M Token Kontext, ist auf Hugging Face. Zuvor gab es das Modell einen Monat nur per API, zu 1 $/2,70 $ pro Mio. Tokens.