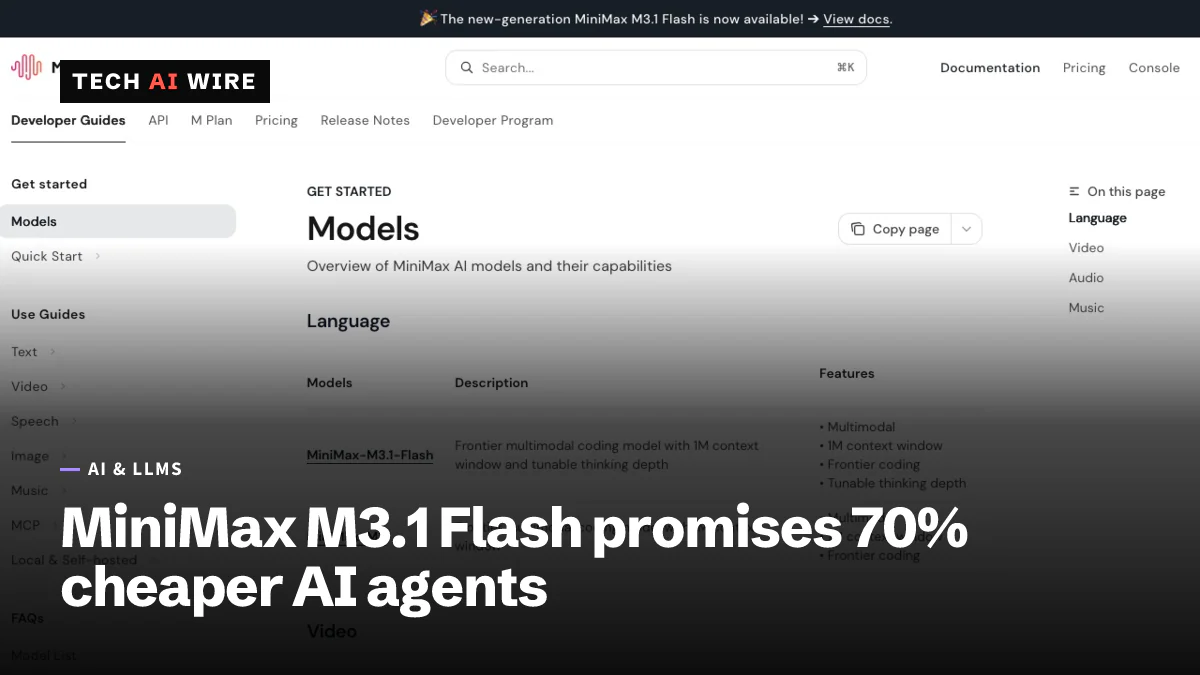
MiniMax M3.1 Flash startet und verspricht 70 % günstigere Agenten
Das neue Modell von MiniMax kostet 0,15 $ pro Million Eingabe-Token und 0,60 $ für die Ausgabe. Laut dem Unternehmen laufen KI-Agenten damit 70 % günstiger als mit M3.
3 Min. Lesezeit
Die Zahlen
- per million input tokens
- $0.15
- per million output tokens
- $0.60
- lower agent costs than M3, per MiniMax
- 70%
- DeepSeek V4.1-Flash
- 77%
- MiniMax M3.1 Flash
- 73.7%
MiniMax hat am 19. Oktober 2026 begonnen, M3.1 Flash auszurollen, eine schnellere und günstigere Version seines KI-Modells M3. Laut dem Unternehmen senkt es die Kosten für den Betrieb von KI-Agenten um 70 %. Mit 0,15 $ pro Million Eingabe-Token konkurriert es beim Preis direkt mit den günstigen Modellen von DeepSeek.
Was MiniMax veröffentlicht hat
MiniMax ist ein chinesisches KI-Unternehmen, dessen Aktien in Hongkong gehandelt werden. Sein Modell M3 erschien im Juni. M3.1 Flash ist ein Update, das auf Tempo und niedrige Kosten ausgelegt ist. Die Ankündigung von MiniMax sagt, es werde "ab heute offiziell ausgerollt".
Entwickler erreichen es auf drei Wegen: über die MiniMax API, das Abo M Plan und die Desktop-App MiniMax Code. Die Berichte sind sich über den Status nicht einig. SiliconANGLE nennt es eine Vorschau und beruft sich dabei auf den Entwickler-Leitfaden von MiniMax. Der eigene Beitrag des Unternehmens verwendet dieses Wort nicht.
MiniMax hat außerdem ein Rätsel aufgeklärt. Ein Modell namens "Space Bunny" tauchte im September anonym auf OpenRouter auf, einer Website, die viele KI-Modelle über eine einzige API anbietet. Laut SiliconANGLE war es eine frühe Version von M3.1 Flash.
Preis und Tempo
Die Preise gelten pro Million Token. Ein Token ist ein kleines Stück Text, grob ein Teil eines Wortes.
| Posten | M3.1 Flash |
|---|---|
| Eingabe | 0,15 $ pro Million Token |
| Ausgabe | 0,60 $ pro Million Token |
| Gecachte Eingabe | 0,015 $ pro Million Token |
| Prompt-Größe | Bis zu 1 Million Token (SiliconANGLE) |
| Parameter insgesamt | 428 Milliarden (SiliconANGLE) |
Gecachte Eingabe ist Text, den der Dienst schon gesehen hat, etwa ein langer System-Prompt, der mit jeder Anfrage mitgeschickt wird. Sie kostet hier ein Zehntel einer neuen Eingabe.
MiniMax macht zwei Angaben zum Tempo. Die Online-Inferenz, also die Arbeit, Anfragen zu beantworten, sei "fast dreimal so schnell", doch der Beitrag sagt nicht, schneller als was. Außerdem liege die Ausgabe im Alltag bei über 200 Token pro Sekunde, mit einem Median von über 170. Die Kostensenkung um 70 % bezieht sich auf das vorherige Modell.
Benchmarks
Alle folgenden Werte stammen von MiniMax. Keine der beiden Quellen nennt externe Tests.
| Benchmark | Was er testet | Wert |
|---|---|---|
| OSWorld V2 | Bedienung der Apps und des Desktops eines Computers | 61,7 |
| BankerToolBench | Finanzaufgaben mit Werkzeugen | 76,2 |
| CyberGym | Sicherheitsaufgaben | 82 % |
| DeepSWE v1.1 | Beheben echter Softwareprobleme | 73,7 % |
| Agents' Last Exam | Schwierige Agentenaufgaben | 29,6 |
Bei DeepSWE v1.1 liegt M3.1 Flash hinter DeepSeeks V4.1-Flash, das 77 % erreichte, wie SiliconANGLE anmerkt. Dieser Vergleich ist für das Geschäft von MiniMax wichtig. Die Aktien des Unternehmens sollen gefallen sein, nachdem DeepSeek im September V4.1-Flash vorgestellt hatte.
"Flash steht für unsere fortlaufende Suche nach der Balance zwischen Effizienz und Leistungsfähigkeit", schrieb MiniMax.
Offene Gewichte folgen später
Die Gewichte von M3.1 Flash, also die Dateien, die man braucht, um ein Modell auf eigener Hardware zu betreiben, sind noch nicht erschienen. MiniMax sagt, sie würden "später veröffentlicht", ohne Datum oder Lizenz. Laut SiliconANGLE kommt außerdem ein größeres Pro-Modell.
Was das für Entwickler bedeutet
M3.1 Flash ist ein weiteres starkes, günstiges Modell für Agentenarbeit, doch seine wichtigsten Zahlen stammen vom Unternehmen selbst. Behandeln Sie es als Kandidaten zum Testen, nicht als erwiesenen Ersatz.
- Lassen Sie Ihre eigenen Agentenaufgaben laufen. Die Ersparnis von 70 % und die Benchmark-Werte stammen von MiniMax. Messen Sie die Kosten pro erledigter Aufgabe auf Ihrer Arbeitslast, nicht die Kosten pro Token.
- Nutzen Sie den Cache. Gecachte Eingabe kostet ein Zehntel der normalen Eingabe. Halten Sie lange Anweisungen über alle Aufrufe hinweg identisch, damit sie als gecacht zählen.
- Prüfen Sie den Zugangsweg. Das Modell ist über die API verfügbar, aber ein Bericht nennt es eine Vorschau. Prüfen Sie Limits und Bedingungen in Ihrem Konto, bevor Sie darauf aufbauen.
- Vergleichen Sie mit DeepSeek. DeepSeeks V4.1-Flash erzielte bei DeepSWE v1.1 einen höheren Wert. Wenn Code-Reparatur Ihr Haupteinsatz ist, testen Sie beide.
- Warten Sie auf die Gewichte, wenn Sie selbst hosten. Es gibt noch kein Datum und keine Lizenz für die offenen Gewichte. Planen Sie keinen Einsatz auf eigenen Servern, bis MiniMax beides veröffentlicht.
Quellen
- MiniMax M3.1 Flash - MiniMax
- MiniMax launches M3.1 Flash model, says it cuts AI agent costs by 70% - SiliconANGLE
Ähnliche Artikel
KI-Entscheidungsmodelle, erklärt
Ein Entscheidungsmodell wählt aus festen Antworten und gibt für jede eine Wahrscheinlichkeit zurück, statt Text zu schreiben. Gehostete Preise beginnen bei 0,02 $ pro Million Tokens.
Meta Muse Wonder startet als erstes Frontier-Modell des Konzerns
Meta hat Muse Wonder am 12. Oktober für 4 $ pro Million Eingabe-Token und 20 $ pro Million Ausgabe-Token veröffentlicht. Das größere Wonder Full bleibt Muse Code vorbehalten.
Xiaomi veröffentlicht MiMo-V2.6-Pro mit 1 Billion Parametern als offene Gewichte unter MIT
Xiaomis MiMo-V2.6-Pro hat 1,02 Billionen Parameter, davon 42 Milliarden aktiv, einen Kontext von 1 Million Tokens und MIT-lizenzierte Gewichte, braucht aber rund 680 GB GPU-Speicher.