La Decisions API de OpenAI se abre en beta a todos los desarrolladores
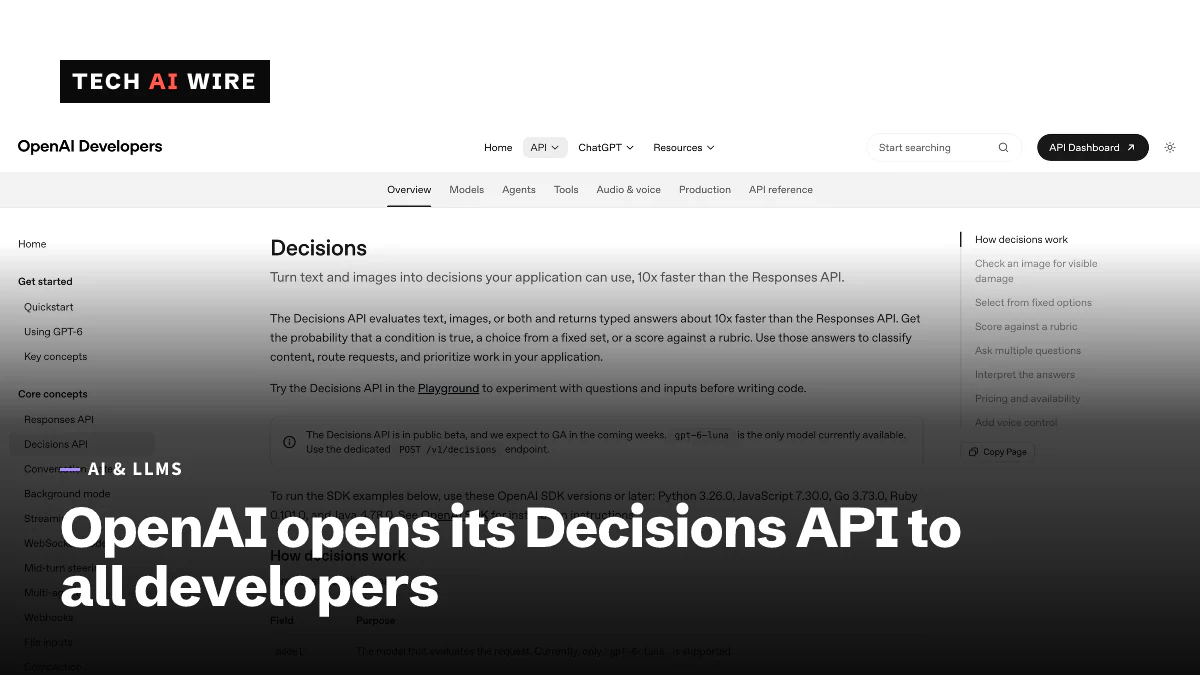
La Decisions API de OpenAI ya está en beta pública. Devuelve una probabilidad, una elección o una puntuación en lugar de texto, funciona con GPT-6 Luna y cuesta 0,10 dólares por 1 millón de tokens de entrada.
3 min de lectura
En cifras
- per 1M input tokens, with no output charge
- $0.10
- per request in OpenAI's demo, vs 1.6 s via the Responses API
- ~150 ms
- answer types: predicate, choice and score
- 3
- steps right in Every's preview test, vs 73 for Jev
- 76 of 78
OpenAI abrió su Decisions API a todos los desarrolladores como beta pública el 6 de octubre de 2026, según AlphaSignal. La API no escribe texto. Responde a una pregunta fija con una probabilidad, una elección de una lista o una puntuación. OpenAI dice que eso la hace unas 10 veces más rápida que hacer la misma pregunta a través de su Responses API. Para las aplicaciones que toman miles de pequeñas decisiones, como enrutar tickets de soporte, la velocidad y el precio son lo esencial.
Qué hace la Decisions API
La mayoría de las aplicaciones de IA piden a un modelo de lenguaje grande, o LLM, que tome pequeñas decisiones todo el día. ¿Este mensaje es spam? ¿Qué equipo debe recibir este ticket? El modelo escribe su respuesta como texto, palabra a palabra, y luego la aplicación la lee.
La Decisions API se salta la escritura. Se le envían pruebas, que pueden ser texto, imágenes o ambas cosas, junto con una pregunta. Devuelve una respuesta tipada en lugar de prosa. La documentación de OpenAI enumera tres tipos de respuesta:
| Tipo de respuesta | Qué se recibe |
|---|---|
| Predicate (predicado) | Una probabilidad entre 0 y 1, para preguntas de sí o no |
| Choice (elección) | Una de las opciones suministradas, con probabilidades y un valor de confianza |
| Score (puntuación) | Una puntuación ponderada por probabilidad en niveles ordenados, con confianza |
Las llamadas van a un nuevo endpoint, POST /v1/decisions. El único modelo con el que funciona hoy es GPT-6 Luna, dice la documentación.
Precio, límites y disponibilidad
La documentación indica un precio de 0,10 dólares por 1 millón de tokens de entrada. Los tokens son los pequeños fragmentos de texto que lee un modelo. No se cobra la salida, ni las lecturas ni las escrituras de caché. El procesamiento regional y las entradas muy largas cuestan más, aunque la página no da esas tarifas. AlphaSignal informó el día del lanzamiento de que aún no se había publicado un precio específico para Decisions, así que la cifra puede haberse añadido después.
Otros detalles de la documentación:
- Estado: beta pública, con disponibilidad general prevista «en las próximas semanas»
- Imágenes: deben enviarse en línea como data URL en base64; los enlaces a imágenes alojadas y los ID de archivo no funcionan
- Datos: residencia de datos en EE. UU. y Europa, además de Zero Data Retention y compatibilidad con HIPAA para los clientes que cumplan los requisitos
- SDK: Python 3.26.0, JavaScript 7.30.0, Go 3.73.0, Ruby 0.101.0 y Java 4.78.0
No se indican los límites de uso, el tamaño máximo de entrada ni el número máximo de opciones.
¿Qué velocidad tiene?
La afirmación sobre la velocidad procede de una demostración de la propia OpenAI. Enrutó 10 000 solicitudes de clientes entre los equipos de Facturación, Soporte técnico y Ventas. Cada decisión tardó unos 150 milisegundos, frente a 1,6 segundos con la Responses API, informa AlphaSignal. OpenAI no ha publicado ningún método para esa prueba.
La publicación Every hizo comprobaciones tempranas durante la versión preliminar. En una reproducción sin conexión de una tarea de uso del ordenador, la Decisions API acertó 76 de 78 pasos, informa AlphaSignal. Jev, de TypeSafe, un servicio de decisión rival, acertó 73. Al clasificar hilos de mensajes, los dos empataron en precisión y Jev fue más rápido. Ambas muestras eran pequeñas.
Una categoría nueva y concurrida
OpenAI mostró la API por primera vez como versión preliminar limitada el 29 de septiembre, informa XenoSpectrum. Llega a un campo muy activo. Jev, de TypeSafe, se lanzó en septiembre y afirma tardar entre 70 y 500 milisegundos por respuesta. Cloudflare siguió con Clef, modelos de pesos abiertos para decisiones, y AWS lanzó Strands Decider 2B.
XenoSpectrum sostiene que la idea es menos nueva de lo que parece. Structured Outputs ya puede obligar a un modelo a elegir entre opciones fijas. Lo que cambia es una API independiente creada para muchas llamadas rápidas y repetidas.
Qué significa para los desarrolladores
- Traslade primero sus llamadas de opción fija. El enrutamiento, la detección de spam, las barreras de seguridad y la elección de herramientas encajan en los tres tipos de respuesta. Deje la escritura y el razonamiento a un modelo normal.
- Use la probabilidad como filtro. Actúe según las respuestas de alta confianza y envíe las de baja confianza a un modelo mayor o a una persona.
- Haga su propia prueba de latencia. La cifra de 150 ms es de OpenAI, sin método publicado. Mídala con su tráfico real antes de rediseñar nada en torno a ella.
- Presupueste solo la entrada. A 0,10 dólares por millón de tokens de entrada y sin coste de salida, el gasto depende de cuántas pruebas envíe. Recorte las instrucciones largas y reduzca el tamaño de las imágenes.
- Codifique primero las imágenes. Las URL de imágenes alojadas se rechazan, así que conviértalas a base64 antes de la llamada.
- Trátela como una beta. Fije la versión de su SDK y mantenga una ruta alternativa hasta la disponibilidad general.
Empiece por reproducir a través de la API un día de decisiones registradas. Después compare sus respuestas con lo que eligió su modelo actual y compruebe con qué frecuencia coinciden.
Fuentes
- Decisions API guide - OpenAI
- OpenAI's Decisions API Promises Routing Answers 10x Faster for Developers - AlphaSignal
- OpenAI Decisions API preview on GPT-6 Luna - XenoSpectrum
Artículos relacionados
La Agents API de OpenAI añade uso del ordenador en un navegador alojado
La Agents API de OpenAI, en beta pública desde el 10 de septiembre, sumó uso del ordenador en el DevDay del 29 de septiembre de 2026: los agentes manejan un navegador alojado por OpenAI.

GPT-6 Astra ya está disponible de forma general en Bedrock y Copilot
GPT-6 Astra está disponible de forma general en Amazon Bedrock a 10 dólares por millón de tokens de entrada, y en GitHub Copilot para los planes Pro+, Max, Business y Enterprise.
Amazon Bedrock Managed Agents para OpenAI entra en vista previa
AWS abrió el 29 de septiembre de 2026 una vista previa pública de Bedrock Managed Agents: agentes con modelos de OpenAI que se ejecutan dentro de su propia cuenta de AWS, en tres regiones de EE. UU.