Nanbeige4.3-33B、エージェント型コーディングでQwenを上回るオープンモデル
BOSS ZhipinのNanbeigeラボが、エージェント型コーディング向けのNanbeige4.3-33BをApache 2.0で公開しました。Terminal-Bench 2.1で80.9を記録し、Qwen3.8-27Bの73.0を上回ったとしています。
4 分で読めます
英語の原文から機械翻訳したものです。原文はClaire Whitmoreが事実確認と編集を行いました。内容に相違がある場合は英語版が優先されます。 編集方針
数字で見る
- parameters, all used for every token
- 33B
- tokens of context
- 524,288
- license, commercial use allowed
- Apache 2.0
- Nanbeige4.3-33B
- 80.9
- Qwen3.8-27B
- 73
- Muse-Glimmer-30B
- 61.8
- Gemma4-31B
- 47.2
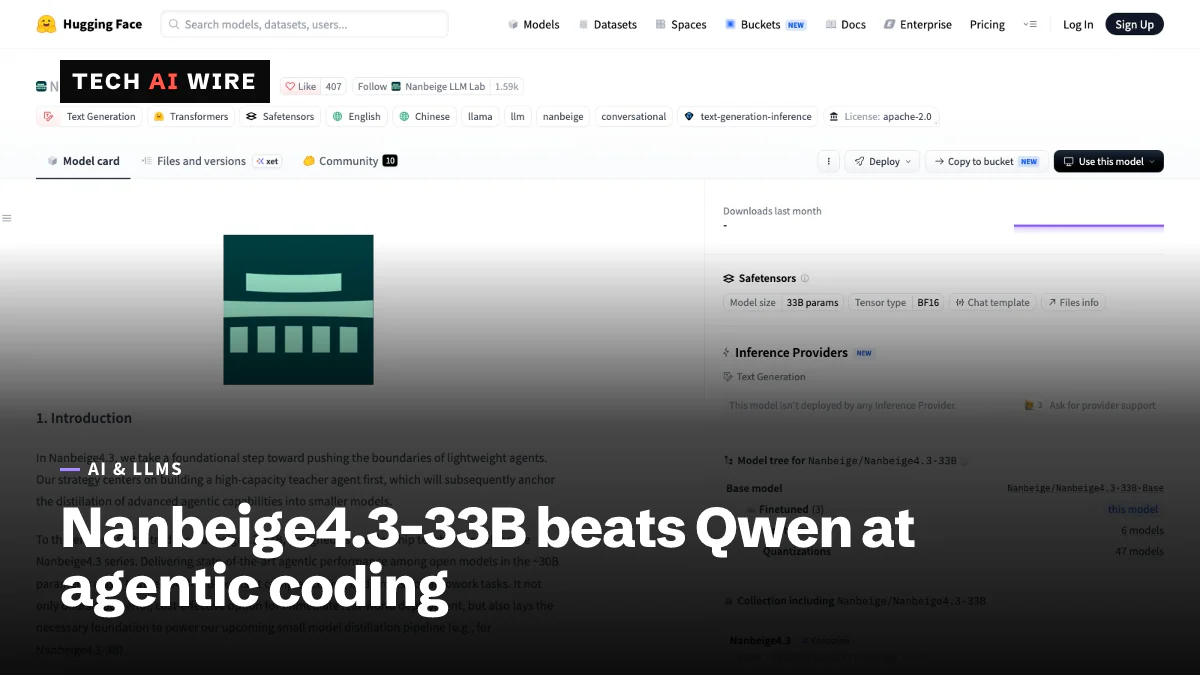
中国の求人プラットフォームBOSS ZhipinのAI研究チームであるNanbeige LLM Labが、Nanbeige4.3-33Bをオープンウェイトとして、Apache 2.0ライセンスで公開しました。重みは、2026年10月24日にHugging Faceで公開されました。同ラボ自身のテストでは、この330億パラメーターのモデルは、エージェント型のコーディングタスクの大半でQwen3.8-27Bを上回っています。
オープンウェイトとは、誰でもモデルのファイルをダウンロードし、自分のハードウェアで実行できることを意味します。Apache 2.0は、わずかな条件で商用利用を認めています。
Nanbeige4.3-33Bとは
Hugging Faceのモデルカードは、これをNanbeige4.3シリーズの「フラッグシップの教師モデル」と呼んでいます。教師モデルとは、より小さなモデルを学習させるために使う大きなモデルのことです。この手法は蒸留と呼ばれます。Data Studiosによると、最初の小型の「生徒」モデルとして、Nanbeige4.3-3Bの名前が挙がっています。その公開日は示されていません。
このモデルは、エージェント型の作業向けに作られています。これは、質問に答えるだけでなく、モデルが手順を計画し、ターミナルやコードエディターなどのツールを呼び出すタスクを指します。モデルカードには、このモデルが「複雑なコーディングとプロフェッショナルな協働タスクに優れている」と書かれています。
モデルカードとData Studiosによる主な事実は、次のとおりです。
- サイズ: 約330億パラメーターの密(dense)な設計です。すべてのパラメーターが、すべてのトークンの処理に使われます。一度に重みの一部しか使わないMixture-of-Expertsモデルとは異なります。
- コンテキスト: 524,288トークンです。一度に読める文章の量を指します。
- 言語: 英語と中国語です。
- 思考モード: 初期設定でオンです。モデルカードは、複数ターンのツール使用やコードエージェントの作業では、それまでの推論を保持するよう勧めています。
Data Studiosによると、Nanbeigeがこれまでに公開したモデルは、いずれも30億パラメーターの小型モデルでした。Startup Fortuneは、この3Bのシリーズが2026年の早い時期に登場したと指摘しています。
ベンチマークの主張
モデルカードは、「約30Bパラメーター級のオープンモデルの中で最先端のエージェント性能」を主張しています。比較対象は、Qwen3.8-27B、Muse-Glimmer-30B、Gemma4-31Bです。
| ベンチマーク | Nanbeige4.3-33B | Qwen3.8-27B | Gemma4-31B |
|---|---|---|---|
| Terminal-Bench 2.1 | 80.9 | 73.0 | 47.2 |
| DeepSWE | 65.5 | 42.5 | 2.7 |
| SWE-Bench Pro | 60.3 | 61.7 | 51.2 |
| NL2Repo | 53.0 | 48.3 | 33.8 |
| Automation Bench | 54.2 | 38.3 | 9.7 |
| JobBench | 44.8 | 34.5 | 9.0 |
| GPQA Diamond | 89.5 | 89.2 | 91.3 |
| AIME 2026 | 95.2 | 94.5 | 89.2 |
Startup Fortuneは、エージェント型コーディングの8つのテストのうち7つで、Qwen3.8-27Bに勝ったと数えています。Qwenは、実際のソフトウェアの問題を修正するテストであるSWE-Bench Proと、GDPvalでリードを保っています。Gemma4-31Bは、大学院レベルの科学クイズであるGPQA Diamondで首位です。
すべての数字は、Nanbeige自身によるものです。Data Studiosは、同ラボがいくつかのテスト設定を調整したため、スコアは公開リーダーボードと直接比較できないと指摘しています。たとえばモデルカードによると、NL2RepoはClaude Codeを通じて実行されました。技術レポートは公開されておらず、学習データも開示されていません。
実行方法
モデルカードには、Transformers、SGLang、vLLM、Docker Model Runner向けのセットアップ手順が載っています。提供の例では、モデルを4つのGPUに分割しています。モデルカードは、必要なGPUメモリーの最小量を示していません。
Data Studiosは、フル精度の重みを約66 GBと見積もっています。また、コンテキストを最大長まで使うと、モデルの作業用キャッシュのために約104 GiBの追加メモリーが必要になると見積もっています。どちらも同メディア独自の計算で、モデルカードの数字ではありません。
量子化を使えば、より小さなハードウェアでも動かせます。量子化とは、数値を少ないビット数で保存して、重みを小さくする手法です。Startup Fortuneによると、4ビット版は24 GBのグラフィックスカード1枚で動きます。ただしその場合、大きなキャッシュのために、実際に使えるコンテキストの量が限られると付け加えています。Hugging Faceには、コミュニティによる47の量子化版が掲載されています。また、Data Studiosが調べた時点では、このモデルを提供するホスト型APIはありませんでした。
開発者にとっての意味
Nanbeige4.3-33Bは、高性能なコーディングエージェントをチームが所有するハードウェアで動かせることを示す、新たな有力な兆しです。その数日前には、Apacheライセンスの40BコーディングモデルであるRecursiveのFlintが公開されていました。
- まず自分のタスクで試す。 スコアは自己申告で、調整した評価環境を使っています。表を信用する前に、実際の課題のサンプルで試しましょう。
- Qwen3.8-27Bと並べて比較する。 既存のコードベースの問題修正に最も近いSWE-Bench Proでは、今もQwenがリードしています。
- 重みだけでなく、コンテキスト用のメモリーも見込む。 24 GBのカードで4ビット版を読み込めます。ただし、長いエージェントのセッションには、キャッシュ用の余裕が必要です。
- モデルカードの設定に従う。 推奨されるサンプリングの値を使いましょう。また、モデルカードがエージェントの作業向けに勧めているとおり、ツール使用時には思考モードを有効にしたままにしましょう。
- ライセンスの連鎖を確認する。 Apache 2.0が適用されるのは、公式の重みです。コミュニティの量子化版は別のアップロードなので、それぞれが同じ条件を保っているかを確認しましょう。
出典
- Nanbeige4.3-33B model card - Hugging Face
- Nanbeige's new 33B open model takes aim at Qwen and Gemma on coding - Startup Fortune
- Nanbeige4.3-33B: Apache 2.0 dense agentic coding model with 512K context and benchmarks - Data Studios
関連記事
Kimi K3.1 Pro、コーディングでOpus 5.5に迫る、サイバー能力は削減
MoonshotのKimi(キミ)K3.1 Proは、Terminal-Bench 4.0で65.7%を記録し、Claude Opus 5.5との差は1ポイントでした。重みは11月4日までに公開予定で、サイバー関連のデータは除去されています。
Reflection Beamのオープンウェイトが公開、ライセンスはApache 2.0
Reflection(リフレクション)は2026年10月16日、5010億パラメーターのBeamの重みをApache 2.0でHugging Faceに公開しました。FP8版と4ビット版は、8基のGPUを積んだサーバー1台に収まります。
NVIDIA Kumo Tabular、オープンウェイトでTabArena首位に
NVIDIAのKumo Tabularは、ラベル付きの表形式データ(タブラーデータ)から1回の処理で予測し、学習の実行は不要です。TabArenaでは1,950 Eloで首位に立ち、サイズは28Mから215Mまでです。