Reflection Beamのオープンウェイトが公開、ライセンスはApache 2.0
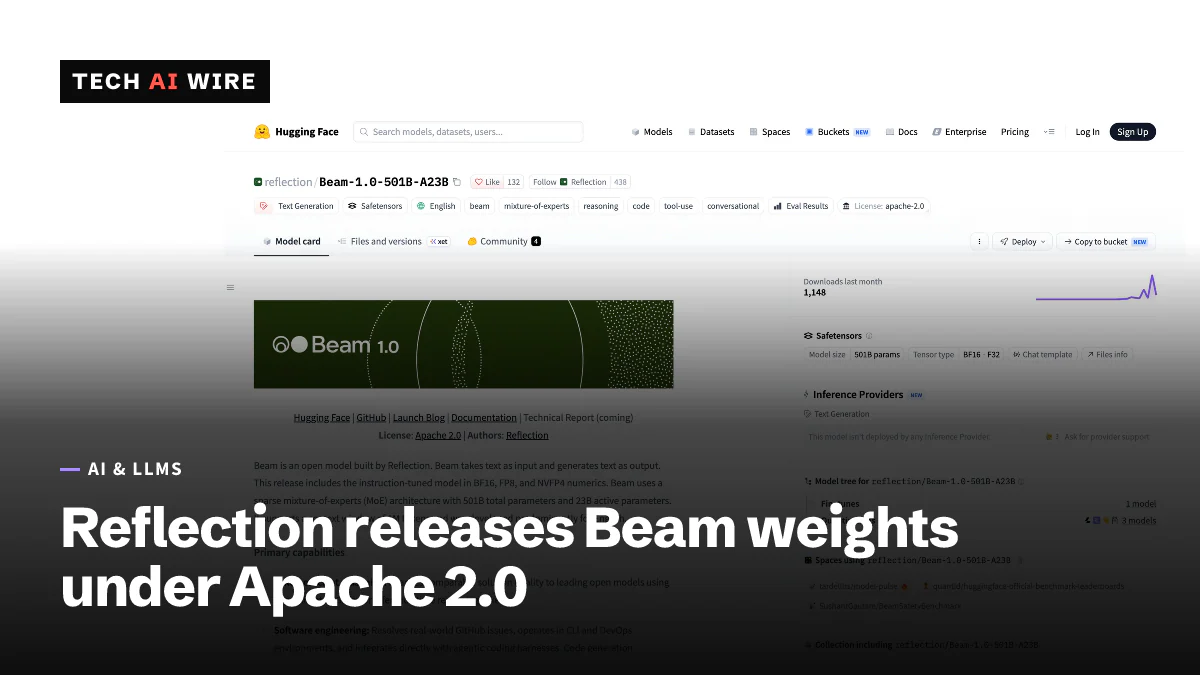
Reflection(リフレクション)は2026年10月16日、5010億パラメーターのBeamの重みをApache 2.0でHugging Faceに公開しました。FP8版と4ビット版は、8基のGPUを積んだサーバー1台に収まります。
4 分で読めます
数字で見る
- total parameters, 23B active per token
- 501B
- token context window
- 1M
- enough for the FP8 and 4-bit versions
- 8 GPUs
- Terminal-Bench 2.1 score, BF16
- 80.1
- DeepSeek V4.1 Flash
- 90.6%
- Kimi K3
- 85%
- Reflection Beam
- 80.1%
- Muse Spark Open
- 76.4%
Reflectionは2026年10月16日、5010億パラメーターのAIモデルBeamの重みを、Apache 2.0ライセンスでHugging Faceに公開しました。Apache 2.0では、誰でもこのモデルを使い、改変し、それを基にした製品を販売できます。条件はわずかです。これによりBeamは、独自のライセンス条件が付かないモデルとして最大級のものの1つになります。圧縮版は、8基のGPUを積んだサーバー1台に収まります。
今回の公開は、Reflectionが10月5日にBeamを発表したときの約束を果たすものです。当時、重みは「今月中」に公開される予定でした。「Beamは当社初のオープンウェイトモデルです」と、同社はリリースの投稿に書いています。
Reflectionが公開したもの
Beamは、スパースなミクスチャー・オブ・エキスパート(MoE)モデルです。パラメーターは多数の小さなエキスパートネットワークに分かれており、トークンごとに動くのはそのうちのごく一部です。トークンとは、単語または単語の一部のことです。Hugging Faceのモデルカードには、次の詳細が記載されています。
| 仕様 | Beam-1.0-501B-A23B |
|---|---|
| 総パラメーター数 | 5013億 |
| トークンあたりのアクティブ数 | 234億 |
| エキスパートとレイヤー | エキスパート256個、レイヤー52層 |
| コンテキストウィンドウ | 100万トークン |
| 入力 | テキストのみ、主に英語 |
| 重みの形式 | BF16、FP8、NVFP4 |
| ライセンス | Apache 2.0 |
モデルカードによると、これは指示チューニング済みのモデルです。つまり、依頼に従うよう学習させた版です。Reflectionは、投機的デコーディング用の小さなドラフトモデルも公開しました。投機的デコーディングは、テキスト生成を速める手法です。同社はさらに、融合カーネル、複数のサービング用プログラム向けの既成の設定、Beam Safety Technical Reportも加えました。完全な技術レポートは、まだ「近日公開」とされています。SiliconANGLEによると、自己蒸留のレシピは「今後数日のうちに」続きます。
VentureBeatによると、Reflectionは、ターミナルで動くコーディングエージェントのMirror CLIも公開しました。同社はこのパッケージ全体を「エージェントのためのオープンなオペレーティングシステム」と呼んでいます。
圧縮版のスコア
量子化とは、モデルの数値を少ないビット数で保存することです。メモリを減らせる代わりに、精度がいくらか落ちます。Reflection自身のテストでは、その低下はわずかです。
| ベンチマーク | BF16 | FP8 | NVFP4 |
|---|---|---|---|
| SWE-bench Verified | 81.6 | 80.2 | 80.7 |
| SWE-Bench Pro v1 | 66.1 | 65.9 | 65.6 |
| Terminal-Bench 2.1 | 80.1 | 78.9 | 78.4 |
| GPQA Diamond | 90.6 | 90.3 | 89.3 |
| LiveCodeBench | 88.3 | 88.1 | 87.4 |
VentureBeatによると、8ビット版と4ビット版は、H100、H200、GB300のいずれかのGPUを8基積んだサーバー1台に収まります。完全な16ビット版には「数十基のGPU」が必要です。
競合と比べると、Beamはトップではありません。グラフは、VentureBeatがまとめたTerminal-Bench 2.1の数字を示しています。首位はDeepSeekのV4.1 Flashで90.6となり、Beamの80.1を上回ります。Beamは、76.4だったMetaのMuse Spark Openを上回っています。
売り文句は「少ないトークン」
Reflectionの主張は、素のスコアではなく効率に基づいています。同社によると、Beamは高度な推論でGLM-5.2に並びながら、インファレンスの計算量は3〜4分の1で済みます。この数字にプロンプトの処理は含まれません。このモデルは、より少ない推論トークンで答えにたどり着くよう学習されています。
「何もあきらめる必要はありません。使えるトークン数の面でペナルティを課すだけです」と、Reflectionの共同創業者でCTOのIoannis AntonoglouはVentureBeatに語りました。VentureBeatの推計では、Muse Spark Openはトークンあたり、Beamの約1.8倍の計算量を使います。
Reflectionは価格を決めていません。同社によると、プラットフォームのベータ版は「無料で始められ」ます。40社を超えるローンチパートナーも挙げています。DellとHPEは、顧客自身のハードウェアにBeamを導入します。
今回の公開に先立ち、Financial Timesは10月10日、NvidiaがReflectionの買収または追加出資について初期段階の協議をしていると報じました。VentureBeatによると、Antonoglouはこれを「根拠のないうわさ」と呼びましたが、協議の有無は肯定も否定もしませんでした。彼はNvidiaを「緊密なパートナーであり投資家」と表現しました。
開発者にとっての意味
- まずFP8かNVFP4から始めること。 Reflectionの数字では、圧縮版と完全精度の差は約2ポイント以内です。圧縮版は、複数サーバーのクラスターではなく、8基のGPUを積んだサーバー1台に収まります。
- トークン単価ではなく、タスクあたりのトークン数を数えること。 Reflectionの主張は、Beamが少ないトークンで答えにたどり着くというものです。それを確かめるには、自分のタスクで総トークン数と時間を測ってください。節約があるとすれば、そこに表れるからです。
- ライセンスは簡単な部分です。 Apache 2.0には、売上の上限も独自条件もありません。Muse Spark Openのような独自ライセンスのモデルに比べ、法務レビューは短く済むはずです。
- スコアはベンダーの数字として扱うこと。 ここにあるベンチマークはすべて、Reflectionかモデルカードによるものです。重みが公開されたので、独立したテストを始められるようになりました。
- 続報に注目すること。 完全な技術レポートと自己蒸留のレシピは、まだこれからです。報じられたNvidiaとの協議の行方も同様です。その結果次第で、モデルのロードマップを誰が握るかが変わる可能性があります。
出典
- Beam is now available - Reflection
- reflection/Beam-1.0-501B-A23B model card - Hugging Face
- Reflection's Beam aims to undercut Chinese open models with fewer tokens, not cheaper tokens - VentureBeat
- Reflection AI open-sources Beam's weights, post-training recipes - SiliconANGLE
関連記事
StepFun Step 5 Preview:エージェント向けの600Bオープンウェイトモデル
StepFun(ステップファン)のStep 5 Previewが、Hugging Faceで公開されました。600Bパラメータのうち27Bがアクティブで、コンテキストは1Mトークンです。それまでの1か月はAPI専用で、価格は100万トークンあたり1ドル/2.70ドルでした。
Reflection AI、5010億パラメーターのオープンウェイトモデル「Beam」を発表
Reflection AIのオープンウェイト(open-weight)モデルBeamは5010億パラメーターを持つが、1トークンあたりに使うのは230億だ。SWE-Bench Verifiedで80.9を記録し、重みは10月中にApache 2.0で公開される。
Ling-3.1-flash、Ant Groupが560BモデルをMITライセンスで公開
Ant Group(アント・グループ)のinclusionAIが、Ling-3.1-flashの重みをMITライセンスで公開しました。パラメータは560B、うち1トークンあたり25Bがアクティブで、コンテキストは100万トークンです。