Nanbeige4.3-33B: modelo aberto supera o Qwen em programação com agentes
O laboratório Nanbeige, da BOSS Zhipin, lançou o Nanbeige4.3-33B sob Apache 2.0 e afirma ter 80,9 no Terminal-Bench 2.1, contra 73,0 do Qwen3.8-27B.
Por Claire Whitmore
4 min de leitura
Traduzido automaticamente do original em inglês, que Claire Whitmore verificou e editou. Prevalece a versão em inglês. Como trabalhamos
Em números
- parameters, all used for every token
- 33B
- tokens of context
- 524,288
- license, commercial use allowed
- Apache 2.0
- Nanbeige4.3-33B
- 80.9
- Qwen3.8-27B
- 73
- Muse-Glimmer-30B
- 61.8
- Gemma4-31B
- 47.2
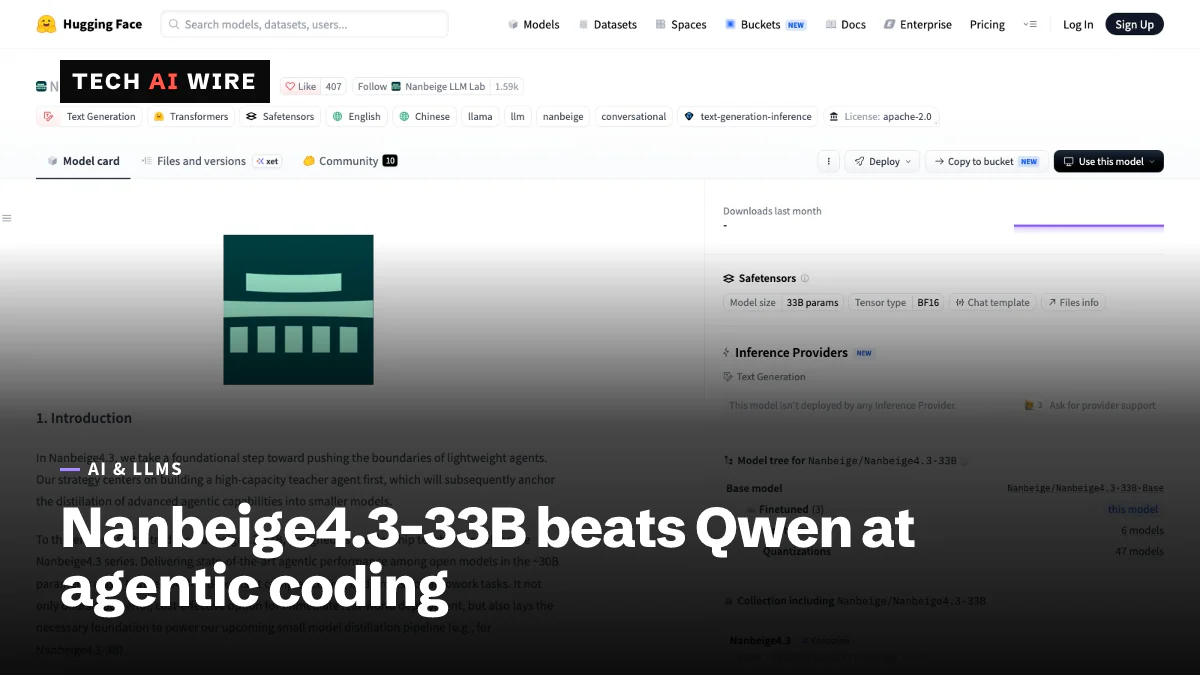
O Nanbeige LLM Lab, equipe de pesquisa em IA da plataforma chinesa de recrutamento BOSS Zhipin, lançou o Nanbeige4.3-33B com pesos abertos sob a licença Apache 2.0. Os pesos foram publicados no Hugging Face em 24 de outubro de 2026. Nos testes do próprio laboratório, o modelo de 33 bilhões de parâmetros supera o Qwen3.8-27B na maioria das tarefas de programação no estilo de agentes.
Pesos abertos significa que qualquer pessoa pode baixar os arquivos do modelo e rodá-los no próprio hardware. A Apache 2.0 permite uso comercial com poucas condições.
O que é o Nanbeige4.3-33B
O cartão do modelo no Hugging Face o chama de "modelo professor carro-chefe" da série Nanbeige4.3. Um modelo professor é um modelo grande usado para treinar modelos menores, um processo chamado destilação. A Data Studios informa que o Nanbeige4.3-3B é apontado como o primeiro modelo "aluno" menor. Nenhuma data foi informada para ele.
O modelo foi feito para trabalho agêntico. Isso significa tarefas em que o modelo planeja etapas e chama ferramentas, como um terminal ou um editor de código, em vez de apenas responder a uma pergunta. O cartão diz que ele "se destaca em tarefas complexas de programação e de cowork profissional".
Principais dados do cartão e da Data Studios:
- Tamanho: cerca de 33 bilhões de parâmetros em um design denso. Todo parâmetro trabalha em todo token, ao contrário dos modelos de mistura de especialistas (mixture-of-experts), que usam só parte de seus pesos de cada vez.
- Contexto: 524.288 tokens, a quantidade de texto que ele consegue ler de uma vez.
- Idiomas: inglês e chinês.
- Modo de raciocínio: ativado por padrão. O cartão recomenda manter o raciocínio anterior no uso de ferramentas com vários turnos e no trabalho de agentes de código.
Os modelos públicos anteriores da Nanbeige eram todos pequenos, lançamentos de 3 bilhões de parâmetros, diz a Data Studios. A Startup Fortune observa que a linha 3B saiu no início de 2026.
As alegações de benchmark
O cartão afirma "desempenho agêntico de ponta entre modelos abertos na classe de ~30B parâmetros". Ele compara o modelo com o Qwen3.8-27B, o Muse-Glimmer-30B e o Gemma4-31B.
| Benchmark | Nanbeige4.3-33B | Qwen3.8-27B | Gemma4-31B |
|---|---|---|---|
| Terminal-Bench 2.1 | 80,9 | 73,0 | 47,2 |
| DeepSWE | 65,5 | 42,5 | 2,7 |
| SWE-Bench Pro | 60,3 | 61,7 | 51,2 |
| NL2Repo | 53,0 | 48,3 | 33,8 |
| Automation Bench | 54,2 | 38,3 | 9,7 |
| JobBench | 44,8 | 34,5 | 9,0 |
| GPQA Diamond | 89,5 | 89,2 | 91,3 |
| AIME 2026 | 95,2 | 94,5 | 89,2 |
A Startup Fortune contabiliza vitórias sobre o Qwen3.8-27B em sete de oito testes de programação agêntica. O Qwen continua à frente no SWE-Bench Pro, um teste de correção de problemas reais de software, e no GDPval. O Gemma4-31B lidera no GPQA Diamond, um teste de ciências de nível de pós-graduação.
Todos os números são da própria Nanbeige. A Data Studios aponta que o laboratório adaptou várias configurações de teste, então as pontuações não se alinham diretamente com os rankings públicos. Por exemplo, o cartão diz que o NL2Repo foi executado por meio do Claude Code. Nenhum relatório técnico foi publicado, e os dados de treinamento não foram divulgados.
Como rodar
O cartão traz receitas de configuração para Transformers, SGLang, vLLM e Docker Model Runner. Seus exemplos de serviço dividem o modelo entre quatro GPUs. O cartão não informa uma quantidade mínima de memória de GPU.
A Data Studios estima os pesos em precisão total em cerca de 66 GB. Também estima que um contexto de comprimento total precisaria de cerca de 104 GiB de memória extra para o cache de trabalho do modelo. Os dois são cálculos do próprio veículo, não números do cartão.
É possível usar hardware menor com quantização, que reduz os pesos ao armazenar números com menos bits. A Startup Fortune informa que uma versão de 4 bits roda em uma única placa de vídeo de 24 GB. O veículo acrescenta que, nesse caso, o grande cache limita quanto contexto você consegue de fato usar. O Hugging Face lista 47 quantizações da comunidade, e a Data Studios não encontrou nenhuma API hospedada servindo o modelo naquele momento.
O que isso significa para desenvolvedores
O Nanbeige4.3-33B é mais um sinal forte de que agentes de programação capazes podem rodar em hardware que a própria equipe possui. Ele vem depois do Flint, da Recursive, um modelo de programação de 40B com licença Apache lançado dias antes.
- Teste primeiro nas suas próprias tarefas. As pontuações são autodeclaradas e usam harnesses adaptados. Rode o modelo em uma amostra dos seus problemas reais antes de confiar na tabela.
- Compare lado a lado com o Qwen3.8-27B. O Qwen ainda lidera no SWE-Bench Pro, que é o mais próximo de corrigir problemas em uma base de código existente.
- Reserve memória para o contexto, não só para os pesos. Uma placa de 24 GB consegue carregar uma cópia de 4 bits, mas sessões longas de agentes precisam de espaço para o cache.
- Siga as configurações do cartão. Use os valores de amostragem recomendados e mantenha o modo de raciocínio ativado no uso de ferramentas, como o cartão recomenda para trabalho de agentes.
- Verifique a cadeia de licenças. A Apache 2.0 cobre os pesos oficiais. Quantizações da comunidade são uploads separados, então confirme que cada uma mantém os mesmos termos.
Fontes
- Nanbeige4.3-33B model card - Hugging Face
- Nanbeige's new 33B open model takes aim at Qwen and Gemma on coding - Startup Fortune
- Nanbeige4.3-33B: Apache 2.0 dense agentic coding model with 512K context and benchmarks - Data Studios
Artigos relacionados
Kimi K3.1 Pro chega perto do Opus 5.5 em código e corta habilidades cibernéticas
O Kimi K3.1 Pro, da Moonshot, marca 65,7% no Terminal-Bench 4.0, a um ponto do Claude Opus 5.5. Os pesos devem sair até 4 de novembro, sem os dados cibernéticos.
Pesos abertos do Reflection Beam chegam sob Apache 2.0
A Reflection publicou os pesos do Beam, com 501 bilhões de parâmetros, no Hugging Face em 16 de outubro de 2026, sob Apache 2.0. As versões FP8 e de 4 bits cabem em um servidor com 8 GPUs.
NVIDIA Kumo Tabular lidera o TabArena com pesos abertos
O Kumo Tabular da NVIDIA faz previsões a partir de uma tabela rotulada em uma única passada, sem nenhum treinamento. Ele fica em primeiro no TabArena com 1.950 de Elo, em tamanhos de 28M a 215M.