Nanbeige4.3-33B, un modelo abierto que supera a Qwen en programación con agentes
El laboratorio Nanbeige de BOSS Zhipin lanzó Nanbeige4.3-33B bajo Apache 2.0 y afirma lograr 80,9 en Terminal-Bench 2.1, frente a 73,0 de Qwen3.8-27B.
Por Claire Whitmore
4 min de lectura
Traducido automáticamente del original en inglés, que Claire Whitmore verificó y editó. Prevalece la versión en inglés. Cómo trabajamos
En cifras
- parameters, all used for every token
- 33B
- tokens of context
- 524,288
- license, commercial use allowed
- Apache 2.0
- Nanbeige4.3-33B
- 80.9
- Qwen3.8-27B
- 73
- Muse-Glimmer-30B
- 61.8
- Gemma4-31B
- 47.2
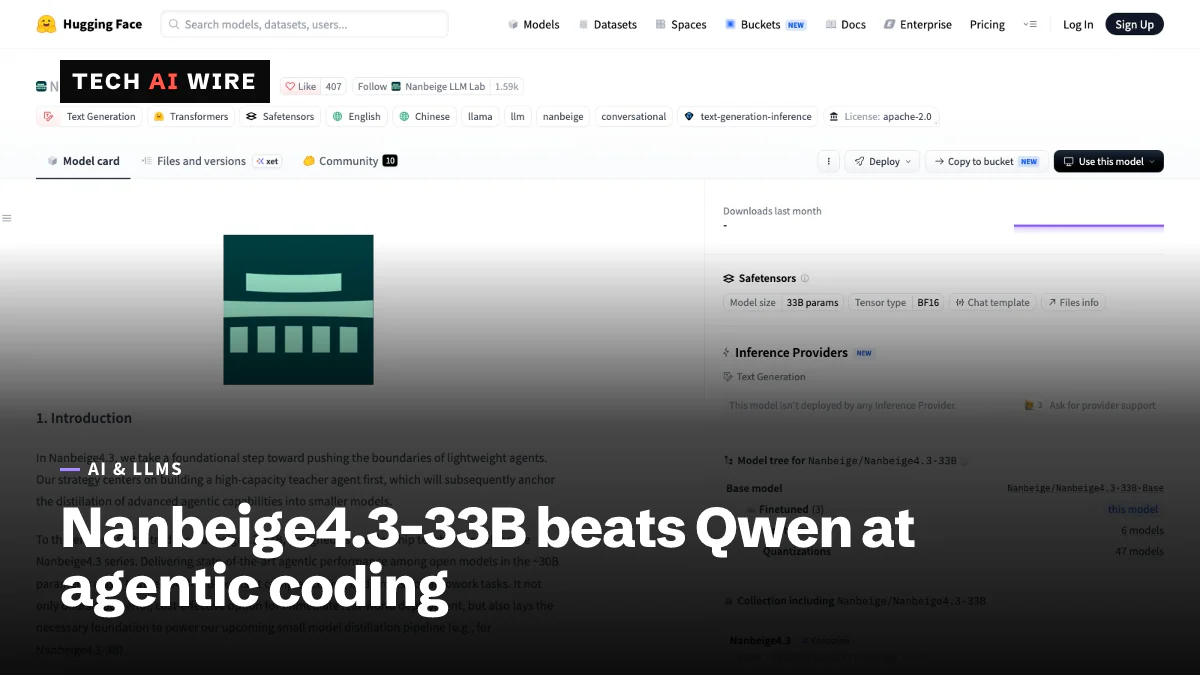
Nanbeige LLM Lab, el equipo de investigación en IA de la plataforma china de empleo BOSS Zhipin, ha lanzado Nanbeige4.3-33B como modelo de pesos abiertos bajo la licencia Apache 2.0. Los pesos se publicaron en Hugging Face el 24 de octubre de 2026. En las pruebas del propio laboratorio, el modelo de 33.000 millones de parámetros supera a Qwen3.8-27B en la mayoría de las tareas de programación de tipo agente.
Pesos abiertos significa que cualquiera puede descargar los archivos del modelo y ejecutarlos en su propio hardware. Apache 2.0 permite el uso comercial con pocas condiciones.
Qué es Nanbeige4.3-33B
La ficha del modelo en Hugging Face lo llama el «modelo maestro insignia» de la serie Nanbeige4.3. Un modelo maestro es un modelo grande que se usa para entrenar otros más pequeños, un proceso llamado destilación. Data Studios informa de que Nanbeige4.3-3B figura como el primer modelo «alumno» más pequeño. No se ha dado fecha para él.
El modelo está pensado para el trabajo agéntico. Es decir, tareas en las que el modelo planifica pasos y llama a herramientas, como un terminal o un editor de código, en lugar de solo responder a una pregunta. La ficha dice que «sobresale en tareas complejas de programación y de trabajo profesional colaborativo».
Datos clave de la ficha y de Data Studios:
- Tamaño: unos 33.000 millones de parámetros en un diseño denso. Cada parámetro trabaja en cada token, a diferencia de los modelos de mezcla de expertos (mixture-of-experts), que solo usan una parte de sus pesos cada vez.
- Contexto: 524.288 tokens, la cantidad de texto que puede leer de una vez.
- Idiomas: inglés y chino.
- Modo de razonamiento: activado por defecto. La ficha recomienda conservar el razonamiento anterior en el uso de herramientas de varios turnos y en el trabajo de agentes de código.
Los modelos públicos anteriores de Nanbeige eran todos pequeños, de 3.000 millones de parámetros, dice Data Studios. Startup Fortune señala que la línea 3B salió a principios de 2026.
Las cifras de los benchmarks
La ficha afirma un «rendimiento agéntico de vanguardia entre los modelos abiertos de la clase de ~30B parámetros». Compara el modelo con Qwen3.8-27B, Muse-Glimmer-30B y Gemma4-31B.
| Benchmark | Nanbeige4.3-33B | Qwen3.8-27B | Gemma4-31B |
|---|---|---|---|
| Terminal-Bench 2.1 | 80,9 | 73,0 | 47,2 |
| DeepSWE | 65,5 | 42,5 | 2,7 |
| SWE-Bench Pro | 60,3 | 61,7 | 51,2 |
| NL2Repo | 53,0 | 48,3 | 33,8 |
| Automation Bench | 54,2 | 38,3 | 9,7 |
| JobBench | 44,8 | 34,5 | 9,0 |
| GPQA Diamond | 89,5 | 89,2 | 91,3 |
| AIME 2026 | 95,2 | 94,5 | 89,2 |
Startup Fortune cuenta una victoria sobre Qwen3.8-27B en siete de ocho pruebas de programación agéntica. Qwen sigue por delante en SWE-Bench Pro, una prueba de corrección de incidencias reales de software, y en GDPval. Gemma4-31B lidera en GPQA Diamond, un cuestionario de ciencia de nivel de posgrado.
Todas las cifras son del propio Nanbeige. Data Studios señala que el laboratorio adaptó varias configuraciones de prueba, así que las puntuaciones no se corresponden directamente con las clasificaciones públicas. Por ejemplo, la ficha dice que NL2Repo se ejecutó a través de Claude Code. No se ha publicado ningún informe técnico, y los datos de entrenamiento no se han revelado.
Cómo ejecutarlo
La ficha ofrece recetas de instalación para Transformers, SGLang, vLLM y Docker Model Runner. Sus ejemplos de despliegue reparten el modelo entre cuatro GPU. La ficha no indica una cantidad mínima de memoria de GPU.
Data Studios calcula que los pesos en precisión completa ocupan unos 66 GB. También calcula que un contexto de longitud completa necesitaría unos 104 GiB de memoria adicional para la caché de trabajo del modelo. Ambos son cálculos del propio medio, no cifras de la ficha.
Se puede usar hardware más pequeño con cuantización, que reduce los pesos al almacenar los números con menos bits. Startup Fortune informa de que una versión de 4 bits funciona en una sola tarjeta gráfica de 24 GB. Añade que la gran caché limita entonces cuánto contexto se puede usar en la práctica. Hugging Face enumera 47 cuantizaciones de la comunidad, y Data Studios no encontró ninguna API alojada que sirviera el modelo en ese momento.
Qué significa para los desarrolladores
Nanbeige4.3-33B es otra señal clara de que los agentes de programación capaces pueden funcionar en hardware propiedad de un equipo. Llega después de Flint de Recursive, un modelo de programación de 40B con licencia Apache publicado días antes.
- Pruébalo primero en tus propias tareas. Las puntuaciones son autodeclaradas y usan entornos de prueba adaptados. Ejecútalo con una muestra de tus incidencias reales antes de fiarte de la tabla.
- Compáralo en paralelo con Qwen3.8-27B. Qwen sigue liderando en SWE-Bench Pro, que es lo más parecido a corregir incidencias en un código existente.
- Reserva memoria para el contexto, no solo para los pesos. Una tarjeta de 24 GB puede cargar una copia de 4 bits, pero las sesiones largas de agentes necesitan espacio para la caché.
- Sigue los ajustes de la ficha. Usa los valores de muestreo recomendados y mantén el razonamiento activado para el uso de herramientas, como recomienda la ficha para el trabajo con agentes.
- Revisa la cadena de licencias. Apache 2.0 cubre los pesos oficiales. Las cuantizaciones de la comunidad son subidas aparte, así que confirma que cada una mantiene las mismas condiciones.
Fuentes
- Nanbeige4.3-33B model card - Hugging Face
- Nanbeige's new 33B open model takes aim at Qwen and Gemma on coding - Startup Fortune
- Nanbeige4.3-33B: Apache 2.0 dense agentic coding model with 512K context and benchmarks - Data Studios
Artículos relacionados
Kimi K3.1 Pro se acerca a Opus 5.5 en programación y recorta sus capacidades cibernéticas
Kimi K3.1 Pro de Moonshot logra un 65,7% en Terminal-Bench 4.0, a un punto de Claude Opus 5.5. Sus pesos llegarán a más tardar el 4 de noviembre, sin los datos cibernéticos.
Los pesos abiertos de Reflection Beam llegan bajo Apache 2.0
Reflection publicó en Hugging Face los pesos de Beam, con 501.000 millones de parámetros, el 16 de octubre de 2026 bajo Apache 2.0. Las versiones FP8 y de 4 bits caben en un servidor de 8 GPU.
NVIDIA Kumo Tabular encabeza TabArena con pesos abiertos
Kumo Tabular de NVIDIA predice a partir de una tabla etiquetada en una sola pasada, sin ningún entrenamiento. Ocupa el primer puesto en TabArena con 1.950 Elo, en tamaños de 28M a 215M.