Les poids ouverts de Reflection Beam arrivent sous Apache 2.0
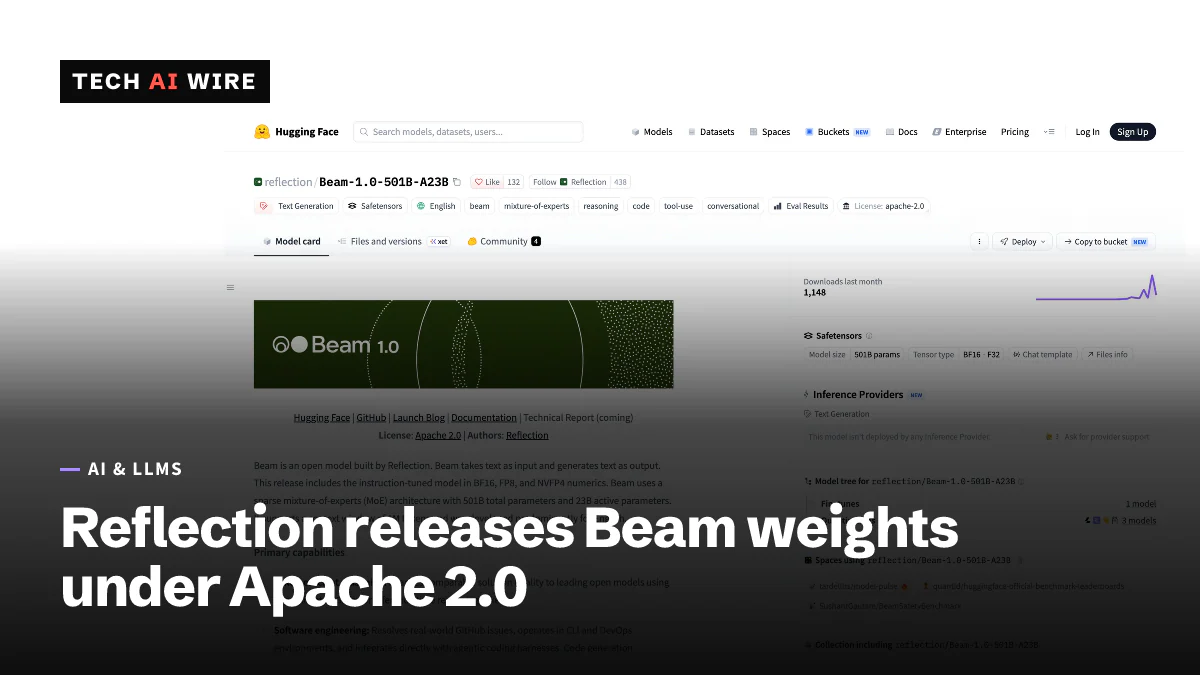
Reflection a publié les poids de Beam, un modèle de 501 milliards de paramètres, sur Hugging Face le 16 octobre 2026, sous Apache 2.0. Les versions FP8 et 4 bits tiennent sur un seul serveur à 8 GPU.
4 min de lecture
En chiffres
- total parameters, 23B active per token
- 501B
- token context window
- 1M
- enough for the FP8 and 4-bit versions
- 8 GPUs
- Terminal-Bench 2.1 score, BF16
- 80.1
- DeepSeek V4.1 Flash
- 90.6%
- Kimi K3
- 85%
- Reflection Beam
- 80.1%
- Muse Spark Open
- 76.4%
Reflection a publié le 16 octobre 2026 sur Hugging Face les poids de Beam, son modèle d'IA de 501 milliards de paramètres, sous licence Apache 2.0. Apache 2.0 permet à chacun d'utiliser le modèle, de le modifier et de vendre des produits qui en sont tirés, avec peu de conditions. Beam devient ainsi l'un des plus grands modèles disponibles sans conditions de licence sur mesure. Ses versions compressées tiennent sur un seul serveur à huit GPU.
Cette sortie tient la promesse que Reflection avait faite en annonçant Beam le 5 octobre. Les poids étaient alors attendus « plus tard ce mois-ci ». « Beam est notre premier modèle à poids ouverts », a écrit l'entreprise dans son billet de lancement.
Ce que Reflection a publié
Beam est un modèle à mélange d'experts (MoE) clairsemé. Ses paramètres sont répartis entre de nombreux réseaux experts plus petits, et seuls quelques-uns tournent pour chaque jeton, c'est-à-dire un mot ou une partie de mot. La fiche du modèle sur Hugging Face en donne le détail :
| Caractéristique | Beam-1.0-501B-A23B |
|---|---|
| Paramètres au total | 501,3 milliards |
| Actifs par jeton | 23,4 milliards |
| Experts et couches | 256 experts, 52 couches |
| Fenêtre de contexte | 1 million de jetons |
| Entrée | Texte uniquement, surtout en anglais |
| Formats des poids | BF16, FP8 et NVFP4 |
| Licence | Apache 2.0 |
La fiche présente ce modèle comme la version ajustée aux instructions, celle qui est entraînée pour suivre des demandes. Reflection a aussi livré un modèle brouillon plus petit pour le décodage spéculatif, une technique qui accélère la génération de texte. Elle a ajouté des noyaux fusionnés, des réglages prêts à l'emploi pour plusieurs logiciels de service de modèles et un Beam Safety Technical Report. Un rapport technique complet est toujours annoncé comme à venir. Les recettes d'autodistillation suivront « dans les prochains jours », rapporte SiliconANGLE.
Reflection a aussi publié Mirror CLI, un agent de codage qui tourne dans un terminal, rapporte VentureBeat. L'entreprise qualifie l'ensemble de « système d'exploitation ouvert pour les agents ».
Les scores des versions compressées
La quantification stocke les nombres d'un modèle sur moins de bits. Elle réduit la mémoire nécessaire, au prix d'une certaine perte de précision. Selon les propres tests de Reflection, cette perte est faible :
| Benchmark | BF16 | FP8 | NVFP4 |
|---|---|---|---|
| SWE-bench Verified | 81,6 | 80,2 | 80,7 |
| SWE-Bench Pro v1 | 66,1 | 65,9 | 65,6 |
| Terminal-Bench 2.1 | 80,1 | 78,9 | 78,4 |
| GPQA Diamond | 90,6 | 90,3 | 89,3 |
| LiveCodeBench | 88,3 | 88,1 | 87,4 |
Les versions 8 bits et 4 bits tiennent sur un seul serveur de huit GPU H100, H200 ou GB300, rapporte VentureBeat. La version complète en 16 bits demande « des dizaines de GPU ».
Face à ses rivaux, Beam n'obtient pas le meilleur score. Le graphique montre les chiffres de Terminal-Bench 2.1 compilés par VentureBeat. V4.1 Flash de DeepSeek arrive en tête avec 90,6, devant les 80,1 de Beam. Beam devance Muse Spark Open de Meta, qui a obtenu 76,4.
L'argument : moins de jetons
L'argumentaire de Reflection repose sur l'efficacité, pas sur les scores bruts. L'entreprise affirme que Beam égale GLM-5.2 en raisonnement avancé tout en utilisant trois à quatre fois moins de calcul d'inférence, sans compter le traitement des prompts. Le modèle est entraîné à atteindre ses réponses avec moins de jetons de raisonnement.
« Vous ne renoncez à rien. Vous le pénalisez simplement en fonction du nombre de jetons qu'il peut utiliser », a déclaré à VentureBeat Ioannis Antonoglou, cofondateur et CTO de Reflection. VentureBeat estime que Muse Spark Open utilise environ 1,8 fois le calcul de Beam par jeton.
Reflection n'a pas fixé de prix. La bêta de sa plateforme est « gratuite pour commencer », selon l'entreprise. Elle cite plus de 40 partenaires de lancement. Dell et HPE installeront Beam sur le propre matériel des clients.
Cette sortie fait suite à un article du Financial Times du 10 octobre. Selon lui, Nvidia mène des discussions préliminaires pour racheter Reflection ou y investir davantage. Antonoglou a parlé de « rumeurs sans fondement », sans confirmer ni démentir de discussions, rapporte VentureBeat. Il a décrit Nvidia comme « un partenaire et un investisseur proche ».
Ce que cela signifie pour les développeurs
- Commencez par FP8 ou NVFP4. Les chiffres de Reflection placent les versions compressées à environ deux points de la pleine précision. Elles tiennent sur un seul serveur à huit GPU au lieu d'un cluster de plusieurs serveurs.
- Comptez les jetons par tâche, pas le prix par jeton. Reflection affirme que Beam atteint ses réponses avec moins de jetons. Mesurez le total de jetons et le temps sur vos propres tâches pour le vérifier, car c'est là qu'une éventuelle économie apparaît.
- La licence est la partie simple. Apache 2.0 n'impose ni plafond de revenus ni conditions sur mesure. L'examen juridique devrait être plus court que pour les modèles sous licence sur mesure, comme celle de Muse Spark Open.
- Traitez les scores comme des chiffres de l'éditeur. Chaque benchmark cité ici vient de Reflection ou d'une fiche de modèle. Des tests indépendants peuvent désormais commencer, car les poids sont publics.
- Surveillez la suite. Le rapport technique complet et les recettes d'autodistillation restent à venir. Tout comme l'issue des discussions rapportées avec Nvidia, qui pourrait changer qui contrôle la feuille de route du modèle.
Sources
- Beam is now available - Reflection
- reflection/Beam-1.0-501B-A23B model card - Hugging Face
- Reflection's Beam aims to undercut Chinese open models with fewer tokens, not cheaper tokens - VentureBeat
- Reflection AI open-sources Beam's weights, post-training recipes - SiliconANGLE
Articles liés
StepFun Step 5 Preview : un modèle pour agents de 600B à poids ouverts
Step 5 Preview de StepFun, un modèle de 600B paramètres dont 27B actifs, avec un contexte de 1M de tokens, arrive sur Hugging Face après un mois limité à l'API, à 1 $/2,70 $ par million.
Reflection AI lance Beam, un modèle à poids ouverts de 501 milliards de paramètres
Beam, de Reflection AI, compte 501 milliards de paramètres mais en utilise 23 milliards par jeton, obtient 80,9 sur SWE-Bench Verified et verra ses poids publiés sous Apache 2.0 plus tard en octobre.
Ling-3.1-flash : Ant Group ouvre un modèle de 560B sous licence MIT
L'équipe inclusionAI d'Ant Group a publié les poids de Ling-3.1-flash sous licence MIT : 560B paramètres, dont 25B actifs par token, et un contexte de 1M de tokens.