FLUX 3 Image Klein sort en modèle à poids ouverts de 5,6B
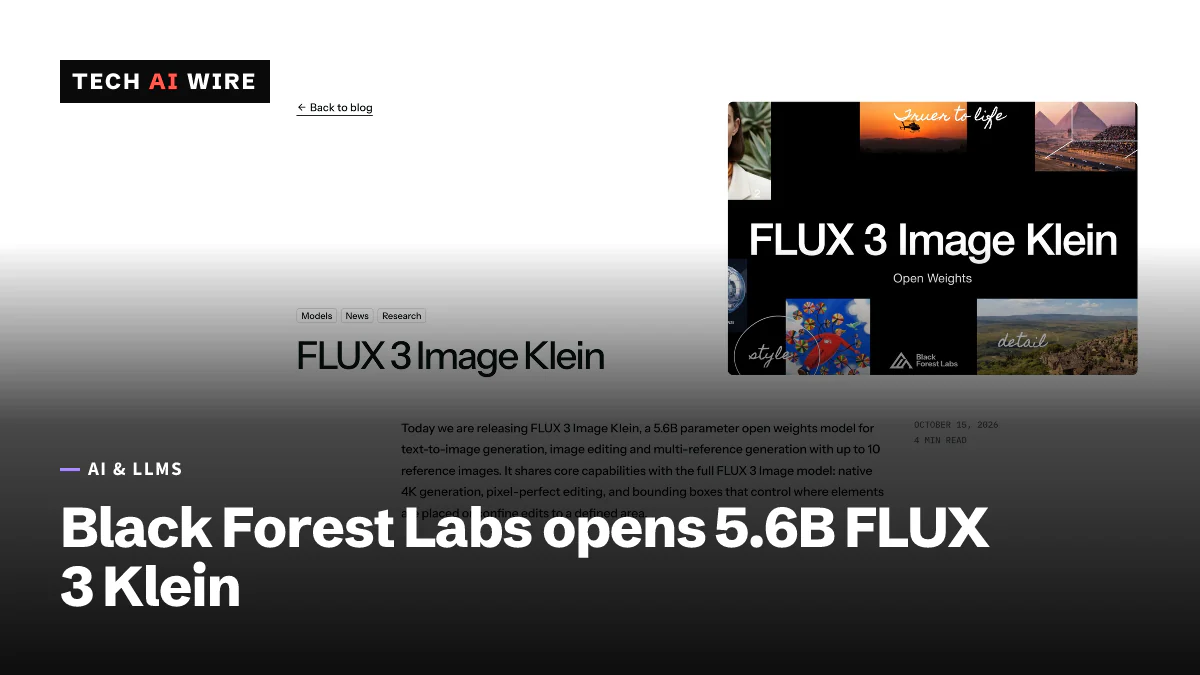
Black Forest Labs a publié FLUX 3 Image Klein, un modèle d'image à poids ouverts de 5,6B paramètres qui crée et retouche des images, gratuit en usage commercial sous 5 M$ de chiffre d'affaires.
3 min de lecture
En chiffres
- parameters, 38% fewer than FLUX.2 [klein] 9B
- 5.6B
- per 1024x1024 image on one H100, distilled model, per Hugging Face
- ~2 s
- reference images per request, at most
- 10
- annual revenue limit for free commercial use
- $5M
Black Forest Labs a publié FLUX 3 Image Klein le 15 octobre 2026. C'est un modèle d'IA à poids ouverts de 5,6 milliards de paramètres qui crée des images à partir de texte et retouche des images existantes. Le laboratoire affirme qu'il bat des modèles ouverts plus grands lors de ses propres tests, tout en restant assez petit pour tourner sur une carte graphique de bureau. Pour les développeurs, cela signifie un modèle d'image récent qu'ils peuvent télécharger, affiner et héberger eux-mêmes.
Black Forest Labs développe la famille de modèles d'image FLUX. « Poids ouverts » signifie que les fichiers du modèle entraîné sont publics. La licence limite tout de même qui peut l'utiliser gratuitement, comme expliqué plus bas.
Ce que Black Forest Labs a publié
La sortie comprend deux checkpoints principaux, selon l'annonce de Black Forest Labs :
| Checkpoint | Étapes par image | Idéal pour |
|---|---|---|
| Klein (distillé) | 16 | Génération rapide |
| Klein Base | 50 | Affinage, entraînement LoRA et recherche |
Les deux existent en BF16, avec des versions FP8 et NVFP4 qui utilisent moins de mémoire. Black Forest Labs mentionne aussi une version INT8. Un seul modèle assure trois tâches : créer des images à partir de texte, retoucher une image et combiner jusqu'à 10 images de référence. Il peut aussi générer nativement en résolution 4K.
Hugging Face a ajouté le modèle à Diffusers, sa bibliothèque open source pour les modèles d'image, le jour du lancement. Son article de blog met en avant une nouvelle fonction : le contrôle de la mise en page. Vous dessinez des cadres sur une grille pour suggérer où placer les objets. Les cadres guident la position et la taille, mais ce ne sont pas des masques stricts, précise la fiche du modèle.
À quelle vitesse il tourne
Hugging Face a mesuré environ 2 secondes pour une image de 1024x1024 avec le modèle distillé sur un GPU H100. Ajouter une image de référence double à peu près ce temps.
Black Forest Labs cite des vitesses mesurées par Nvidia. Le modèle distillé prend 0,55 seconde sur un GB300 et 8,9 secondes sur une RTX 4070. La version INT8 produit une image de 1 mégapixel en environ 4 secondes sur une RTX 5090. Black Forest Labs affirme qu'il tourne sur des cartes GeForce RTX dotées d'à peine 8 Go de mémoire.
Les besoins en mémoire dépendent de la configuration. Hugging Face a mesuré un pic de 20,72 Gio en BF16 sur un H100, et de 15,3 Gio en NVFP4 sur une RTX 6000. Avec le code de référence de Black Forest Labs sur un B200, le pic atteignait 31 Go en BF16 et 25 Go en NVFP4.
Le hic : un prompt upsampler obligatoire
La fiche du modèle contient une consigne ferme : « N'utilisez pas le modèle sans prompt upsampler. » Un prompt upsampler est un second modèle qui réécrit un prompt court en prompt détaillé. Black Forest Labs fournit à cet effet un upsampler de 9 milliards de paramètres. Il ajoute environ 28 Go de mémoire GPU sur une carte de 80 Go, précise la fiche.
Cela compte pour les affirmations sur les petits GPU. Le chiffre de 8 Go concerne le modèle d'image. Faire tourner l'upsampler sur la même machine demande bien plus de mémoire, ou un serveur séparé.
Ce que permet la licence
FLUX 3 Image Klein utilise la FLUX Kommunity License. Les particuliers et les entreprises dont le chiffre d'affaires annuel est inférieur à 5 millions de dollars peuvent l'utiliser gratuitement à des fins commerciales, selon Black Forest Labs. Les organisations plus grandes ont besoin d'une licence payante d'auto-hébergement ou doivent passer par l'API de l'entreprise.
L'encodeur de texte inclus dans le paquet, Qwen3-VL-4B-Instruct, est sous licence Apache 2.0, note la fiche du modèle.
Ce que cela signifie pour les développeurs
Si votre entreprise réalise moins de 5 millions de dollars de chiffre d'affaires par an, c'est un modèle d'image performant que vous pouvez livrer gratuitement. Lisez vous-même le texte de la licence avant de bâtir un produit dessus. « Poids ouverts » n'est pas synonyme de licence open source.
Prévoyez l'upsampler dès le premier jour. Budgétez soit un second GPU, soit un modèle hébergé pour réécrire les prompts, et testez la qualité avec et sans lui.
Pour l'affinage, partez de Klein Base. Black Forest Labs affirme qu'il prend en charge l'entraînement LoRA dès le premier jour via Diffusers et l'AI Toolkit d'Ostris. Un LoRA est un petit fichier complémentaire qui apprend au modèle un style ou un produit. Un LoRA ajoute environ 5 % au temps de génération, selon Black Forest Labs.
Enfin, considérez les classements « première place » comme une simple affirmation. Ils proviennent des tests internes de Black Forest Labs, alors comparez le modèle sur vos propres prompts avant d'en changer.
Sources
- FLUX 3 Image Klein - Black Forest Labs
- Welcome FLUX.3 Image Klein in Diffusers: The latest open image generation model from Black Forest Labs - Hugging Face
- black-forest-labs/flux-3-image-klein - Hugging Face (Black Forest Labs)
Articles liés
Holo4 : des modèles d'agents à poids ouverts obtiennent 61,7 % sur OSWorld 2.0
Holo4-27B de H Company obtient 61,7 % sur OSWorld 2.0 pour 1,22 dollar par tâche, mais seul son modèle frère sous Apache 2.0, 35B-A3B, peut être auto-hébergé à des fins commerciales.
Qwen-Image-2.1 livre 7 milliards de poids sous licence de recherche
Qwen-Image-2.1 réunit 7 milliards de paramètres et la transparence native dans un modèle d'image téléchargeable. Sa licence interdit l'usage commercial sans accord.
Les poids ouverts de Reflection Beam arrivent sous Apache 2.0
Reflection a publié les poids de Beam, un modèle de 501 milliards de paramètres, sur Hugging Face le 16 octobre 2026, sous Apache 2.0. Les versions FP8 et 4 bits tiennent sur un seul serveur à 8 GPU.