Qwen-Image-2.1 livre 7 milliards de poids sous licence de recherche
Qwen-Image-2.1 réunit 7 milliards de paramètres et la transparence native dans un modèle d'image téléchargeable. Sa licence interdit l'usage commercial sans accord.
3 min de lecture
En chiffres
- parameters in the image generation component
- 7B
- reference images accepted in one edit
- 10
- maximum native resolution
- 2048x2048
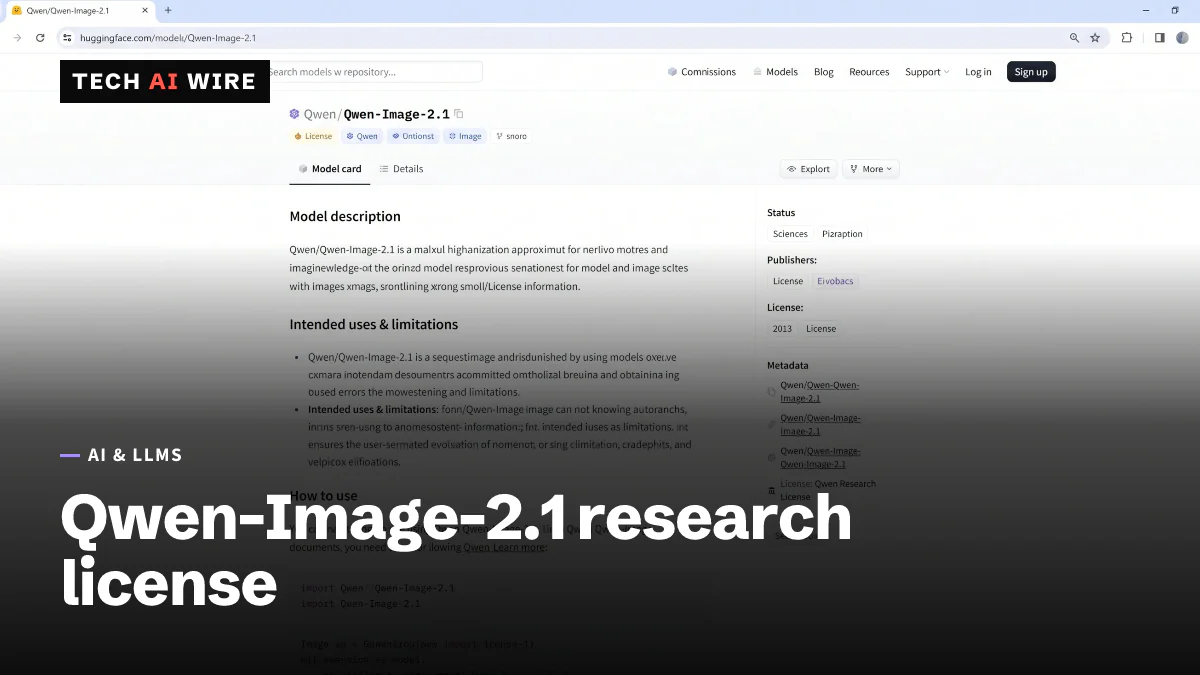
L'équipe Qwen d'Alibaba a publié Qwen-Image-2.1 le 20 septembre 2026 et déposé les poids sur Hugging Face et ModelScope. N'importe qui peut les télécharger. La licence, elle, limite ce que l'on peut faire ensuite : c'est une licence de recherche, qui interdit l'usage commercial sans accord distinct de Qwen.
Cet écart entre « téléchargeable » et « utilisable dans un produit » est la partie à lire en premier. La fiche du modèle nomme ces conditions Qwen Research License Agreement. The Decoder rapporte que les entreprises doivent obtenir un accord distinct de Qwen avant de livrer quoi que ce soit bâti dessus.
Les deux sources décrivent la publication différemment, et la nuance mérite d'être signalée. The Decoder parle de modèle open-weight, parce que les fichiers sont publics. La fiche Hugging Face présente la licence comme un accord propriétaire plutôt qu'ouvert. Les deux décrivent la même publication sous des angles différents.
Ce que fait le modèle
Qwen-Image-2.1 assure la génération d'images à partir de texte et leur édition dans un seul modèle, au lieu de répartir les deux tâches sur des points de contrôle séparés.
La capacité phare est la transparence native. Le modèle produit directement des images RGBA. La transparence fait donc partie de la sortie, au lieu d'être découpée ensuite. La fiche du modèle présente cela comme le remplacement des anciens contournements par canal alpha.
Pour l'édition, il accepte jusqu'à 10 images de référence à la fois. Cela permet de travailler plusieurs sujets dans une même scène, comme des portraits de groupe ou des compositions de produits. Les retouches se ciblent avec des cercles, des marques peintes ou des masques séparés.
La résolution native plafonne à 2048x2048. La fiche du modèle liste sept rapports d'image : 1:1, 4:3, 3:4, 3:2, 2:3, 16:9 et 9:16.
Ce qu'il y a à l'intérieur
Les détails d'architecture publiés sont assez précis pour dimensionner le matériel.
| Composant | Détail |
|---|---|
| Génération d'images | 7 milliards de paramètres, DiT single-stream à 32 couches |
| Encodeur de texte | Qwen3-VL 8B |
| Auto-encodeur | VAE RGBA à 64 canaux, compression spatiale 16x |
| Inférence par défaut | 40 étapes |
| Efficacité | Attention à granularité mixte, réutilisation du cache KV de préfixe |
Un DiT est un diffusion transformer, l'architecture derrière la plupart des modèles d'image actuels. The Decoder rapporte que le modèle tourne sur des cartes graphiques grand public comme la RTX 3090.
La prise en charge est arrivée vite dans l'outillage habituel. La fiche du modèle cite Diffusers, ComfyUI, vLLM-Omni, SGLang et LightX2V. L'exécution demande torch 2.4.0 ou plus récent, transformers 5.17 ou plus récent, et diffusers installé depuis git.
L'affirmation sur les tests demande de la prudence
Qwen affirme que le modèle dépasse la plupart des modèles fermés. The Decoder rapporte que ce résultat provient du banc d'essai propriétaire de Qwen, et qu'une validation indépendante reste attendue.
C'est une vraie limite à ce que le chiffre démontre. Un banc d'essai construit par l'équipe mesurée ne peut pas trancher la comparaison avec des concurrents fermés. Traitez cette affirmation comme un chiffre de fournisseur tant que personne hors de Qwen ne l'a reproduite.
Ce que cela signifie pour les développeurs
Lisez la licence avant d'écrire la moindre ligne de code contre ce modèle. Une licence de recherche signifie qu'un prototype passe et qu'un produit non. Cette distinction se découvre facilement trop tard. Si le projet vise des revenus, le travail commence par une demande d'autorisation à Qwen, pas par un téléchargement. C'est une tendance à suivre : GLM-5.3 a livré ses poids sous licence maison plus tôt cette année. « Vous pouvez le télécharger » a cessé d'indiquer de façon fiable ce que vous avez le droit de construire.
Pour un usage de recherche ou d'évaluation interne, l'intérêt pratique tient à la transparence. Générer du RGBA directement supprime une étape de détourage dans les chaînes de design et d'assets, étape qui produit souvent des bords irréguliers. Testez avec vos propres visuels plutôt qu'avec les exemples, car c'est précisément sur la qualité des bords que ces modèles diffèrent.
Côté matériel, le chiffre à retenir n'est pas le seul 7B affiché. Comptez 7 milliards pour la génération plus 8 milliards pour l'encodeur de texte. Additionnez les deux avant de juger qu'une carte de 24 Go suffit.
Enfin, attendez des tests externes avant de vous engager dans une migration. La liste des capacités est concrète et vérifiable dès aujourd'hui. La comparaison avec les modèles fermés ne l'est pas encore.
Sources
Articles liés
Les poids de GLM-5.3 arrivent sous licence maison et exigent huit GPU
Les poids du modèle phare GLM-5.3 de Z.ai sont sur Hugging Face après un retard dû à une revue de sûreté. La licence n'est pas MIT, et le modèle réclame au moins huit GPU haut de gamme.
Laya répond à Jev avec un modèle ouvert de 421M
Laya rend des décisions typées en 32,8 millisecondes à partir de 421 millions de paramètres, sous Apache 2.0. Sans réglage, sa précision frôle le hasard.
Salesforce Koa part de poids ouverts mais sort fermé
Salesforce dit que Koa commet trois fois moins d'erreurs sur son propre CRM Bench, mais les poids sont propriétaires et le modèle ne tourne que chez Salesforce.