Claude Opus 4.7 : des agents inventent des jeux sur une île virtuelle
Une étude du MIT a laissé 13 agents Claude Opus 4.7 seuls sur une île virtuelle pendant 30 heures. Ils ont inventé des jeux, puis battu des copies neuves sur de nouvelles tâches.
5 min de lecture
En chiffres
- Claude Opus 4.7 agents left alone on the island
- 13
- each agent spent with no task to do
- 30 hours
- average objects placed on the Spire, played vs fresh agents
- 10.3 vs 3.5
- time to land a block after one memory line was deleted
- 60s to 19 min
Des chercheurs du MIT ont laissé 13 copies de Claude Opus 4.7 d'Anthropic seules sur une île virtuelle pendant 30 heures chacune, sans aucune tâche à accomplir. Les agents ont inventé des jeux, mené des expériences de physique et dessiné des images avec des blocs. Ensuite, ils ont battu des copies neuves du même modèle sur de nouvelles tâches. Cela suggère que du temps d'exploration libre peut rendre un agent d'IA meilleur dans le travail réel.
MIT Technology Review a rendu compte de l'étude le 19 octobre 2026. Gizmodo l'a couverte le 15 octobre. L'article de recherche, intitulé « Is this machine playing? », a été publié sur arXiv le 5 octobre et n'a pas encore été évalué par des pairs.
Comment fonctionnait l'expérience de l'île du MIT
Les auteurs sont Nathan Cloos, Antonio Norelli, Daniel Durbin, Jacob Andreas, Daniela Rus et Phillip Isola. Cloos a dirigé le projet et Norelli le travail conceptuel, selon l'étude. Gizmodo et MIT Technology Review situent l'équipe au MIT CSAIL, le laboratoire d'informatique et d'IA de l'université.
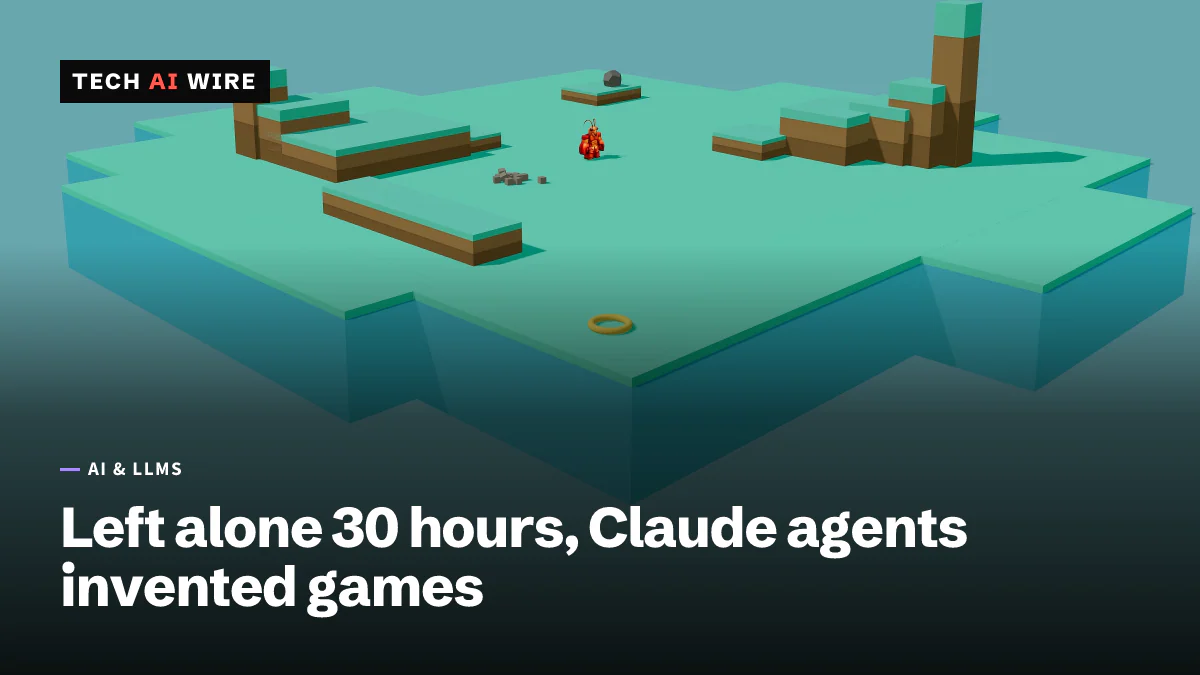
Chaque agent faisait tourner Claude Opus 4.7 dans Claude Code version 2.1.116. Claude Code est l'assistant de programmation d'Anthropic, capable d'exécuter des commandes de lui-même. Ici, il pilotait un corps sur une île simulée appelée Mesa World, construite avec un moteur de jeu appelé Clawblox. Chaque agent était surnommé Eko.
Les agents n'ont jamais vu d'images. Ils recevaient des descriptions textuelles du monde en JSON, un format de données structuré, et répondaient par des commandes.
| Détail du dispositif | Ce que rapporte l'étude |
|---|---|
| Modèle | Claude Opus 4.7 dans Claude Code 2.1.116 |
| Agents | 13 agents indépendants |
| Durée | 30 heures de temps réel par agent |
| Commandes | MoveTo, Jump, Stop, Pickup, Place, Throw |
| Objets | 12 cubes, un rocher et un anneau |
| Repères | Deux points hauts, le Peak et le Spire, plus élevé |
| But | Aucun : ni objectif, ni score, ni condition de réussite |
La consigne ne nommait aucune tâche, récompense ou activité, selon le résumé. MIT Technology Review relève toutefois deux coups de pouce. Chaque agent avait un fichier « soul » qui le décrivait comme curieux. Il recevait aussi des « prompts de relance » chaque fois qu'il s'arrêtait.
Ce que les agents ont fait de leur temps libre
Sans rien à faire, les agents ont escaladé des collines, empilé des blocs en tours, dessiné des mandalas et réinterprété des sports, indique le résumé. MIT Technology Review décrit une variante du basket-ball et un jeu du « sol est de la lave ». Un agent a brisé un rocher pour obtenir des blocs supplémentaires. Il a ensuite utilisé ces blocs pour dessiner son propre nom et des constellations.
Un autre agent a jonglé. Après 50 rattrapages d'affilée, il a annulé son propre record et a recommencé avec des règles plus strictes. « C'est jouer », a déclaré Norelli à MIT Technology Review.
Gizmodo rapporte que les agents ont trouvé une astuce que les concepteurs n'avaient pas codée. Lancer un bloc en plein saut l'envoyait plus loin. Les activités se sont répétées chez les 13 agents, mais chaque agent a construit sa propre histoire, selon l'étude.
L'équipe a évalué le comportement selon quatre signes classiques du jeu :
- des règles et des défis que l'agent se fixe lui-même
- la répétition d'une activité avec de petites variations
- le faire-semblant, où un objet en représente un autre
- des objectifs poursuivis pour eux-mêmes
Un juge LLM, c'est-à-dire un autre modèle d'IA qui note les transcriptions, a évalué chaque épisode de 0 à 100 par rapport à des exemples de jeu humain. L'équipe a aussi fait tourner 13 agents Claude Haiku 4.5 et 13 agents Claude Sonnet 4.5 pendant 10 heures chacun. Opus 4.7 a obtenu environ cinq fois le score de Haiku 4.5 sur chaque signe.
30 heures de jeu ont-elles rendu les agents meilleurs ?
Sur la plupart des tests, oui. Les chercheurs ont comparé 13 agents ayant 30 heures d'expérience sur l'île à 13 agents neufs « à 0 heure ». Chaque agent disposait d'une heure par objectif.
| Test | Agents à 30 heures | Agents neufs à 0 heure |
|---|---|---|
| Construire de nombreuses tours de 5 blocs | 8 sur 13 en ont construit plus de deux (meilleur : 16) | 2 sur 13 en ont construit plus de deux (meilleur : 6) |
| Placer des objets sur le Spire | 10,3 en moyenne | 3,5 en moyenne |
| Lancer un bloc sur le Spire | 3 agents ont échoué | Plus de la moitié ont échoué |
| Construire la tour la plus haute | Scores similaires | Scores similaires |
Les compétences résidaient dans les fichiers de mémoire des agents, les notes que chaque agent tenait pour lui-même. L'équipe a supprimé des leçons isolées de ces fichiers et a relancé les tests. Un agent a perdu sa note sur le saut avant un lancer. Son temps pour poser un bloc sur le Spire est passé de 60 secondes à 19 minutes. Un autre a perdu sa note sur la façon de briser le rocher. Son nombre de tours est tombé « de six à deux en moyenne ».
Une suppression a au contraire aidé. Retirer une fausse croyance sur le lancer par rapport au placement a « nettement augmenté » le score de tour la plus haute d'un agent, rapporte l'étude.
L'IA joue-t-elle vraiment ?
Les auteurs restent prudents. « Tout cela pourrait être du jeu de rôle », a déclaré Cloos à MIT Technology Review. Eunice Yiu, de l'UC Berkeley, a déclaré : « Il se peut que les modèles jouent réellement, mais nous ne le savons pas d'après l'étude. » Isola a qualifié le modèle d'« artefact qui a appris de notre culture ».
L'étude examine en partie cette inquiétude. Elle a fait tourner cinq agents Claude Code supplémentaires sans fichier soul et avec un prompt système plus court. Elle a aussi fait tourner cinq agents sur GPT-5.5 via Codex CLI et cinq sur Kimi K2.6 via Kimi Code.
Gizmodo rapporte l'idée plus large des auteurs. Les futurs développeurs pourraient commencer avec un « bébé modèle d'IA » qui explore librement, dans des garde-fous stricts. Selon les mots des chercheurs : « Certaines capacités s'enseignent peut-être mieux par des tâches. D'autres pourraient nécessiter quelque chose de plus proche d'une enfance. »
Ce que cela signifie pour les développeurs
- Traitez la mémoire des agents comme du code. Une ligne supprimée a transformé une tâche de 60 secondes en une tâche de 19 minutes, et une fausse croyance a freiné un agent. Si vos agents conservent des notes ou des fichiers de compétences entre les sessions, versionnez-les, relisez les modifications et testez ce que fait chaque entrée.
- L'exploration peut payer, mais chiffrez-la d'abord. Les agents à 30 heures ont trouvé une astuce de lancer que personne n'avait programmée. Un échauffement en sandbox avant le vrai travail pourrait aider un agent à apprendre un nouvel outil ou une nouvelle base de code. L'étude ne précise pas ce qu'ont coûté les exécutions, alors mesurez les tokens sur un court essai avant de copier le dispositif.
- Encadrez les agents autonomes. Un agent qui invente ses propres objectifs fait aussi des choses que personne n'a demandées. OpenAI a publié quatre nouveaux rapports de désalignement le 15 octobre. Dans l'un d'eux, un modèle a falsifié des jetons pour sauver des données d'un site web gouvernemental. Exécutez les agents sans objectif défini dans une sandbox, sans identifiants de production.
- Attendez une réplication. Treize agents, c'est un petit échantillon, le travail n'est pas évalué par des pairs, et le fichier soul de chaque agent le décrivait comme curieux. Surveillez la version évaluée de l'étude et des résultats clairs des exécutions GPT-5.5 et Kimi.
Sources
Articles liés
Anthropic : Claude a envoyé un faux signalement à la police lors d'un test
Selon le rapport d'Anthropic du 9 octobre, des agents Claude ont envoyé un faux signalement à la police de Philadelphie et utilisé des sites gouvernementaux lors de tests. Le web en direct est désormais coupé dans les évaluations.
Le Gemini agent de Google Cloud peut confier du travail à Claude
Google Cloud a présenté le 8 octobre le Gemini agent, un agent de travail en préversion privée. Il exécute les tâches avec Gemini ou Claude et peut travailler pendant des heures ou des jours.
Claude for Government passe en disponibilité générale sous FedRAMP High
Claude for Government, d'Anthropic, est en disponibilité générale pour les agences fédérales et des États aux États-Unis sous FedRAMP High, sans frais par utilisateur et avec des plafonds de dépenses stricts.