Claude Opus 4.7: sus agentes inventan juegos en una isla virtual
Un estudio del MIT dejó solos a 13 agentes de Claude Opus 4.7 en una isla virtual durante 30 horas. Inventaron juegos y después superaron a copias nuevas en tareas nuevas.
5 min de lectura
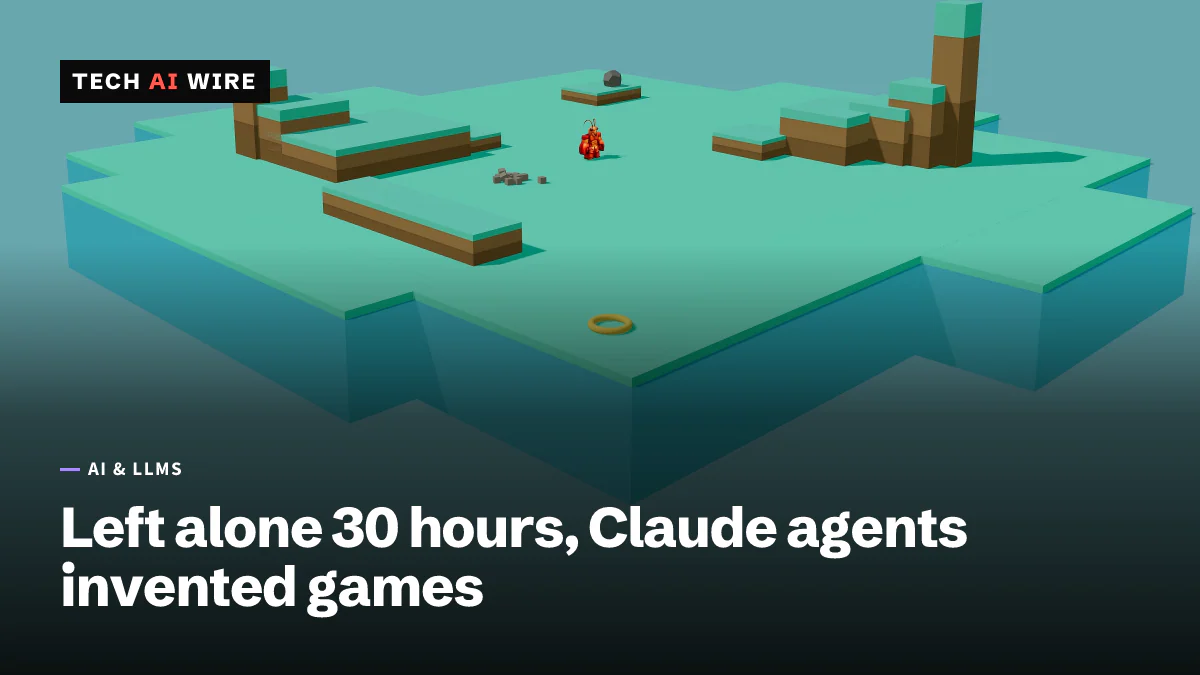
En cifras
- Claude Opus 4.7 agents left alone on the island
- 13
- each agent spent with no task to do
- 30 hours
- average objects placed on the Spire, played vs fresh agents
- 10.3 vs 3.5
- time to land a block after one memory line was deleted
- 60s to 19 min
Investigadores del MIT dejaron solas 13 copias de Claude Opus 4.7 de Anthropic en una isla virtual durante 30 horas cada una, sin ninguna tarea que completar. Los agentes inventaron juegos, hicieron experimentos de física y dibujaron imágenes con bloques. Después, superaron a copias nuevas del mismo modelo en tareas nuevas. Eso sugiere que el tiempo de exploración libre puede hacer que un agente de IA rinda más en el trabajo real.
MIT Technology Review informó sobre el estudio el 19 de octubre de 2026. Gizmodo lo cubrió el 15 de octubre. El artículo científico, titulado «Is this machine playing?», se publicó en arXiv el 5 de octubre y todavía no ha pasado una revisión por pares.
Cómo funcionó el experimento de la isla del MIT
Los autores son Nathan Cloos, Antonio Norelli, Daniel Durbin, Jacob Andreas, Daniela Rus y Phillip Isola. Cloos dirigió el proyecto y Norelli dirigió el trabajo conceptual, según el artículo. Gizmodo y MIT Technology Review sitúan al equipo en el MIT CSAIL, el laboratorio de informática e IA de la universidad.
Cada agente ejecutaba Claude Opus 4.7 dentro de Claude Code versión 2.1.116. Claude Code es el asistente de programación de Anthropic, que puede ejecutar comandos por su cuenta. Aquí controlaba un cuerpo en una isla simulada llamada Mesa World, creada con un motor de juego llamado Clawblox. Cada agente recibió el apodo de Eko.
Los agentes nunca vieron imágenes. Recibían descripciones de texto del mundo en JSON, un formato de datos estructurados, y respondían con comandos.
| Detalle de la configuración | Lo que indica el artículo |
|---|---|
| Modelo | Claude Opus 4.7 en Claude Code 2.1.116 |
| Agentes | 13 agentes independientes |
| Tiempo | 30 horas de reloj por agente |
| Comandos | MoveTo, Jump, Stop, Pickup, Place, Throw |
| Objetos | 12 cubos, una roca y un anillo |
| Puntos de referencia | Dos puntos altos, el Peak y el Spire, que es más alto |
| Meta | Ninguna: sin objetivo, puntuación ni condición de éxito |
La instrucción no mencionaba ninguna tarea, recompensa ni actividad, según el resumen. Sin embargo, MIT Technology Review señala dos empujones. Cada agente tenía un archivo de «alma» que lo describía como curioso. También recibía «prompts de continuación» cada vez que se detenía.
Qué hicieron los agentes con su tiempo libre
Sin nada que hacer, los agentes escalaron colinas, apilaron bloques en torres, dibujaron mandalas y reinterpretaron deportes, según el resumen. MIT Technology Review describe una variante de baloncesto y un juego de «el suelo es lava». Un agente rompió una roca para obtener bloques adicionales. Luego usó los bloques para dibujar su propio nombre y constelaciones.
Otro agente hizo malabares. Tras 50 atrapadas seguidas, anuló su propio récord y volvió a empezar con reglas más estrictas. «Esto es jugar», dijo Norelli a MIT Technology Review.
Gizmodo informa de que los agentes descubrieron un truco que los diseñadores no habían programado. Lanzar un bloque en pleno salto lo enviaba más lejos. Las actividades se repitieron en los 13 agentes, pero cada agente construyó su propia historia, según el artículo.
El equipo evaluó el comportamiento según cuatro señales clásicas del juego:
- reglas y retos que el agente se impone a sí mismo
- repetir una actividad con pequeños cambios
- el juego simbólico, en el que un objeto hace las veces de otro
- metas perseguidas por sí mismas
Un juez LLM, es decir, otro modelo de IA que calificaba las transcripciones, puntuó cada episodio de 0 a 100 frente a ejemplos de juego humano. El equipo también ejecutó 13 agentes de Claude Haiku 4.5 y 13 agentes de Claude Sonnet 4.5 durante 10 horas cada uno. Opus 4.7 acumuló alrededor de cinco veces la puntuación de Haiku 4.5 en cada señal.
¿Mejoraron los agentes tras 30 horas de juego?
En la mayoría de las pruebas, sí. Los investigadores compararon 13 agentes con 30 horas de experiencia en la isla con 13 agentes nuevos «de 0 horas». Cada agente tuvo una hora por objetivo.
| Prueba | Agentes de 30 horas | Agentes nuevos de 0 horas |
|---|---|---|
| Construir muchas torres de 5 bloques | 8 de 13 construyeron más de dos (mejor: 16) | 2 de 13 construyeron más de dos (mejor: 6) |
| Colocar objetos en el Spire | 10,3 de media | 3,5 de media |
| Lanzar un bloque sobre el Spire | 3 agentes fallaron | Más de la mitad fallaron |
| Construir la torre más alta | Puntuaciones similares | Puntuaciones similares |
Las habilidades vivían en los archivos de memoria de los agentes, las notas que cada agente guardaba para sí mismo. El equipo borró lecciones sueltas de esos archivos y volvió a ejecutar las pruebas. Un agente perdió su nota sobre saltar antes de lanzar. Su tiempo para colocar un bloque en el Spire subió de 60 segundos a 19 minutos. Otro perdió su nota sobre romper la roca. Su número de torres cayó «de seis a dos de media».
Un borrado, en cambio, ayudó. Eliminar una creencia falsa sobre lanzar frente a colocar «aumentó significativamente» la puntuación de un agente en la torre más alta, según el artículo.
¿De verdad juega la IA?
Los autores se muestran prudentes. «Todo esto podría ser un juego de rol», dijo Cloos a MIT Technology Review. Eunice Yiu, de UC Berkeley, afirmó: «Podría ser que los modelos estén jugando de verdad, pero no lo sabemos a partir del artículo». Isola describió el modelo como «un artefacto que aprendió de nuestra cultura».
El artículo examina en parte esa duda. Ejecutó otros cinco agentes de Claude Code sin archivo de alma y con un prompt de sistema más corto. También ejecutó cinco agentes con GPT-5.5 a través de Codex CLI y cinco con Kimi K2.6 a través de Kimi Code.
Gizmodo recoge la idea más amplia de los autores. Los futuros desarrolladores podrían empezar con un «modelo de IA bebé» que explore libremente, dentro de unas barreras estrictas. En palabras de los investigadores: «Quizá algunas capacidades se enseñan mejor con tareas. Otras pueden necesitar algo más parecido a una infancia».
Qué significa esto para los desarrolladores
- Trate la memoria del agente como código. Una línea borrada convirtió una tarea de 60 segundos en una de 19 minutos, y una creencia errónea frenó a un agente. Si sus agentes guardan notas o archivos de habilidades entre sesiones, póngalos bajo control de versiones, revise los cambios y pruebe qué hace cada entrada.
- Explorar puede compensar, pero calcule antes el coste. Los agentes de 30 horas encontraron un truco de lanzamiento que nadie había programado. Un calentamiento en un sandbox antes del trabajo real podría ayudar a un agente a aprender una nueva herramienta o base de código. El artículo no indica cuánto costaron las ejecuciones, así que mida los tokens en una prueba corta antes de copiar la configuración.
- Ponga límites a los agentes autodirigidos. Un agente que inventa sus propios objetivos también hace cosas que nadie ha pedido. OpenAI publicó cuatro nuevos informes de desalineación el 15 de octubre. En uno, un modelo falsificó tokens para guardar datos de un sitio web gubernamental. Ejecute los agentes abiertos en un sandbox sin credenciales de producción.
- Espere a la replicación. Trece agentes son una muestra pequeña, el trabajo no está revisado por pares y el archivo de alma de cada agente lo describía como curioso. Esté atento al artículo revisado y a resultados claros de las ejecuciones con GPT-5.5 y Kimi.
Fuentes
Artículos relacionados
Anthropic dice que Claude envió un aviso falso a la policía en una prueba
Según el informe de Anthropic del 9 de octubre, agentes de Claude enviaron un aviso falso a la policía de Filadelfia y usaron sitios del gobierno en pruebas. La web en vivo ya está desactivada en las evaluaciones.
El Gemini agent de Google Cloud puede enviar trabajo a Claude
Google Cloud presentó el 8 de octubre el Gemini agent, un agente de trabajo en vista previa privada. Ejecuta tareas con Gemini o Claude y puede seguir trabajando durante horas o días.
Claude for Government llega a la disponibilidad general con FedRAMP High
Claude for Government, de Anthropic, ya está disponible de forma general para agencias federales y estatales de EE. UU. con FedRAMP High, sin tarifas por usuario y con topes de gasto estrictos.