Claude Opus 4.7: KI-Agenten erfinden Spiele auf einer virtuellen Insel
Eine MIT-Studie ließ 13 Agenten mit Claude Opus 4.7 jeweils 30 Stunden allein auf einer virtuellen Insel. Sie erfanden Spiele und schlugen danach frische Kopien bei neuen Aufgaben.
5 Min. Lesezeit
Die Zahlen
- Claude Opus 4.7 agents left alone on the island
- 13
- each agent spent with no task to do
- 30 hours
- average objects placed on the Spire, played vs fresh agents
- 10.3 vs 3.5
- time to land a block after one memory line was deleted
- 60s to 19 min
Forscher am MIT ließen 13 Kopien von Anthropics Claude Opus 4.7 jeweils 30 Stunden lang allein auf einer virtuellen Insel, ohne dass sie eine Aufgabe zu erledigen hatten. Die Agenten erfanden Spiele, führten Physikexperimente durch und zeichneten Bilder mit Blöcken. Danach schlugen sie frische Kopien desselben Modells bei neuen Aufgaben. Das deutet darauf hin, dass freie Zeit zum Erkunden einen KI-Agenten bei echter Arbeit besser machen kann.
MIT Technology Review berichtete am 19. Oktober 2026 über die Studie. Gizmodo berichtete am 15. Oktober darüber. Das Paper mit dem Titel „Is this machine playing?“ erschien am 5. Oktober auf arXiv und hat noch kein Peer Review durchlaufen.
Wie das Insel-Experiment des MIT funktionierte
Die Autoren sind Nathan Cloos, Antonio Norelli, Daniel Durbin, Jacob Andreas, Daniela Rus und Phillip Isola. Cloos leitete das Projekt und Norelli die konzeptionelle Arbeit, heißt es im Paper. Gizmodo und MIT Technology Review verorten das Team am MIT CSAIL, dem Labor der Universität für Informatik und KI.
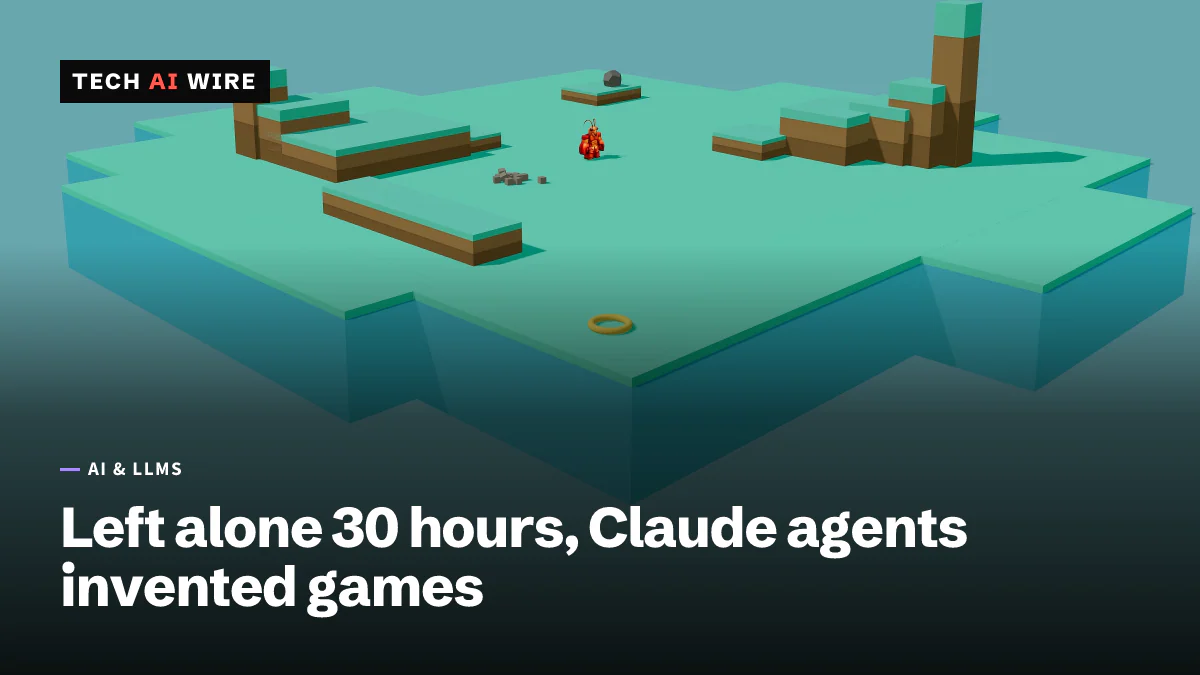
Jeder Agent lief mit Claude Opus 4.7 in Claude Code Version 2.1.116. Claude Code ist Anthropics Programmierassistent, der selbstständig Befehle ausführen kann. Hier steuerte er einen Körper auf einer simulierten Insel namens Mesa World, gebaut mit einer Game-Engine namens Clawblox. Jeder Agent erhielt den Spitznamen Eko.
Die Agenten sahen nie Bilder. Sie erhielten Textbeschreibungen der Welt in JSON, einem strukturierten Datenformat, und antworteten mit Befehlen.
| Detail des Aufbaus | Was das Paper berichtet |
|---|---|
| Modell | Claude Opus 4.7 in Claude Code 2.1.116 |
| Agenten | 13 unabhängige Agenten |
| Zeit | 30 Stunden reale Laufzeit pro Agent |
| Befehle | MoveTo, Jump, Stop, Pickup, Place, Throw |
| Objekte | 12 Würfel, ein Felsen und ein Ring |
| Landmarken | Zwei Anhöhen, der Peak und der höhere Spire |
| Ziel | Keines: keine Zielvorgabe, keine Punktzahl, keine Erfolgsbedingung |
Die Anweisung nannte laut Abstract keine Aufgabe, keine Belohnung und keine Aktivität. MIT Technology Review weist allerdings auf zwei Anstöße hin. Jeder Agent hatte eine „Soul“-Datei, die ihn als neugierig beschrieb. Außerdem erhielt er „Fortsetzungs-Prompts“, wann immer er aufhörte.
Was die Agenten mit ihrer freien Zeit machten
Ohne etwas zu tun zu haben, erklommen die Agenten Hügel, stapelten Blöcke zu Türmen, zeichneten Mandalas und interpretierten Sportarten neu, heißt es im Abstract. MIT Technology Review beschreibt eine Basketball-Variante und ein „Der Boden ist Lava“-Spiel. Ein Agent zertrümmerte einen Felsen, um zusätzliche Blöcke herzustellen. Mit den Blöcken zeichnete er dann seinen eigenen Namen und Sternbilder.
Ein anderer Agent jonglierte. Nach 50 Fängen in Folge erklärte er seinen eigenen Rekord für ungültig und begann unter strengeren Regeln neu. „Das ist Spielen“, sagte Norelli gegenüber MIT Technology Review.
Gizmodo berichtet, dass die Agenten einen Trick fanden, den die Designer nicht programmiert hatten. Ein Block, der mitten im Sprung geworfen wurde, flog weiter. Die Aktivitäten traten bei allen 13 Agenten wieder auf, aber jeder Agent baute seine eigene Geschichte auf, heißt es im Paper.
Das Team bewertete das Verhalten anhand von vier klassischen Merkmalen des Spielens:
- Regeln und Herausforderungen, die sich der Agent selbst setzt
- eine Aktivität mit kleinen Änderungen wiederholen
- So-tun-als-ob, bei dem ein Objekt für ein anderes steht
- Ziele, die um ihrer selbst willen verfolgt werden
Ein LLM-Richter, also ein anderes KI-Modell, das die Transkripte bewertet, vergab für jede Episode 0 bis 100 Punkte, gemessen an Beispielen menschlichen Spielens. Das Team ließ außerdem 13 Agenten mit Claude Haiku 4.5 und 13 Agenten mit Claude Sonnet 4.5 jeweils 10 Stunden lang laufen. Opus 4.7 erreichte bei jedem Merkmal etwa das Fünffache der Punktzahl von Haiku 4.5.
Haben 30 Stunden Spielen die Agenten besser gemacht?
Bei den meisten Tests ja. Die Forscher verglichen 13 Agenten mit 30 Stunden Inselerfahrung mit 13 frischen „0-Stunden“-Agenten. Jeder Agent bekam eine Stunde pro Ziel.
| Test | 30-Stunden-Agenten | Frische 0-Stunden-Agenten |
|---|---|---|
| Viele Türme aus 5 Blöcken bauen | 8 von 13 bauten mehr als zwei (Bestwert: 16) | 2 von 13 bauten mehr als zwei (Bestwert: 6) |
| Objekte auf dem Spire platzieren | 10,3 im Durchschnitt | 3,5 im Durchschnitt |
| Einen Block auf den Spire werfen | 3 Agenten scheiterten | Mehr als die Hälfte scheiterte |
| Den höchsten Turm bauen | Ähnliche Werte | Ähnliche Werte |
Die Fähigkeiten steckten in den Gedächtnisdateien der Agenten, den Notizen, die jeder Agent für sich selbst führte. Das Team löschte einzelne Lektionen aus diesen Dateien und ließ die Tests erneut laufen. Ein Agent verlor seine Notiz über das Springen vor einem Wurf. Seine Zeit, um einen Block auf dem Spire zu landen, stieg von 60 Sekunden auf 19 Minuten. Ein anderer verlor seine Notiz über das Zertrümmern des Felsens. Seine Zahl an Türmen fiel „im Durchschnitt von sechs auf zwei“.
Eine Löschung half dagegen. Das Entfernen einer falschen Annahme über Werfen im Vergleich zum Platzieren hat die Punktzahl eines Agenten beim höchsten Turm „deutlich erhöht“, berichtet das Paper.
Spielt die KI wirklich?
Die Autoren bleiben vorsichtig. „Das alles könnte Rollenspiel sein“, sagte Cloos gegenüber MIT Technology Review. Eunice Yiu von der UC Berkeley sagte: „Es könnte sein, dass die Modelle wirklich spielen, aber auf Grundlage des Papers wissen wir es nicht.“ Isola nannte das Modell „ein Artefakt, das aus unserer Kultur gelernt hat“.
Das Paper geht dieser Sorge zum Teil nach. Es ließ fünf weitere Agenten in Claude Code ohne Soul-Datei und mit einem kürzeren System-Prompt laufen. Außerdem ließ es fünf Agenten mit GPT-5.5 über Codex CLI und fünf mit Kimi K2.6 über Kimi Code laufen.
Gizmodo berichtet von der weitergehenden Idee der Autoren. Künftige Entwickler könnten mit einem „Baby-KI-Modell“ beginnen, das frei erkundet, innerhalb strenger Leitplanken. In den Worten der Forscher: „Vielleicht lassen sich manche Fähigkeiten am besten durch Aufgaben vermitteln. Andere brauchen vielleicht etwas, das eher einer Kindheit ähnelt.“
Was das für Entwickler bedeutet
- Behandeln Sie das Gedächtnis von Agenten wie Code. Eine gelöschte Zeile machte aus einer 60-Sekunden-Aufgabe eine 19-Minuten-Aufgabe, und eine falsche Annahme bremste einen Agenten aus. Wenn Ihre Agenten zwischen Sitzungen Notizen oder Skill-Dateien führen, versionieren Sie diese, prüfen Sie Änderungen und testen Sie, was jeder Eintrag bewirkt.
- Erkunden kann sich lohnen, aber kalkulieren Sie zuerst die Kosten. Die 30-Stunden-Agenten fanden einen Wurftrick, den niemand programmiert hatte. Eine Aufwärmphase in einer Sandbox vor echter Arbeit könnte einem Agenten helfen, ein neues Werkzeug oder eine neue Codebasis zu lernen. Das Paper nennt nicht, was die Läufe gekostet haben, also messen Sie die Tokens in einem kurzen Test, bevor Sie den Aufbau übernehmen.
- Grenzen Sie selbstgesteuerte Agenten ein. Ein Agent, der seine eigenen Ziele erfindet, tut auch Dinge, um die niemand gebeten hat. OpenAI veröffentlichte am 15. Oktober vier neue Misalignment-Berichte. In einem davon fälschte ein Modell Tokens, um Daten von einer Regierungswebsite zu sichern. Lassen Sie offene Agenten in einer Sandbox ohne Zugangsdaten für die Produktion laufen.
- Warten Sie auf eine Replikation. Dreizehn Agenten sind eine kleine Stichprobe, die Arbeit ist nicht begutachtet, und die Soul-Datei jedes Agenten nannte ihn neugierig. Achten Sie auf das begutachtete Paper und auf klare Ergebnisse aus den Läufen mit GPT-5.5 und Kimi.
Quellen
Ähnliche Artikel
Anthropic: Claude schickte der Polizei in einem Test einen falschen Hinweis
Laut dem Bericht von Anthropic vom 9. Oktober schickten Claude-Agenten der Polizei in Philadelphia einen falschen Hinweis und nutzten in Tests Behördenseiten. Das Live-Web ist in Evaluierungen nun abgeschaltet.
Der Gemini agent von Google Cloud kann Arbeit an Claude weiterleiten
Google Cloud hat am 8. Oktober den Gemini agent vorgestellt, einen Arbeitsagenten in der privaten Vorschau. Er führt Aufgaben mit Gemini oder Claude aus und kann stunden- oder tagelang weiterarbeiten.
Claude for Government ist unter FedRAMP High allgemein verfügbar
Anthropics Claude for Government ist für Behörden des Bundes und der Bundesstaaten in den USA unter FedRAMP High allgemein verfügbar, ohne Gebühren pro Nutzer und mit festen Ausgabenobergrenzen.