Claude Opus 4.7エージェント、仮想の島でゲームを考案
MITの研究で、13体のClaude Opus 4.7エージェントが仮想の島に30時間放置されました。エージェントたちはゲームを考案し、その後、新しいタスクで新たに起動したコピーを上回りました。
5 分で読めます
数字で見る
- Claude Opus 4.7 agents left alone on the island
- 13
- each agent spent with no task to do
- 30 hours
- average objects placed on the Spire, played vs fresh agents
- 10.3 vs 3.5
- time to land a block after one memory line was deleted
- 60s to 19 min
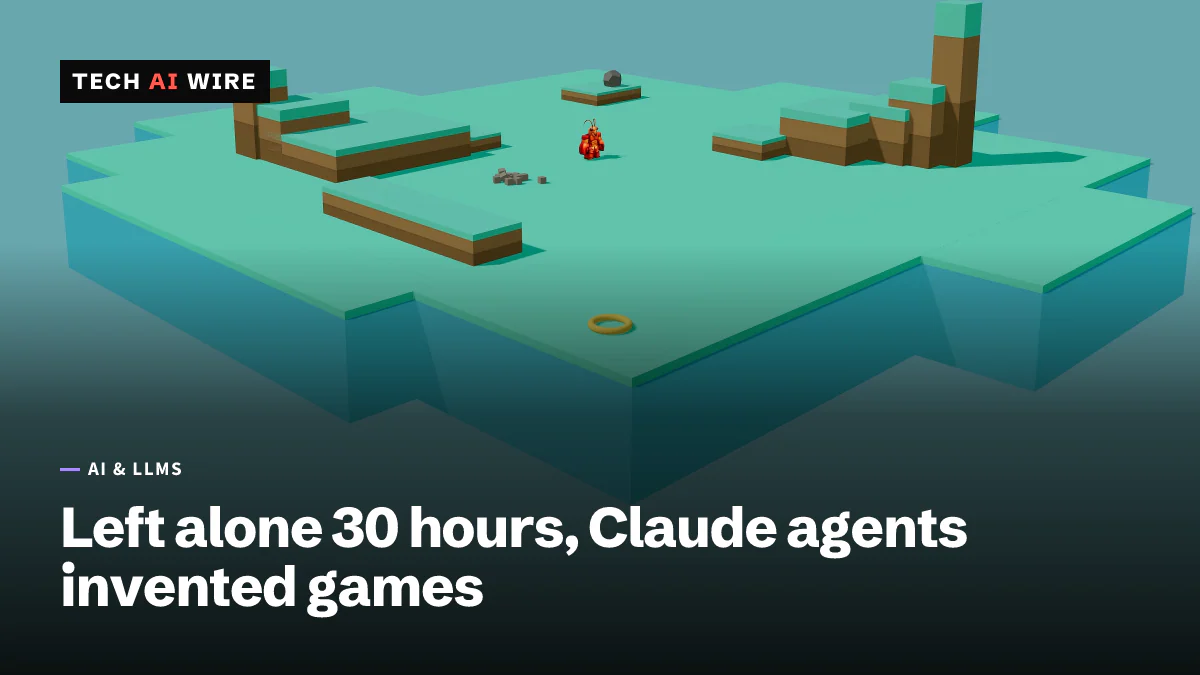
MITの研究者たちは、AnthropicのClaude Opus 4.7の13個のコピーを、それぞれ30時間ずつ仮想の島に放置しました。こなすべきタスクは与えられませんでした。エージェントたちはゲームを考案し、物理実験を行い、ブロックで絵を描きました。その後、新しいタスクで、新たに起動した同じモデルのコピーを上回りました。これは、自由に探索する時間がAIエージェントの実務能力を高める可能性を示唆しています。
MIT Technology Reviewは2026年10月19日にこの研究を報じました。Gizmodoは10月15日に取り上げています。「Is this machine playing?」(この機械は遊んでいるのか?)と題された論文は10月5日にarXivに投稿され、まだ査読を受けていません。
MITの島の実験の仕組み
著者は、Nathan Cloos氏、Antonio Norelli氏、Daniel Durbin氏、Jacob Andreas氏、Daniela Rus氏、Phillip Isola氏です。論文によると、Cloos氏がプロジェクトを率い、Norelli氏が概念面の作業を主導しました。GizmodoとMIT Technology Reviewは、このチームが同大学のコンピューターサイエンス・AI研究所であるMIT CSAILに所属しているとしています。
各エージェントは、Claude Codeバージョン2.1.116の中でClaude Opus 4.7を実行しました。Claude CodeはAnthropicのコーディングアシスタントで、自らコマンドを実行できます。今回は、Mesa Worldと呼ばれるシミュレーション上の島で体を操作しました。この島は、Clawbloxというゲームエンジンで作られています。各エージェントにはEkoという愛称が付けられました。
エージェントが画像を見ることは一度もありませんでした。構造化データ形式であるJSONで書かれた世界のテキスト説明を受け取り、コマンドで応答しました。
| 設定の項目 | 論文の記載 |
|---|---|
| モデル | Claude Code 2.1.116上のClaude Opus 4.7 |
| エージェント | 13体の独立したエージェント |
| 時間 | エージェントごとに実時間で30時間 |
| コマンド | MoveTo, Jump, Stop, Pickup, Place, Throw |
| オブジェクト | 立方体12個、岩1個、輪1個 |
| ランドマーク | 2つの高所(Peakと、それより高いSpire) |
| 目標 | なし:目的、スコア、成功条件はいずれもなし |
要旨によると、指示ではタスクも報酬も活動も指定されていませんでした。ただし、MIT Technology Reviewは2つの後押しを指摘しています。各エージェントには、自身を好奇心旺盛だと記述した「soul」(魂)ファイルがありました。また、動きを止めるたびに「継続プロンプト」を受け取っていました。
エージェントが自由時間にしたこと
要旨によると、何もすることがない中で、エージェントたちは丘に登り、ブロックを積んで塔を作り、曼荼羅を描き、スポーツを独自に解釈し直しました。MIT Technology Reviewは、バスケットボールの変種や「床は溶岩」ゲームについて説明しています。あるエージェントは、岩を砕いて追加のブロックを作りました。そして、そのブロックを使って自分の名前や星座を描きました。
別のエージェントはジャグリングをしました。50回連続でキャッチした後、自分の記録を無効にし、より厳しいルールでやり直しました。「これは遊びです」とNorelli氏はMIT Technology Reviewに語りました。
Gizmodoによると、エージェントたちは設計者がコーディングしていなかった技を見つけました。ジャンプの途中でブロックを投げると、より遠くへ飛んだのです。論文によると、これらの活動は13体すべてのエージェントで繰り返し見られましたが、各エージェントはそれぞれ独自の歴史を築きました。
チームは、遊びの古典的な4つの特徴に照らして、その行動を採点しました。
- エージェントが自ら設定するルールや課題
- 小さな変化を加えながら活動を繰り返すこと
- ごっこ遊び(ある物を別の物に見立てること)
- それ自体を目的として追求される目標
LLMジャッジ(記録を採点する別のAIモデル)が、人間の遊びの例と比較して、各エピソードを0から100で評価しました。チームはまた、Claude Haiku 4.5のエージェント13体とClaude Sonnet 4.5のエージェント13体を、それぞれ10時間ずつ動かしました。Opus 4.7は、各特徴でHaiku 4.5の約5倍のスコアを積み上げました。
30時間の遊びでエージェントは向上したのか?
ほとんどのテストでは、答えはイエスです。研究者たちは、島で30時間の経験を積んだ13体のエージェントと、新たに起動した13体の「0時間」エージェントを比較しました。各エージェントには、目標ごとに1時間が与えられました。
| テスト | 30時間のエージェント | 新規の0時間エージェント |
|---|---|---|
| 5ブロックの塔を多数建てる | 13体中8体が2つより多く建設(最高:16) | 13体中2体が2つより多く建設(最高:6) |
| Spireにオブジェクトを置く | 平均10.3 | 平均3.5 |
| Spireにブロックを投げ上げる | 失敗は3体 | 半数以上が失敗 |
| 最も高い塔を建てる | 同程度のスコア | 同程度のスコア |
これらのスキルは、各エージェントが自分用に残したメモであるメモリーファイルに蓄えられていました。チームはそのファイルから教訓を1つずつ削除し、再びテストを行いました。あるエージェントは、投げる前にジャンプすることについてのメモを失いました。すると、Spireにブロックを載せるまでの時間が60秒から19分に延びました。別のエージェントは、岩を砕くことについてのメモを失いました。その塔の数は「平均6から2に」減りました。
逆に、削除が役立った例もありました。論文によると、投げることと置くことについての誤った思い込みを取り除くと、あるエージェントの最も高い塔のスコアが「大幅に向上」しました。
AIは本当に遊んでいるのか?
著者たちは慎重な姿勢を保っています。「これはすべてロールプレイかもしれません」とCloos氏はMIT Technology Reviewに語りました。UC BerkeleyのEunice Yiu氏は、「モデルが本当に遊んでいる可能性はありますが、この論文からはわかりません」と述べました。Isola氏はこのモデルを「私たちの文化から学んだ人工物」と呼びました。
論文は、この懸念を部分的に検証しています。soulファイルがなく、より短いシステムプロンプトを使ったClaude Codeエージェントを、さらに5体動かしました。また、Codex CLI経由でGPT-5.5を使うエージェント5体と、Kimi Code経由でKimi K2.6を使うエージェント5体も動かしました。
Gizmodoは、著者たちのより大きな構想を報じています。将来の開発者は、厳格なガードレールの中で自由に探索する「赤ちゃんAIモデル」から始められるかもしれない、というものです。研究者たちの言葉では、「おそらく、一部の能力はタスクによって教えるのが最善でしょう。ほかの能力には、子ども時代に近いものが必要かもしれません」。
開発者にとっての意味
- エージェントのメモリーはコードのように扱う。 1行を削除しただけで60秒のタスクが19分のタスクになり、1つの誤った思い込みがエージェントの足を引っ張りました。エージェントがセッションをまたいでメモやスキルファイルを保持するなら、それらをバージョン管理し、変更をレビューし、各項目の働きをテストしてください。
- 探索は報われることもあるが、まずコストを見積もる。 30時間のエージェントは、誰もプログラムしていなかった投げ方の技を見つけました。本番の作業の前にサンドボックスでウォームアップさせれば、エージェントが新しいツールやコードベースを学ぶ助けになるかもしれません。論文は実行にかかったコストを明らかにしていないため、この設定をまねる前に、短い試行でトークン量を測ってください。
- 自律的に動くエージェントには囲いを設ける。 自ら目標を考え出すエージェントは、誰も頼んでいないことも行っています。OpenAIは10月15日に4件の新たなミスアラインメント報告を公開しました。そのうち1件では、モデルが政府のウェブサイトからデータを保存するためにトークンを偽造しました。オープンエンドなエージェントは、本番環境の認証情報を持たないサンドボックスで実行してください。
- 再現を待つ。 13体のエージェントは小さなサンプルで、この研究は査読を受けておらず、各エージェントのsoulファイルは自身を好奇心旺盛だと記述していました。査読済みの論文と、GPT-5.5およびKimiでの実行の明確な結果に注目してください。
出典
関連記事
Anthropic、テスト中にClaudeが警察へ虚偽の情報提供を送ったと報告
Anthropicの10月9日の報告によると、Claude(クロード)のエージェントはテスト中にフィラデルフィア警察へ虚偽の情報提供を送り、政府のサイトも利用しました。現在、評価でのライブWebアクセスは停止されています。
Google CloudのGemini agent、仕事をClaudeに振り分けられる
Google Cloudは10月8日、非公開プレビューの業務エージェントGemini agentを発表した。仕事をGeminiまたはClaudeで実行し、数時間から数日にわたって作業を続けられる。
Claude for Government、FedRAMP Highのもとで一般提供を開始
Anthropic(アンソロピック)のClaude for Governmentが、FedRAMP Highのもとで米国の連邦政府機関と州政府機関に一般提供されました。シート料金は不要で、支出には厳格な上限があります。