Los pesos abiertos de Reflection Beam llegan bajo Apache 2.0
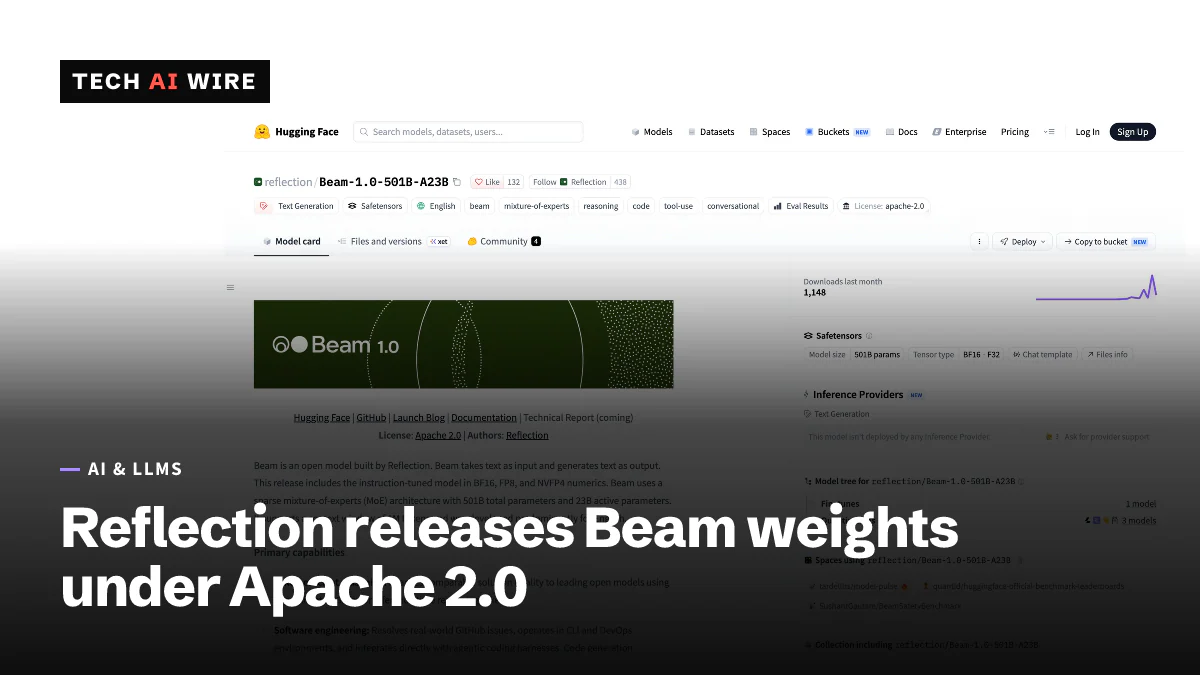
Reflection publicó en Hugging Face los pesos de Beam, con 501.000 millones de parámetros, el 16 de octubre de 2026 bajo Apache 2.0. Las versiones FP8 y de 4 bits caben en un servidor de 8 GPU.
4 min de lectura
En cifras
- total parameters, 23B active per token
- 501B
- token context window
- 1M
- enough for the FP8 and 4-bit versions
- 8 GPUs
- Terminal-Bench 2.1 score, BF16
- 80.1
- DeepSeek V4.1 Flash
- 90.6%
- Kimi K3
- 85%
- Reflection Beam
- 80.1%
- Muse Spark Open
- 76.4%
Reflection publicó en Hugging Face los pesos de Beam, su modelo de IA de 501.000 millones de parámetros, el 16 de octubre de 2026, bajo la licencia Apache 2.0. Apache 2.0 permite a cualquiera usar y modificar el modelo, y vender productos basados en él, con pocas condiciones. Eso convierte a Beam en uno de los modelos más grandes disponibles sin términos de licencia propios. Además, sus versiones comprimidas caben en un solo servidor de ocho GPU.
El lanzamiento cumple la promesa que hizo Reflection al anunciar Beam el 5 de octubre. Entonces, los pesos estaban previstos para «más adelante este mes». «Beam es nuestro primer modelo de pesos abiertos», escribió la empresa en su publicación de lanzamiento.
Qué publicó Reflection
Beam es un modelo disperso de mezcla de expertos (MoE). Sus parámetros se dividen en muchas redes expertas más pequeñas, y solo unas pocas se ejecutan para cada token, es decir, una palabra o parte de una palabra. La ficha del modelo en Hugging Face recoge los detalles:
| Especificación | Beam-1.0-501B-A23B |
|---|---|
| Parámetros totales | 501.300 millones |
| Activos por token | 23.400 millones |
| Expertos y capas | 256 expertos, 52 capas |
| Ventana de contexto | 1 millón de tokens |
| Entrada | Solo texto, sobre todo en inglés |
| Formatos de los pesos | BF16, FP8 y NVFP4 |
| Licencia | Apache 2.0 |
La ficha lo describe como el modelo ajustado para instrucciones, la versión entrenada para seguir peticiones. Reflection también publicó un modelo borrador más pequeño para la decodificación especulativa, una técnica que acelera la generación de texto. Añadió kernels fusionados, configuraciones listas para varios programas que sirven modelos y un Beam Safety Technical Report. Un informe técnico completo sigue figurando como pendiente. Las recetas de autodestilación llegarán «en los próximos días», según SiliconANGLE.
Reflection también lanzó Mirror CLI, un agente de programación que funciona en un terminal, según VentureBeat. La empresa llama a todo el paquete un «sistema operativo abierto para agentes».
Cómo puntúan las versiones comprimidas
La cuantización guarda los números de un modelo con menos bits, lo que reduce la memoria a costa de algo de precisión. En las pruebas de la propia Reflection, ese coste es pequeño:
| Benchmark | BF16 | FP8 | NVFP4 |
|---|---|---|---|
| SWE-bench Verified | 81,6 | 80,2 | 80,7 |
| SWE-Bench Pro v1 | 66,1 | 65,9 | 65,6 |
| Terminal-Bench 2.1 | 80,1 | 78,9 | 78,4 |
| GPQA Diamond | 90,6 | 90,3 | 89,3 |
| LiveCodeBench | 88,3 | 88,1 | 87,4 |
Las versiones de 8 y 4 bits caben en un servidor con ocho GPU H100, H200 o GB300, según VentureBeat. La versión completa de 16 bits necesita «decenas de GPU».
Frente a sus rivales, Beam no es el que más puntúa. El gráfico muestra las cifras de Terminal-Bench 2.1 que recopiló VentureBeat. V4.1 Flash, de DeepSeek, lidera con 90,6, por delante del 80,1 de Beam. Beam supera a Muse Spark Open de Meta, que obtuvo 76,4.
La propuesta: menos tokens
El argumento de Reflection se basa en la eficiencia, no en las puntuaciones brutas. Afirma que Beam iguala a GLM-5.2 en razonamiento avanzado con entre tres y cuatro veces menos cómputo de inferencia, sin contar el procesamiento del prompt. El modelo está entrenado para llegar a las respuestas con menos tokens de razonamiento.
«No renuncias a nada. Simplemente lo penalizas en función de cuántos tokens puede usar», dijo a VentureBeat Ioannis Antonoglou, cofundador y CTO de Reflection. VentureBeat calcula que Muse Spark Open usa unas 1,8 veces el cómputo por token de Beam.
Reflection no ha fijado un precio. La beta de su plataforma es «gratis para empezar», dice la empresa, y enumera más de 40 socios de lanzamiento. Dell y HPE instalarán Beam en el hardware propio de los clientes.
El lanzamiento llega después de que el Financial Times informara el 10 de octubre de que Nvidia mantiene conversaciones iniciales para comprar Reflection o invertir más. Antonoglou lo calificó de «rumores infundados», sin confirmar ni negar las conversaciones, según VentureBeat. Describió a Nvidia como «un socio e inversor cercano».
Qué significa esto para los desarrolladores
- Empieza con FP8 o NVFP4. Las cifras de Reflection sitúan las versiones comprimidas a unos dos puntos de la precisión completa. Caben en un servidor de ocho GPU en lugar de un clúster de varios servidores.
- Cuenta tokens por tarea, no precio por token. Reflection afirma que Beam llega a las respuestas con menos tokens. Mide el total de tokens y el tiempo en tus propias tareas para comprobarlo, porque ahí es donde aparece cualquier ahorro.
- La licencia es la parte sencilla. Apache 2.0 no impone topes de ingresos ni términos propios. La revisión legal debería ser más corta que con modelos bajo licencias propias, como la de Muse Spark Open.
- Trata las puntuaciones como cifras del proveedor. Todos los benchmarks de este artículo vienen de Reflection o de una ficha de modelo. Las pruebas independientes ya pueden empezar porque los pesos son públicos.
- Atento a lo que viene. El informe técnico completo y las recetas de autodestilación aún están por llegar. También cualquier resultado de las conversaciones con Nvidia de las que se ha informado, que podría cambiar quién controla la hoja de ruta del modelo.
Fuentes
- Beam is now available - Reflection
- reflection/Beam-1.0-501B-A23B model card - Hugging Face
- Reflection's Beam aims to undercut Chinese open models with fewer tokens, not cheaper tokens - VentureBeat
- Reflection AI open-sources Beam's weights, post-training recipes - SiliconANGLE
Artículos relacionados
StepFun Step 5 Preview: modelo para agentes de 600B con pesos abiertos
Step 5 Preview de StepFun, un modelo de 600B parámetros con 27B activos y un contexto de 1M de tokens, está en Hugging Face tras un mes solo por API a 1 y 2,70 dólares por millón.
Reflection AI lanza Beam, un modelo de pesos abiertos con 501.000 millones de parámetros
Beam, de Reflection AI, tiene 501.000 millones de parámetros pero usa 23.000 millones por token, obtiene 80,9 en SWE-Bench Verified y publicará sus pesos bajo Apache 2.0 más adelante en octubre.
Ling-3.1-flash: Ant Group abre un modelo de 560B bajo licencia MIT
inclusionAI, de Ant Group, publicó los pesos de Ling-3.1-flash bajo la licencia MIT: 560B parámetros, 25B activos por token y un contexto de 1M de tokens.