Nvidia Nemotron 3.5 Super VL erscheint mit offenen 120B-Gewichten
Nvidias Nemotron 3.5 Super VL ist ein Open-Weight-Modell mit 120 Mrd. Parametern, davon 12 Mrd. aktiv, das Text, Bilder und Video liest, unter der OpenMDW-Lizenz.
3 Min. Lesezeit
Die Zahlen
- total parameters / parameters active per token
- 120B / 12B
- tokens of context, at most
- 1M
- SWE-bench Verified score of the BF16 model, per Nvidia's model card
- 71.1
- per GPU per year for Nvidia's production software license
- $4,500
- Super VL, base
- 28%
- Claude Opus 5
- 38%
- Super VL, post-trained
- 72%
Nvidia hat am 15. Oktober 2026 Nemotron 3.5 Super VL veröffentlicht, ein Open-Weight-KI-Modell, das Text, Bilder und Video liest und in Textform antwortet. Es hat 120 Milliarden Parameter, aber nur 12 Milliarden arbeiten pro Token, was den Betrieb schnell und günstig hält. Nvidia führt einen einzelnen DGX-Spark-Desktop unter den unterstützten Setups, sodass Teams ein leistungsfähiges multimodales Modell auf eigener Hardware betreiben können.
„Open Weight“ bedeutet, dass jeder das trainierte Modell herunterladen und ausführen kann. „VL“ steht für Vision-Language: Das Modell nimmt Bilder und Video als Eingabe an, nicht nur Text.
Was Nvidia veröffentlicht hat
Super VL ist eines von drei Nemotron-3.5-Modellen, die Nvidia am 15. Oktober angekündigt hat, laut VentureBeat:
| Modell | Größe | Gebaut für |
|---|---|---|
| Super VL | 120B gesamt, 12B aktiv | Dokumente, Diagramme, Bildschirme und Video für Agenten |
| Bolt 74B-A9B | 74B gesamt, 9B aktiv, 24 GB | Agenten auf lokalen Rechnern |
| Bolt E4B | 4 GB | Chat und Agenten auf dem Gerät, erscheint am 23. Oktober |
Die Gewichte von Super VL liegen auf Hugging Face unter der OpenMDW-Lizenz, Version 1.1. Laut Modellkarte ist es „bereit für die kommerzielle oder nicht-kommerzielle Nutzung“.
Wie das Modell aufgebaut ist
Super VL ist ein Mixture-of-Experts-Modell (MoE). Jede Schicht enthält 512 kleine Expertennetze, und ein Router wählt für jedes Token einige davon aus. Das Modell kombiniert drei Arten von Schichten: Mamba-2, Standard-Attention und MoE. Mamba-2 ist eine Bauweise, die lange Eingaben günstig verarbeitet. Ein Vision-Encoder namens C-RADIO wandelt Bilder in Eingaben um, die das Modell lesen kann.
Nvidia liefert die Gewichte in zwei Genauigkeiten. Die BF16-Version ist die vollständige Referenz. Die NVFP4-Version speichert die meisten Gewichte in 4 Bit, um Speicher zu sparen, und wurde darauf trainiert, dem BF16-Modell zu entsprechen. Die Karte meldet nur kleine Unterschiede zwischen beiden.
Weitere Details aus der Karte:
- Bis zu 1 Million Tokens Kontext, je nach Setup.
- Videoeingabe als MP4-Dateien mit bis zu 2 Minuten Länge.
- Multi-Token-Prediction, die mehrere Tokens auf einmal entwirft, um Antworten zu beschleunigen.
- Unterstützte Setups von einem DGX Spark oder einem GB200 bis zu zwei H100-Karten. Lokal läuft es auch auf RTX Spark und RTX Pro 6000 über llama.cpp oder Unsloth.
Die Benchmark-Angaben
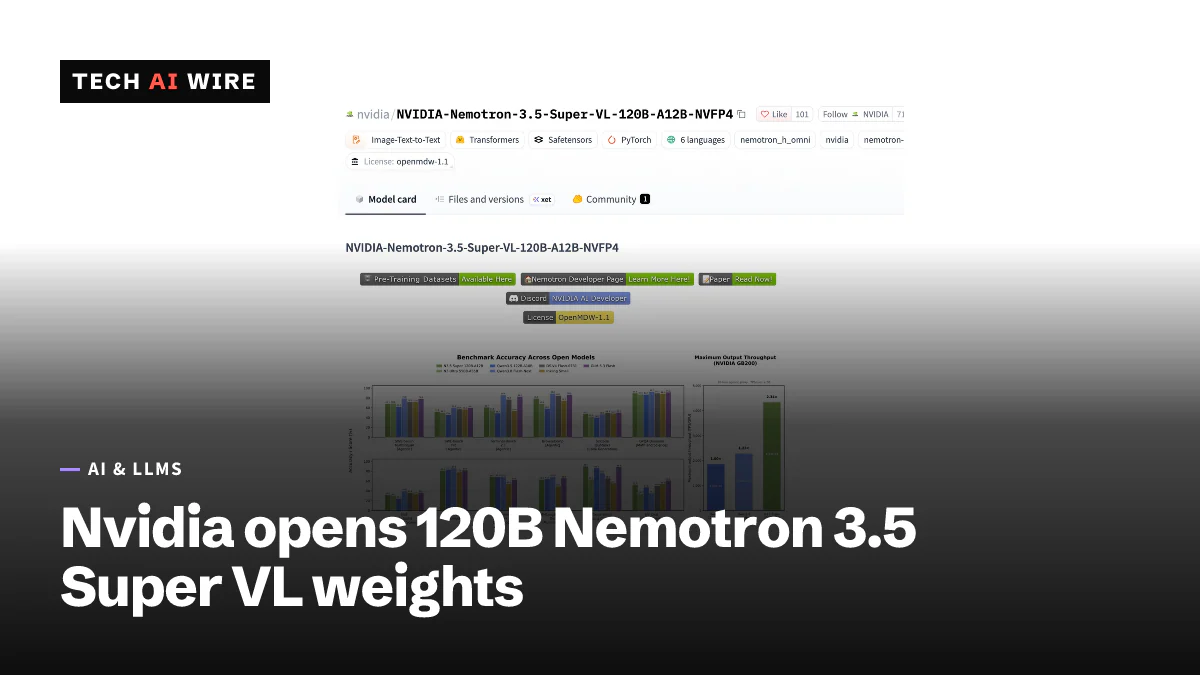
Nvidias Modellkarte nennt starke allgemeine Werte für das BF16-Modell. Dazu gehören 71,10 auf SWE-bench Verified, einem Coding-Test, und 89,52 auf GPQA-Diamond, einem Wissenschaftstest. Auf OSWorld-Verified, das misst, wie gut ein Modell einen Computer bedient, erreicht es 51,14.
Die zentrale Behauptung verlangt Vorsicht. Laut Nvidia schlagen Versionen von Super VL, die für fünf bestimmte Aufgaben nachtrainiert wurden, Claude Opus 5 und GPT-6.1 Sol bei genau diesen Aufgaben. Bei Versicherungsfällen stieg die Genauigkeit von etwa 28 % auf 72 %, gegenüber etwa 38 % für Claude Opus 5. VentureBeat weist darauf hin, dass Nvidia weder die Aufgabendefinitionen noch die Stichprobengrößen oder die Testmethode veröffentlicht hat.
Bei der allgemeinen Intelligenz kommt Super VL laut VentureBeat auf etwa 26 Punkte im Artificial Analysis Index. GLM-5.3-Flash erreicht 42 und Qwen3.8-Flash-Next 40. Sein Vorteil ist die Geschwindigkeit: etwa 625 Tokens pro Sekunde auf vier B200-GPUs, gegenüber etwa 125 für Inkling Small, ein Modell mit ähnlichem Wert.
Lizenz und Kosten
Die Gewichte sind unter OpenMDW kostenlos. Laut VentureBeat verkauft Nvidia zudem eine Produktions-Softwarelizenz für 4.500 $ pro GPU und Jahr. Modal, ein Cloud-Anbieter, bietet das Modell bereits auf dedizierten Endpunkten mit sekundengenauer Abrechnung an.
Das Release kommt, während Nvidia auf den Abschluss seines Kaufs von Hugging Face wartet, über den wir berichtet haben, als Nvidia den Deal bestätigte. VentureBeat zufolge soll der Deal im ersten Halbjahr 2027 abgeschlossen werden.
Was das für Entwickler bedeutet
Super VL ist ein starker Kandidat, wenn Sie ein Modell brauchen, das Screenshots, gescannte Dokumente und kurze Videos liest, und Sie es selbst hosten wollen. Beginnen Sie mit dem NVFP4-Build auf Blackwell-Hardware, wo die 4-Bit-Berechnung laut Nvidias Karte nativ läuft.
Wählen Sie es nicht für reines Reasoning. Sein Indexwert liegt hinter mehreren offenen Modellen, die im Betrieb kleiner sind. Sein Argument ist die Geschwindigkeit pro GPU plus die Möglichkeit, es für eine eng begrenzte Aufgabe feinzutunen.
Dieser zweite Punkt ist die eigentliche Lehre aus Nvidias Diagramm. Ein nachtrainiertes Modell mit 12 Mrd. aktiven Parametern schlug Frontier-Modelle bei seinen eigenen, eng begrenzten Aufgaben. Wenn Sie eine wiederkehrende Aufgabe und eigene gelabelte Daten haben, testen Sie ein feingetuntes offenes Modell, bevor Sie für jeden Aufruf Frontier-Preise zahlen. Prüfen Sie die OpenMDW-Bedingungen vor dem Ausliefern mit Ihrer Rechtsabteilung, wie bei jeder neuen Lizenz.
Quellen
Ähnliche Artikel
Meta Muse Spark Open: 816B offene Gewichte veröffentlicht
Meta hat Muse Spark Open veröffentlicht, ein Modell mit offenen Gewichten, 816B Parametern, davon 42B aktiv, und 1M Token Kontext, auf Hugging Face und drei Cloud-Plattformen.

Mistral Large 4 startet mit 1,05 Billionen Parametern
Mistral Large 4 ist ein Open-Weight-MoE-Modell mit 1,05 Billionen Parametern und 1 Million Token Kontext. Die API-Vorschau kostet 1,36 $ pro Million Eingabetoken. Die Gewichte folgen im Oktober.
Reflection AI stellt Beam vor, ein Open-Weight-Modell mit 501 Milliarden Parametern
Beam von Reflection AI hat 501 Milliarden Parameter, nutzt aber 23 Milliarden pro Token, erreicht 80,9 bei SWE-Bench Verified, und die Gewichte erscheinen später im Oktober unter Apache 2.0.