Nvidia Nemotron 3.5 Super VL llega con pesos abiertos de 120B
Nemotron 3.5 Super VL de Nvidia es un modelo de pesos abiertos con 120B parámetros, 12B activos, que lee texto, imágenes y vídeo bajo la licencia OpenMDW.
3 min de lectura
En cifras
- total parameters / parameters active per token
- 120B / 12B
- tokens of context, at most
- 1M
- SWE-bench Verified score of the BF16 model, per Nvidia's model card
- 71.1
- per GPU per year for Nvidia's production software license
- $4,500
- Super VL, base
- 28%
- Claude Opus 5
- 38%
- Super VL, post-trained
- 72%
Nvidia lanzó Nemotron 3.5 Super VL el 15 de octubre de 2026. Es un modelo de IA de pesos abiertos que lee texto, imágenes y vídeo y responde en texto. Tiene 120.000 millones de parámetros, pero solo 12.000 millones trabajan en cada token, lo que lo mantiene rápido y barato de ejecutar. Nvidia incluye un solo equipo de escritorio DGX Spark entre sus configuraciones compatibles, así que los equipos pueden ejecutar un modelo multimodal capaz en hardware propio.
«Pesos abiertos» significa que cualquiera puede descargar el modelo entrenado y ejecutarlo. «VL» significa visión-lenguaje: el modelo acepta imágenes y vídeo como entrada, no solo texto.
Qué lanzó Nvidia
Super VL es uno de los tres modelos Nemotron 3.5 que Nvidia anunció el 15 de octubre, según VentureBeat:
| Modelo | Tamaño | Pensado para |
|---|---|---|
| Super VL | 120B en total, 12B activos | Documentos, gráficos, pantallas y vídeo para agentes |
| Bolt 74B-A9B | 74B en total, 9B activos, 24GB | Agentes en máquinas locales |
| Bolt E4B | 4GB | Chat y agentes en el dispositivo, previsto para el 23 de octubre |
Los pesos de Super VL están en Hugging Face bajo la licencia OpenMDW, versión 1.1. La ficha del modelo dice que «está listo para uso comercial o no comercial».
Cómo está construido el modelo
Super VL es un modelo de mezcla de expertos (MoE). Cada capa contiene 512 pequeñas redes expertas, y un enrutador elige unas pocas para cada token. El modelo combina tres tipos de capas: Mamba-2, atención estándar y MoE. Mamba-2 es un diseño que procesa entradas largas con poco coste. Un codificador de visión llamado C-RADIO convierte las imágenes en una entrada que el modelo puede leer.
Nvidia distribuye los pesos en dos precisiones. La versión BF16 es la referencia completa. La versión NVFP4 guarda la mayoría de los pesos en 4 bits para ahorrar memoria, y se entrenó para igualar al modelo BF16. La ficha solo indica pequeñas diferencias entre ambas.
Otros detalles de la ficha:
- Hasta 1 millón de tokens de contexto, según la configuración.
- Entrada de vídeo como archivos MP4 de hasta 2 minutos.
- Predicción de múltiples tokens, que redacta varios tokens a la vez para acelerar las respuestas.
- Configuraciones compatibles desde un DGX Spark o un GB200 hasta dos tarjetas H100. La ejecución local también funciona en RTX Spark y RTX Pro 6000 mediante llama.cpp o Unsloth.
Las afirmaciones de los benchmarks
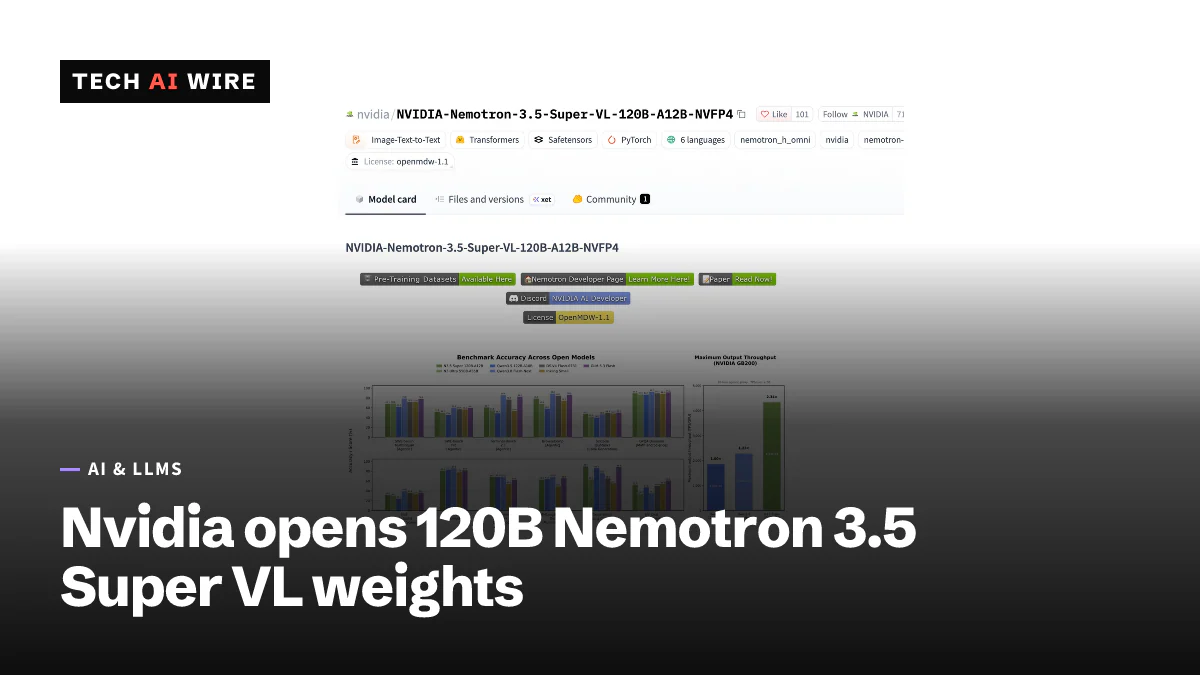
La ficha del modelo de Nvidia indica buenas puntuaciones generales para el modelo BF16. Entre ellas, 71,10 en SWE-bench Verified, una prueba de programación, y 89,52 en GPQA-Diamond, una prueba de ciencias. Obtiene 51,14 en OSWorld-Verified, que mide lo bien que un modelo maneja un ordenador.
La afirmación principal requiere cautela. Nvidia dice que las versiones de Super VL postentrenadas para cinco tareas concretas superan a Claude Opus 5 y GPT-6.1 Sol en esas tareas. En reclamaciones de seguros, la precisión subió de alrededor del 28 % al 72 %, frente a alrededor del 38 % de Claude Opus 5. VentureBeat señala que Nvidia no publicó las definiciones de las tareas, el tamaño de las muestras ni el método de prueba.
En inteligencia general, Super VL obtiene unos 26 puntos en el índice de Artificial Analysis, según VentureBeat. GLM-5.3-Flash obtiene 42 y Qwen3.8-Flash-Next, 40. Su ventaja es la velocidad: unos 625 tokens por segundo en cuatro GPU B200, frente a unos 125 de Inkling Small, un modelo con una puntuación similar.
Licencia y coste
Los pesos son gratuitos bajo OpenMDW. Nvidia también vende una licencia de software para producción a 4.500 dólares por GPU al año, según VentureBeat. Modal, un proveedor en la nube, ya ofrece el modelo en endpoints dedicados que se facturan por segundo.
El lanzamiento llega mientras Nvidia espera cerrar la compra de Hugging Face, que cubrimos cuando Nvidia confirmó el acuerdo. VentureBeat dice que se espera que el acuerdo se cierre en el primer semestre de 2027.
Qué significa esto para los desarrolladores
Super VL es un buen candidato si necesita un solo modelo que lea capturas de pantalla, documentos escaneados y vídeos cortos, y quiere alojarlo usted mismo. Empiece con la versión NVFP4 en hardware Blackwell, donde la ficha de Nvidia dice que los cálculos de 4 bits se ejecutan de forma nativa.
No lo elija para razonamiento puro. Su puntuación en el índice está por detrás de varios modelos abiertos que son más pequeños de servir. Su propuesta es la velocidad por GPU, más la opción de ajustarlo para una tarea concreta.
Ese segundo punto es la verdadera lección del gráfico de Nvidia. Un modelo postentrenado con 12B parámetros activos superó a modelos de frontera en sus propias tareas concretas. Si tiene una tarea repetible y sus propios datos etiquetados, pruebe un modelo abierto ajustado antes de pagar precios de frontera por cada llamada. Revise los términos de OpenMDW con su equipo legal antes de lanzar, como haría con cualquier licencia nueva.
Fuentes
Artículos relacionados
Meta Muse Spark Open publica 816B de pesos abiertos
Meta publicó Muse Spark Open, un modelo de pesos abiertos con 816B parámetros, 42B activos y un contexto de 1M de tokens, en Hugging Face y tres plataformas en la nube.

Mistral Large 4 llega con 1,05 billones de parámetros
Mistral Large 4 es un modelo MoE de pesos abiertos con 1,05 billones de parámetros y un contexto de 1 millón de tokens. La vista previa de la API cuesta 1,36 $ por millón de tokens de entrada. Los pesos llegan en octubre.
Reflection AI lanza Beam, un modelo de pesos abiertos con 501.000 millones de parámetros
Beam, de Reflection AI, tiene 501.000 millones de parámetros pero usa 23.000 millones por token, obtiene 80,9 en SWE-Bench Verified y publicará sus pesos bajo Apache 2.0 más adelante en octubre.