Nvidia publie Nemotron 3.5 Super VL, un modèle à poids ouverts de 120B
Nemotron 3.5 Super VL de Nvidia est un modèle à poids ouverts de 120B paramètres, dont 12B actifs, qui lit le texte, les images et la vidéo sous licence OpenMDW.
3 min de lecture
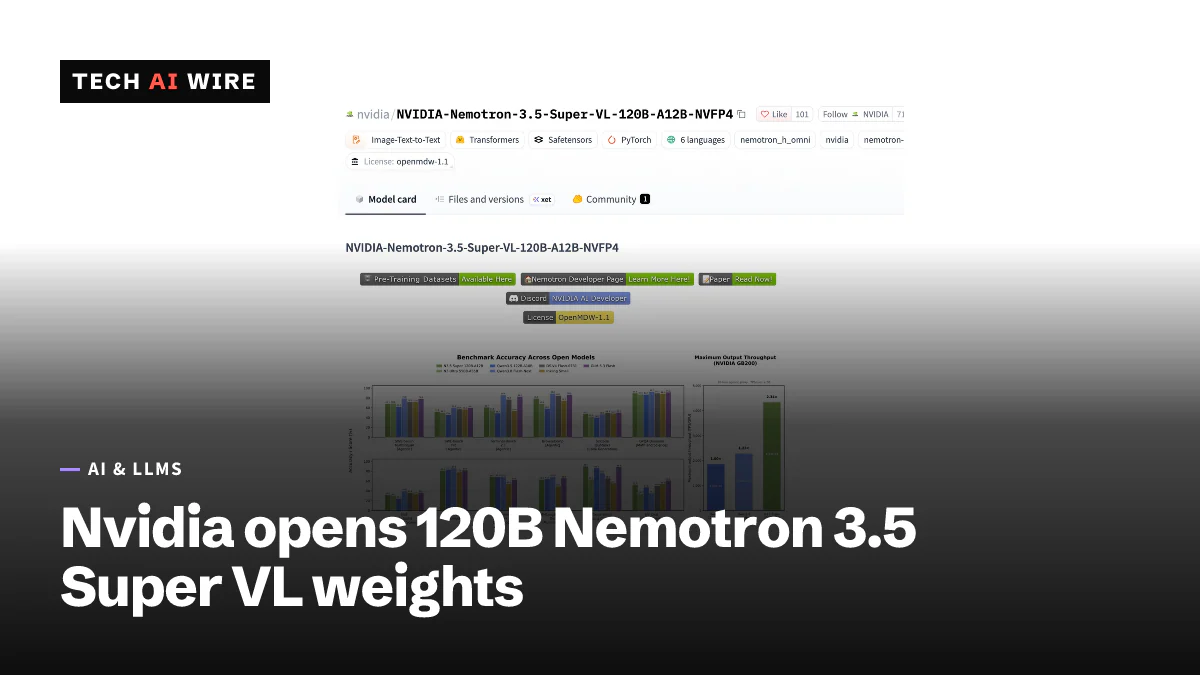
En chiffres
- total parameters / parameters active per token
- 120B / 12B
- tokens of context, at most
- 1M
- SWE-bench Verified score of the BF16 model, per Nvidia's model card
- 71.1
- per GPU per year for Nvidia's production software license
- $4,500
- Super VL, base
- 28%
- Claude Opus 5
- 38%
- Super VL, post-trained
- 72%
Nvidia a publié Nemotron 3.5 Super VL le 15 octobre 2026. C'est un modèle d'IA à poids ouverts qui lit le texte, les images et la vidéo, et qui répond en texte. Il compte 120 milliards de paramètres, mais seuls 12 milliards travaillent sur chaque token, ce qui le rend rapide et peu coûteux à exécuter. Nvidia cite un seul ordinateur de bureau DGX Spark parmi ses configurations prises en charge : les équipes peuvent donc faire tourner un modèle multimodal performant sur du matériel qui leur appartient.
« Poids ouverts » signifie que n'importe qui peut télécharger le modèle entraîné et l'exécuter. « VL » signifie vision-langage (vision-language) : le modèle accepte des images et de la vidéo en entrée, pas seulement du texte.
Ce que Nvidia a publié
Super VL est l'un des trois modèles Nemotron 3.5 annoncés par Nvidia le 15 octobre, selon VentureBeat :
| Modèle | Taille | Conçu pour |
|---|---|---|
| Super VL | 120B au total, 12B actifs | Documents, graphiques, écrans et vidéo pour les agents |
| Bolt 74B-A9B | 74B au total, 9B actifs, 24 Go | Agents sur machines locales |
| Bolt E4B | 4 Go | Chat et agents sur l'appareil, attendu le 23 octobre |
Les poids de Super VL sont sur Hugging Face sous licence OpenMDW, version 1.1. La fiche du modèle indique qu'il « est prêt pour un usage commercial ou non commercial ».
Comment le modèle est construit
Super VL est un modèle à mélange d'experts (mixture-of-experts, MoE). Chaque couche contient 512 petits réseaux experts, et un routeur en choisit quelques-uns pour chaque token. Le modèle combine trois types de couches : Mamba-2, attention standard et MoE. Mamba-2 est une architecture qui traite les longues entrées à faible coût. Un encodeur de vision appelé C-RADIO transforme les images en entrées que le modèle peut lire.
Nvidia livre les poids en deux précisions. La version BF16 est la référence complète. La version NVFP4 stocke la plupart des poids sur 4 bits pour économiser de la mémoire, et a été entraînée pour égaler le modèle BF16. La fiche ne signale que de faibles différences entre les deux.
Autres détails tirés de la fiche :
- Jusqu'à 1 million de tokens de contexte, selon la configuration.
- Entrée vidéo sous forme de fichiers MP4 d'au plus 2 minutes.
- Prédiction multi-tokens, qui ébauche plusieurs tokens à la fois pour accélérer les réponses.
- Configurations prises en charge allant d'un seul DGX Spark ou d'un seul GB200 à deux cartes H100. L'exécution locale fonctionne aussi sur RTX Spark et RTX Pro 6000 via llama.cpp ou Unsloth.
Les résultats de benchmarks annoncés
La fiche du modèle de Nvidia affiche de bons scores généraux pour le modèle BF16. Parmi eux : 71,10 sur SWE-bench Verified, un test de code, et 89,52 sur GPQA-Diamond, un test scientifique. Il obtient 51,14 sur OSWorld-Verified, qui mesure la capacité d'un modèle à utiliser un ordinateur.
L'affirmation phare demande de la prudence. Nvidia affirme que des versions de Super VL post-entraînées pour cinq tâches précises battent Claude Opus 5 et GPT-6.1 Sol sur ces tâches. Sur les sinistres d'assurance, la précision est passée d'environ 28 % à 72 %, contre environ 38 % pour Claude Opus 5. VentureBeat note que Nvidia n'a publié ni la définition des tâches, ni la taille des échantillons, ni la méthode de test.
En intelligence générale, Super VL obtient environ 26 sur l'indice d'Artificial Analysis, rapporte VentureBeat. GLM-5.3-Flash obtient 42 et Qwen3.8-Flash-Next 40. Son atout est la vitesse : environ 625 tokens par seconde sur quatre GPU B200, contre environ 125 pour Inkling Small, un modèle au score similaire.
Licence et coût
Les poids sont gratuits sous OpenMDW. Nvidia vend aussi une licence logicielle de production à 4 500 dollars par GPU et par an, selon VentureBeat. Modal, un hébergeur cloud, propose déjà le modèle sur des points de terminaison dédiés facturés à la seconde.
Cette sortie intervient alors que Nvidia attend de finaliser son rachat de Hugging Face, que nous avons couvert quand Nvidia a confirmé l'accord. Selon VentureBeat, la finalisation de l'accord est attendue au premier semestre 2027.
Ce que cela signifie pour les développeurs
Super VL est un bon candidat si vous avez besoin d'un seul modèle capable de lire des captures d'écran, des documents numérisés et de courtes vidéos, et que vous voulez l'héberger vous-même. Commencez par la version NVFP4 sur du matériel Blackwell, où le calcul sur 4 bits s'exécute nativement, selon la fiche de Nvidia.
Ne le choisissez pas pour le raisonnement brut. Son score sur l'indice est inférieur à celui de plusieurs modèles ouverts moins lourds à servir. Ses arguments sont la vitesse par GPU et la possibilité de l'affiner pour une seule tâche précise.
Ce second point est la vraie leçon du graphique de Nvidia. Un modèle à 12B paramètres actifs, après post-entraînement, a battu des modèles de pointe sur ses propres tâches étroites. Si vous avez une tâche répétitive et vos propres données annotées, testez un modèle ouvert affiné avant de payer le prix des modèles de pointe à chaque appel. Faites vérifier les conditions d'OpenMDW par votre service juridique avant la mise en production, comme pour toute nouvelle licence.
Sources
Articles liés
Meta Muse Spark Open publie 816B de poids ouverts
Meta a publié Muse Spark Open, un modèle à poids ouverts de 816B paramètres, dont 42B actifs, avec un contexte de 1M de tokens, sur Hugging Face et trois plateformes cloud.

Mistral Large 4 arrive avec 1,05 billion de paramètres
Mistral Large 4 est un modèle MoE à poids ouverts de 1,05 billion de paramètres, avec un contexte de 1 million de tokens. L'aperçu API coûte 1,36 $ par million de tokens d'entrée. Les poids suivent en octobre.
Reflection AI lance Beam, un modèle à poids ouverts de 501 milliards de paramètres
Beam, de Reflection AI, compte 501 milliards de paramètres mais en utilise 23 milliards par jeton, obtient 80,9 sur SWE-Bench Verified et verra ses poids publiés sous Apache 2.0 plus tard en octobre.