Meta schränkt Klausel zum Web-Crawling in seinen Geschäftsbedingungen ein
Meta hat das Wort „train“ aus einer Klausel gestrichen, die ihm das Crawlen der Websites von Geschäftskunden erlaubt, wenige Tage bevor seine Commercial Terms am 30. Oktober 2026 in Kraft treten.
4 Min. Lesezeit
Die Zahlen
- date Meta's new Commercial Terms take effect, 2026
- Oct 30
- businesses using Meta's AI agents in WhatsApp and Messenger
- 1M+
- mentions of robots.txt in the new terms
- 0
Meta hat eine Klausel in seinen neuen Commercial Terms umgeschrieben, die es ihm erlaubte, die Websites seiner Geschäftskunden zu crawlen und die Inhalte zu nutzen, um seine Produkte zu trainieren („train“). Der überarbeitete Text, der spätestens seit dem 17. Oktober 2026 online ist, streicht das Wort „train“ nach einem Tag des Protests von Nachrichtenverlagen. Die Bedingungen treten weiterhin am 30. Oktober in Kraft. Sie gelten für fast jedes Unternehmen, das Meta-Anzeigen schaltet.
The Next Web und Unite.AI berichteten am 17. Oktober über die Änderung. Meta sagt, die Crawling-Formulierung habe immer nur für seine Werbe- und Geschäftsprodukte gegolten. Der neue Wortlaut stelle das lediglich klar.
Was die Klausel sagt
Die alten Commercial Terms vom 6. März 2024 enthielten überhaupt keine Crawling-Formulierung, berichtet PPC Land. Der neue Abschnitt 1 erlaubt Meta, „Web-Scraper, Bots, Roboter, Spider, Crawler und User Agents“ auf Domains einzusetzen, die „mit Ihren Produkten oder Dienstleistungen verbunden“ sind. Außerdem darf Meta „Test-Zugangsdaten erstellen“, also Konten, die eingerichtet werden, um in diese Websites zu gelangen.
Ein Crawler ist ein Programm, das Webseiten besucht und ihre Inhalte automatisch kopiert. Die Klausel legt fest, was Meta mit dem tun darf, was seine Crawler kopieren.
| Version | Wofür Meta gecrawlte Inhalte nutzen darf |
|---|---|
| Original, archiviert am 16. Oktober | „zur Bereitstellung, Entwicklung, Verbesserung, Erforschung, zum Training“ von Metas Produkten |
| Überarbeitet, archiviert am 17. Oktober | „zur Bereitstellung, Entwicklung, Verbesserung, Erforschung und Pflege von Werbe- und Geschäftsprodukten“ |
Unite.AI berichtet, dass auch im Lizenzabschnitt ein Satz wegfiel. Dieselbe überarbeitete Klausel steht in einer Vorschau von Metas Self-Serve Ad Terms, die am selben Tag in Kraft treten.
Wer betroffen ist
Die Bedingungen gelten für Metas Geschäftskunden, und das ist ein großer Kreis. The Register nennt alle, die Anzeigen schalten oder Marketingnachrichten versenden, Produkte verkaufen oder listen, Apps entwickeln oder eine Seite oder Gruppe verwalten. Nieman Lab stellte fest, dass fast jeder Nachrichtenverlag mindestens ein Meta-Geschäftskonto hat, ergänzt The Register. Es zitiert außerdem eine Zählung von Reuters, nach der mindestens eine Million Unternehmen Metas KI-Agenten in WhatsApp und Messenger nutzen.
Eine eigene Opt-out-Möglichkeit gibt es nicht. Unternehmen akzeptieren die Bedingungen, indem sie Metas kommerzielle Produkte weiter nutzen. Ablehnen können sie nur, indem sie die Nutzung beenden.
Warum Verlage protestierten
Nieman Lab berichtete am 15. Oktober als Erstes über die Klausel. Die News/Media Alliance, die Nachrichtenverlage vertritt, griff sie am nächsten Tag an. „Metas neue kommerzielle Nutzungsbedingungen sind empörend und wahrscheinlich illegal“, sagte Danielle Coffey, Präsidentin und CEO des Verbands, in The Register. Sie sagte, die Bedingungen dürften am 30. Oktober nicht in Kraft treten.
Meta-Sprecher Andy Stone nannte die ersten Berichte am 16. Oktober „falsch“. Er sagte, es gebe „keine Änderung daran, wie Meta Webcrawler nutzt“. Das Update sei „darauf ausgelegt, sicherzustellen, dass wir genaue Informationen über Produkte abrufen können, die auf Websites Dritter verkauft werden“, schrieb er laut PPC Land.
Die Korrektur hat den Streit nicht beigelegt. Der Verband sagt, Training sei aus den aufgezählten Zwecken gestrichen, aber nicht ausdrücklich verboten worden, berichtet The Next Web. PPC Land und The Register, die am 16. und 17. Oktober schrieben, beschrieben die Klausel weiterhin so, dass sie Training erlaubt. Ihre Berichte entstanden um die Zeit der Änderung.
Die Lücke bei robots.txt
Robots.txt ist eine kleine Datei auf einer Website, die Crawlern sagt, welche Seiten sie besuchen dürfen. Meta sagt, Inhaber könnten sie nutzen. „Inhaber von Inhalten können robots.txt-Flags nutzen, um ihre Präferenzen anzugeben“, schrieb Stone auf X.
Die Bedingungen selbst erwähnen robots.txt nie, stellen PPC Land und The Register beide fest. Eric Goldman, Juraprofessor an der Santa Clara University, sagte The Register, der Wortlaut verpflichte Meta nicht ausdrücklich, die Datei zu beachten. Tech AI Wire berichtete im September, dass Cloudflare begonnen hat, eine robots.txt-Regel gegen KI-Training anzubieten, eines der wenigen Signale, die Verlage haben.
Was das für Entwickler bedeutet
- Die Bedingungen zum 30. Oktober jetzt lesen. Wenn Ihr Unternehmen Meta-Anzeigen schaltet, Produkte listet oder eine Seite verwaltet, akzeptieren Sie diese Bedingungen, indem Sie nichts tun. Rechts- und Marketingteams haben weniger als zwei Wochen Zeit für eine Entscheidung.
- Sich nicht allein auf die Wortänderung verlassen. Die überarbeitete Klausel streicht „train“, doch der Verlegerverband sagt, Training sei nicht ausdrücklich ausgeschlossen. Behandeln Sie die Klausel als weit gefasst, bis Meta schriftlich etwas anderes erklärt.
- Ihre robots.txt-Regeln bewusst festlegen. Meta verweist Inhaber auf robots.txt, obwohl die Bedingungen nicht versprechen, die Datei zu beachten. Nennen Sie Metas Crawler in der Datei und protokollieren Sie ihre Besuche, damit Sie sehen, was sie tatsächlich tun.
- Auf Testkonten achten. Die Klausel erlaubt Meta, „Test-Zugangsdaten zu erstellen“. Websites mit Registrierungsschranken sollten auf neue Konten achten, die mit Metas Crawlern verbunden sind.
- Die Kosten eines Ausstiegs einplanen. Ablehnen kann man nur, indem man Metas Geschäftsprodukte nicht mehr nutzt. Für die meisten Unternehmen ist das keine echte Option. Deshalb kommt es auf den genauen Wortlaut an.
Quellen
- Meta drops 'train' from its website-crawling terms after backlash - The Next Web
- Meta Rewrites Web-Crawling Clause in Pending Commercial Terms - Unite.AI
- Meta's new terms let it crawl business websites to train AI from Oct 30 - PPC Land
- Meta grants itself right to scrape content from business customers for model training - The Register
Ähnliche Artikel
China plant Exportbeschränkungen für KI-Modelle und Chipdesigns
Chinas Entwurf setzt 23 KI-Technologien auf die Exportkontrollliste, von Modellen mit 2 Billionen Parametern bis zu Chipdesigns. Die Frist für Stellungnahmen endet am 15. November.
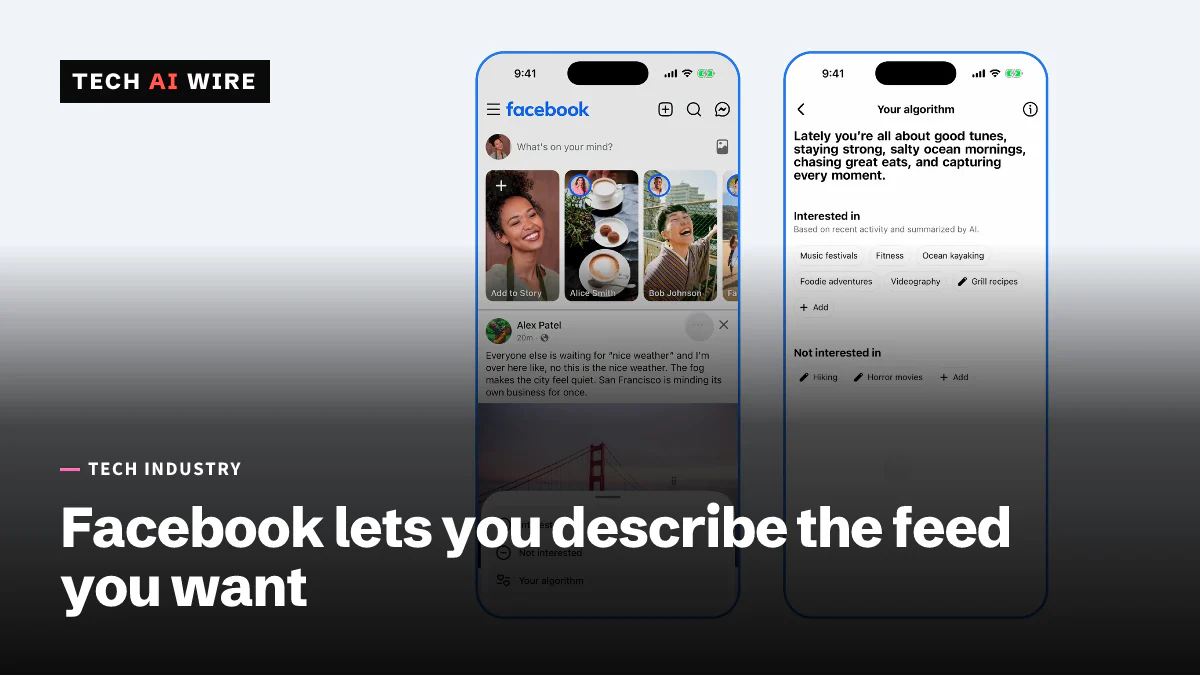
Facebooks Your Algorithm lässt Nutzer ihren Feed in eigenen Worten beschreiben
Meta hat Your Algorithm am 13. Oktober auf Facebook gestartet: Nutzer beschreiben in eigenen Worten, wovon sie in Feed und Reels mehr oder weniger sehen wollen.
Britische Aufsichtsbehörde Ofcom ermittelt gegen Meta wegen Instagram Instants
Ofcom prüft, ob Meta vor dem Start von Instagram Instants vorgeschriebene Risikobewertungen zur Sicherheit ausgelassen hat. Bußgelder können 18 Millionen £ oder 10 % des weltweiten Umsatzes erreichen.