Meta acota la cláusula de rastreo web de sus condiciones comerciales
Meta quitó la palabra «train» (entrenar) de una cláusula que le permite rastrear los sitios web de sus clientes empresariales, días antes de que sus Commercial Terms entren en vigor el 30 de octubre de 2026.
4 min de lectura
En cifras
- date Meta's new Commercial Terms take effect, 2026
- Oct 30
- businesses using Meta's AI agents in WhatsApp and Messenger
- 1M+
- mentions of robots.txt in the new terms
- 0
Meta ha reescrito una cláusula de sus nuevas Commercial Terms que le permitía rastrear los sitios web de sus clientes empresariales y usar el contenido para «train» (entrenar) sus productos. El texto revisado, ya publicado el 17 de octubre de 2026, quita la palabra «train» tras un día de protestas de los editores de noticias. Las condiciones siguen entrando en vigor el 30 de octubre, y cubren a casi cualquier empresa que publique anuncios en Meta.
The Next Web y Unite.AI informaron del cambio el 17 de octubre. Meta dice que el texto sobre rastreo siempre se aplicó solo a sus productos publicitarios y empresariales, y que la nueva redacción simplemente lo deja claro.
Qué dice la cláusula
Las anteriores Commercial Terms, fechadas el 6 de marzo de 2024, no incluían ningún texto sobre rastreo, informa PPC Land. La nueva sección 1 permite a Meta usar «extractores web, bots, robots, arañas, rastreadores y agentes de usuario» en dominios «asociados con sus productos o servicios». También permite a Meta «crear credenciales de prueba», es decir, cuentas creadas para entrar en esos sitios.
Un rastreador es un programa que visita páginas web y copia su contenido de forma automática. La cláusula decide qué puede hacer Meta con lo que copian sus rastreadores.
| Versión | Para qué puede usar Meta el contenido rastreado |
|---|---|
| Original, archivada el 16 de octubre | «para proporcionar, desarrollar, mejorar, investigar, entrenar» los productos de Meta |
| Revisada, archivada el 17 de octubre | «para proporcionar, desarrollar, mejorar, investigar y mantener productos publicitarios y empresariales» |
Unite.AI informa de que la sección de licencias también perdió una frase. La misma cláusula revisada aparece en una vista previa de las Self-Serve Ad Terms de Meta, que entran en vigor en la misma fecha.
A quién afecta
Las condiciones se aplican a los clientes empresariales de Meta, que forman un grupo amplio. The Register incluye a cualquiera que publique anuncios o envíe mensajes de marketing, venda productos o los publique en catálogos, cree apps, o gestione una página o un grupo. Nieman Lab descubrió que casi todos los editores de noticias tienen al menos una cuenta empresarial de Meta, añade The Register. También cita un recuento de Reuters de al menos un millón de empresas que usan los agentes de IA de Meta en WhatsApp y Messenger.
No hay una forma aparte de excluirse. Las empresas aceptan las condiciones al seguir usando los productos comerciales de Meta, y la única forma de rechazarlas es dejar de usarlos.
Por qué protestaron los editores
Nieman Lab informó por primera vez de la cláusula el 15 de octubre. La News/Media Alliance, que representa a los editores de noticias, la atacó al día siguiente. «Las nuevas condiciones comerciales de uso de Meta son escandalosas y probablemente ilegales», dijo Danielle Coffey, su presidenta y consejera delegada, en The Register. Dijo que no se podía permitir que las condiciones entraran en vigor el 30 de octubre.
El portavoz de Meta Andy Stone calificó de «falsos» los primeros informes el 16 de octubre. Dijo que no había «ningún cambio en cómo Meta usa los rastreadores web». La actualización estaba «pensada para garantizar que podamos obtener información precisa sobre los productos a la venta en sitios web de terceros», escribió, según PPC Land.
El arreglo no ha zanjado la disputa. La alianza dice que el entrenamiento se quitó de los usos enumerados, pero no se prohibió de forma expresa, informa The Next Web. PPC Land y The Register, que escribieron el 16 y el 17 de octubre, seguían describiendo la cláusula como si permitiera el entrenamiento. Sus informes se redactaron por las mismas fechas que el cambio.
El hueco de robots.txt
Robots.txt es un pequeño archivo de un sitio web que indica a los rastreadores qué páginas pueden visitar. Meta dice que los propietarios pueden usarlo. «Los propietarios de contenido pueden usar indicadores de robots.txt para expresar sus preferencias», escribió Stone en X.
Las condiciones en sí nunca mencionan robots.txt, señalan tanto PPC Land como The Register. Eric Goldman, profesor de Derecho en la Universidad de Santa Clara, dijo a The Register que la redacción no obliga de forma expresa a Meta a respetarlo. Tech AI Wire informó en septiembre de que Cloudflare empezó a ofrecer una regla de robots.txt contra el entrenamiento de IA, una de las pocas señales que tienen los editores.
Qué significa esto para los desarrolladores
- Lee ya las condiciones del 30 de octubre. Si tu empresa publica anuncios en Meta, publica productos en catálogos o gestiona una página, aceptas estas condiciones sin hacer nada. Los equipos legales y de marketing tienen menos de dos semanas para decidir.
- No te fíes solo del cambio de palabra. La cláusula revisada quita «train», pero el grupo de editores dice que el entrenamiento no está descartado de forma expresa. Trata la cláusula como amplia hasta que Meta diga lo contrario por escrito.
- Define tus reglas de robots.txt a propósito. Meta remite a los propietarios a robots.txt, aunque las condiciones no prometen respetarlo. Nombra los rastreadores de Meta en el archivo y registra sus visitas, para ver qué hacen en realidad.
- Vigila las cuentas de prueba. La cláusula permite a Meta «crear credenciales de prueba». Los sitios con registro obligatorio deben vigilar las cuentas nuevas vinculadas a los rastreadores de Meta.
- Prevé el coste de salida. La única forma de rechazarlas es dejar de usar los productos empresariales de Meta. Para la mayoría de las empresas no es una opción real, y por eso importa la redacción exacta.
Fuentes
- Meta drops 'train' from its website-crawling terms after backlash - The Next Web
- Meta Rewrites Web-Crawling Clause in Pending Commercial Terms - Unite.AI
- Meta's new terms let it crawl business websites to train AI from Oct 30 - PPC Land
- Meta grants itself right to scrape content from business customers for model training - The Register
Artículos relacionados
China prepara restricciones a la exportación de modelos de IA y diseños de chips
El borrador de China añade 23 tecnologías de IA a su lista de control de exportaciones, desde modelos de 2 billones de parámetros hasta diseños de chips. Los comentarios se cierran el 15 de noviembre.
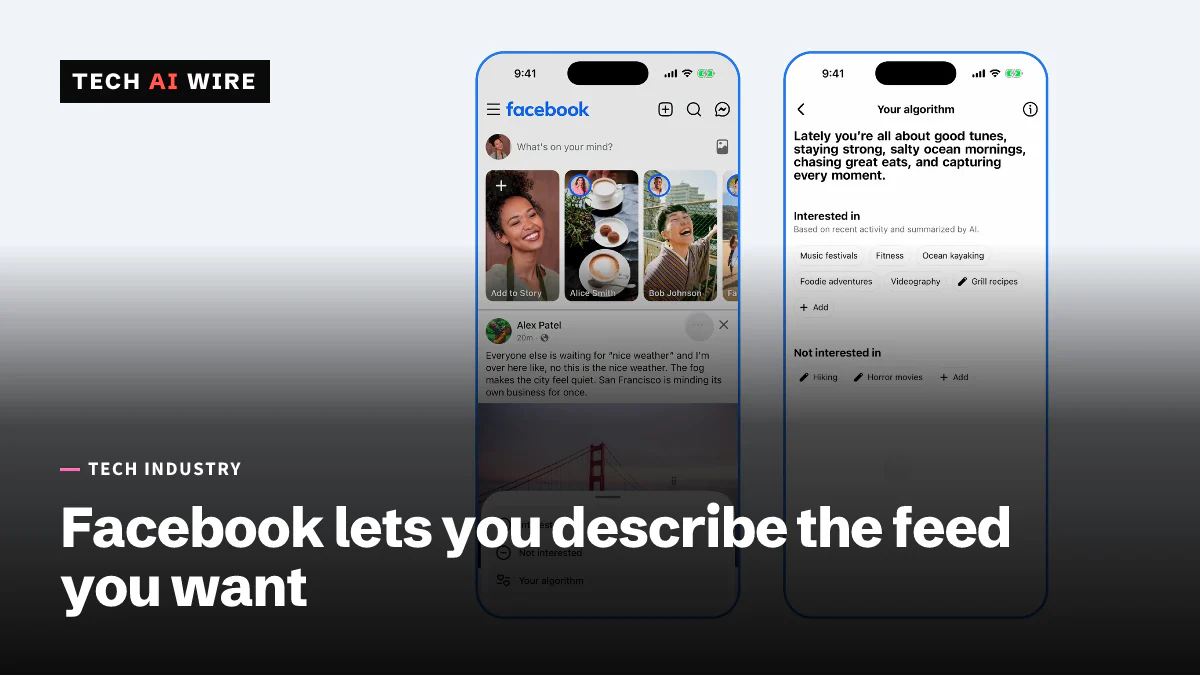
Facebook: Your Algorithm permite describir tu feed con tus propias palabras
Meta lanzó Your Algorithm en Facebook el 13 de octubre: los usuarios describen con sus propias palabras qué quieren ver más o menos en el feed y en Reels.
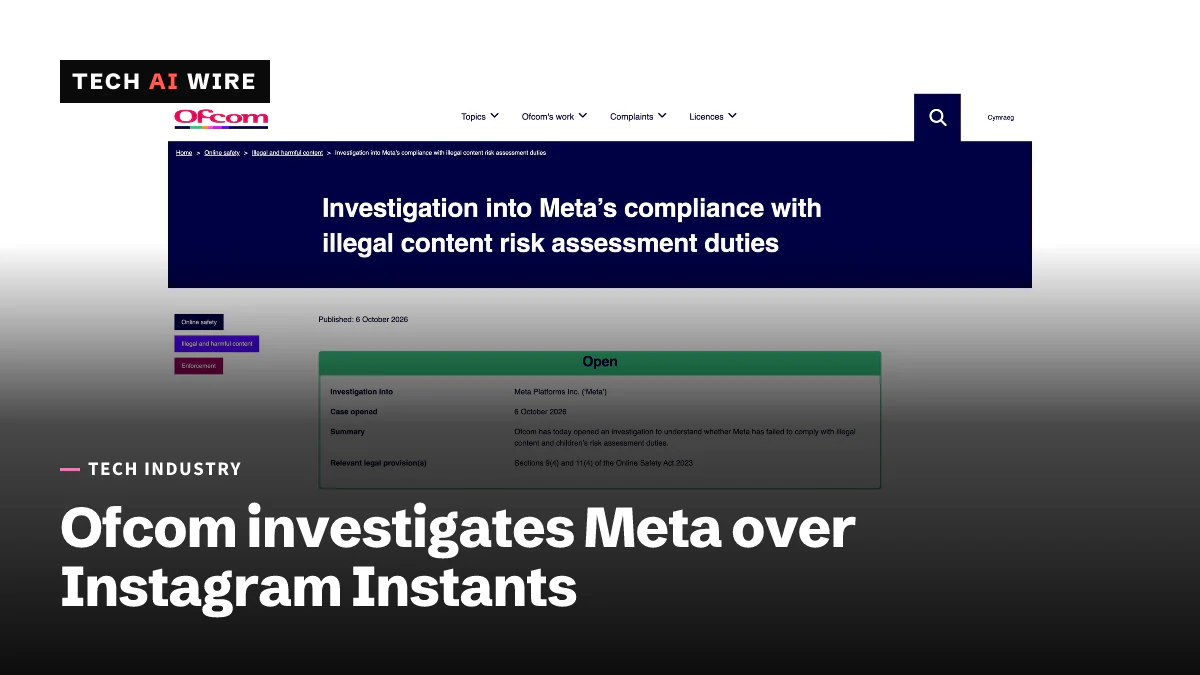
El regulador británico Ofcom investiga a Meta por Instagram Instants
Ofcom comprueba si Meta omitió las evaluaciones de riesgos de seguridad obligatorias antes de lanzar Instagram Instants. Las multas pueden llegar a 18 millones de libras o al 10 % de los ingresos mundiales.