Meta restringe cláusula de rastreamento da web em seus termos comerciais
A Meta tirou a palavra “train” (treinar) de uma cláusula que lhe permite rastrear os sites de clientes empresariais, dias antes de seus Commercial Terms entrarem em vigor, em 30 de outubro de 2026.
4 min de leitura
Em números
- date Meta's new Commercial Terms take effect, 2026
- Oct 30
- businesses using Meta's AI agents in WhatsApp and Messenger
- 1M+
- mentions of robots.txt in the new terms
- 0
A Meta reescreveu uma cláusula de seus novos Commercial Terms que lhe permitia rastrear os sites de seus clientes empresariais e usar o conteúdo para "train" (treinar) seus produtos. O texto revisado, já no ar em 17 de outubro de 2026, retira a palavra "train" depois de um dia de protestos de editores de notícias. Os termos ainda entram em vigor em 30 de outubro, e quase toda empresa que veicula anúncios na Meta está coberta por eles.
O The Next Web e o Unite.AI noticiaram a mudança em 17 de outubro. A Meta diz que o texto sobre rastreamento sempre se aplicou apenas aos seus produtos de anúncios e para empresas. Segundo ela, o novo texto só deixa isso explícito.
O que a cláusula diz
Os antigos Commercial Terms, datados de 6 de março de 2024, não tinham nenhum texto sobre rastreamento, informa o PPC Land. A nova Seção 1 permite que a Meta use "raspadores da web, bots, robôs, spiders, crawlers e agentes de usuário" em domínios "associados aos seus produtos ou serviços". Ela também permite que a Meta "crie credenciais de teste", ou seja, contas criadas para entrar nesses sites.
Um crawler, ou rastreador, é um programa que visita páginas da web e copia o conteúdo delas automaticamente. A cláusula decide o que a Meta pode fazer com o que seus rastreadores copiam.
| Versão | Para que a Meta pode usar o conteúdo rastreado |
|---|---|
| Original, arquivada em 16 de outubro | "para fornecer, desenvolver, melhorar, pesquisar, treinar" os produtos da Meta |
| Revisada, arquivada em 17 de outubro | "para fornecer, desenvolver, melhorar, pesquisar e manter produtos de publicidade e para empresas" |
O Unite.AI informa que a seção de licenciamento também perdeu uma frase. A mesma cláusula revisada aparece em uma prévia dos Self-Serve Ad Terms da Meta, que entram em vigor na mesma data.
Quem está coberto
Os termos se aplicam aos clientes empresariais da Meta, um grupo amplo. O The Register lista qualquer um que veicule anúncios ou envie mensagens de marketing, venda ou liste produtos, crie apps ou gerencie uma Página ou um Grupo. O Nieman Lab descobriu que quase todo editor de notícias tem pelo menos uma conta empresarial na Meta, acrescenta o The Register. Ele também cita uma contagem da Reuters de pelo menos um milhão de empresas usando os agentes de IA da Meta no WhatsApp e no Messenger.
Não há uma opção separada de exclusão. As empresas aceitam os termos ao continuar usando os produtos comerciais da Meta, e a única forma de recusar é parar de usá-los.
Por que os editores protestaram
O Nieman Lab noticiou a cláusula pela primeira vez em 15 de outubro. A News/Media Alliance, que representa editores de notícias, a atacou no dia seguinte. "Os novos termos comerciais de uso da Meta são ultrajantes e provavelmente ilegais", disse Danielle Coffey, presidente e CEO da entidade, no The Register. Ela disse que não se podia permitir que os termos entrassem em vigor em 30 de outubro.
O porta-voz da Meta Andy Stone chamou as primeiras reportagens de "falsas" em 16 de outubro. Ele disse que não havia "nenhuma mudança na forma como a Meta usa rastreadores da web". A atualização foi "pensada para garantir que possamos obter informações precisas sobre produtos à venda em sites de terceiros", escreveu ele, segundo o PPC Land.
A correção não encerrou a briga. A aliança diz que o treinamento foi retirado dos usos listados, mas não foi expressamente proibido, informa o The Next Web. O PPC Land e o The Register, escrevendo em 16 e 17 de outubro, ainda descreviam a cláusula como uma que permite o treinamento. As reportagens deles foram escritas por volta do momento da mudança.
A lacuna do robots.txt
O robots.txt é um pequeno arquivo em um site que diz aos rastreadores quais páginas eles podem visitar. A Meta diz que os donos podem usá-lo. "Os donos de conteúdo podem usar sinalizações no robots.txt para indicar suas preferências", escreveu Stone no X.
Os próprios termos nunca mencionam o robots.txt, observam tanto o PPC Land quanto o The Register. Eric Goldman, professor de direito da Santa Clara University, disse ao The Register que o texto não obriga expressamente a Meta a respeitá-lo. O Tech AI Wire noticiou em setembro que a Cloudflare começou a oferecer uma regra de robots.txt contra o treinamento de IA, um dos poucos sinais que os editores têm.
O que isso significa para desenvolvedores
- Leia agora os termos de 30 de outubro. Se sua empresa veicula anúncios na Meta, lista produtos ou gerencia uma Página, você aceita esses termos sem fazer nada. As equipes jurídica e de marketing têm menos de duas semanas para decidir.
- Não confie só na troca de palavra. A cláusula revisada tira "train", mas o grupo de editores diz que o treinamento não está expressamente descartado. Trate a cláusula como ampla até que a Meta diga o contrário por escrito.
- Defina suas regras de robots.txt de propósito. A Meta aponta os donos para o robots.txt, embora os termos não prometam respeitá-lo. Cite os rastreadores da Meta no arquivo e registre as visitas deles, para ver o que eles realmente fazem.
- Fique atento a contas de teste. A cláusula permite que a Meta "crie credenciais de teste". Sites com cadastro obrigatório devem vigiar novas contas ligadas aos rastreadores da Meta.
- Planeje o custo de saída. A única forma de recusar é parar de usar os produtos empresariais da Meta. Para a maioria das empresas, essa não é uma opção real, e é por isso que o texto exato importa.
Fontes
- Meta drops 'train' from its website-crawling terms after backlash - The Next Web
- Meta Rewrites Web-Crawling Clause in Pending Commercial Terms - Unite.AI
- Meta's new terms let it crawl business websites to train AI from Oct 30 - PPC Land
- Meta grants itself right to scrape content from business customers for model training - The Register
Artigos relacionados
China prepara restrições à exportação de modelos de IA e projetos de chips
O rascunho da China inclui 23 tecnologias de IA na lista de controle de exportações, de modelos com 2 trilhões de parâmetros a projetos de chips. O prazo para comentários termina em 15 de novembro.
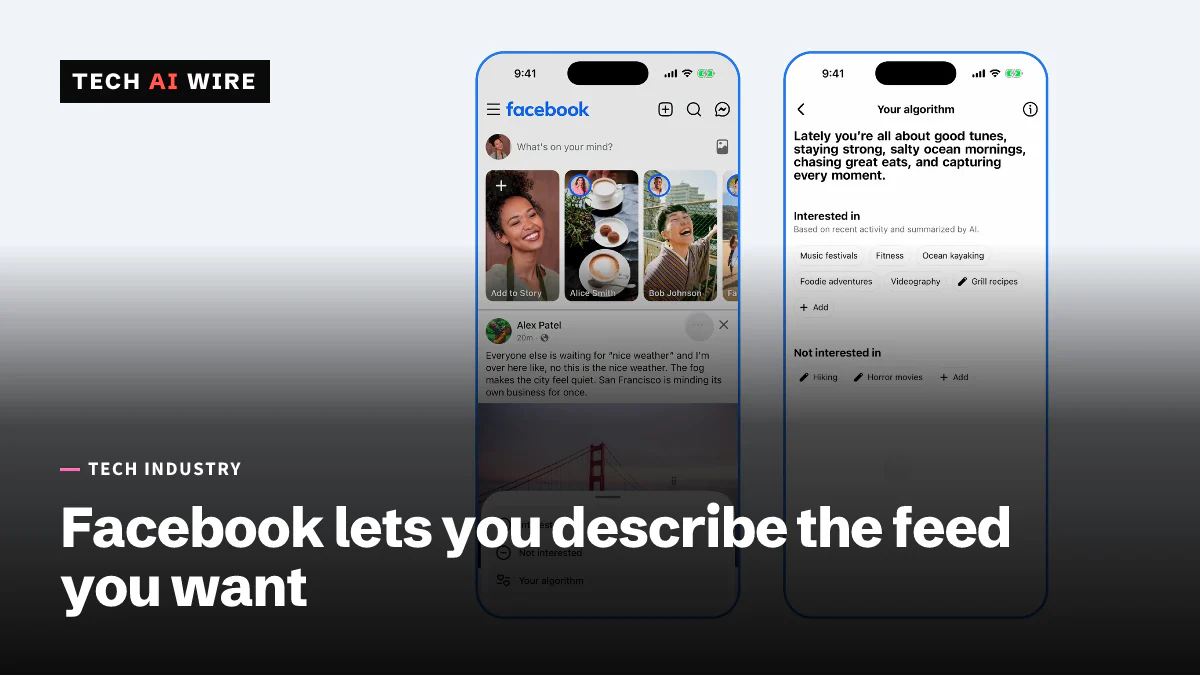
Facebook: Your Algorithm permite descrever seu feed com suas próprias palavras
A Meta lançou o Your Algorithm no Facebook em 13 de outubro: os usuários descrevem com suas próprias palavras o que querem ver mais ou menos no Feed e nos Reels.
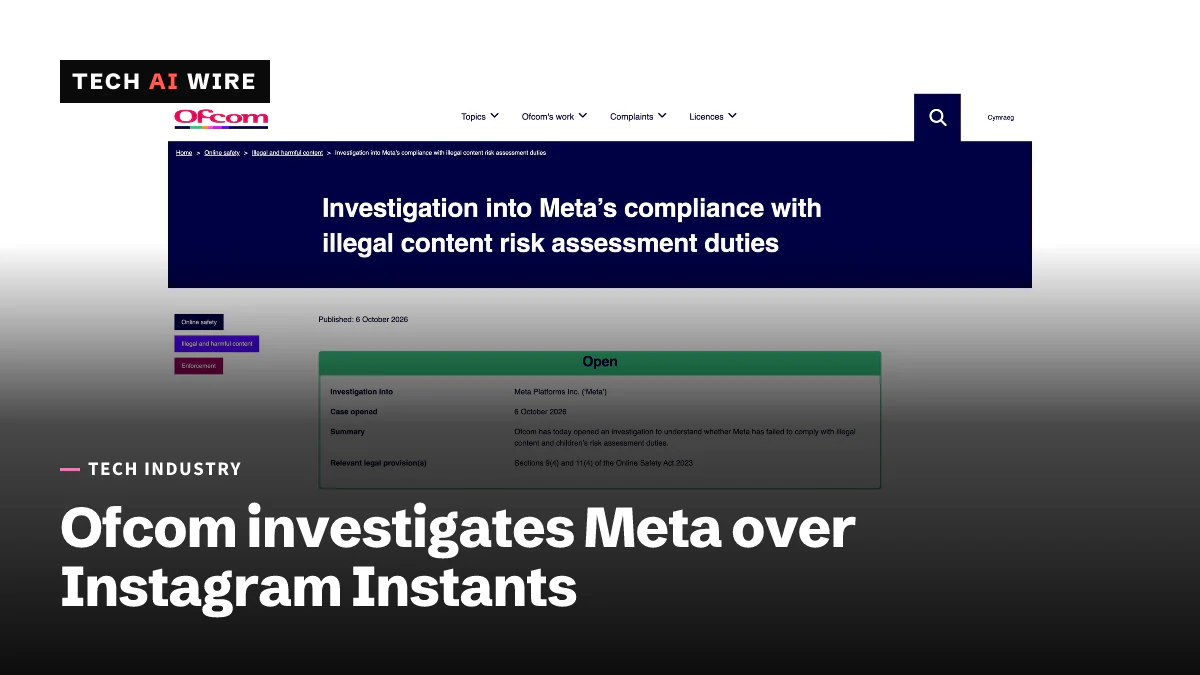
Regulador britânico Ofcom investiga a Meta por causa do Instagram Instants
O Ofcom está verificando se a Meta deixou de fazer as avaliações de risco de segurança obrigatórias antes de lançar o Instagram Instants. As multas podem chegar a £18 milhões ou a 10% da receita mundial.