Meta restreint la clause d'exploration du web de ses conditions commerciales
Meta a retiré le mot « train » (entraîner) d'une clause qui lui permet d'explorer les sites de ses clients professionnels, quelques jours avant l'entrée en vigueur de ses Commercial Terms le 30 octobre 2026.
4 min de lecture
En chiffres
- date Meta's new Commercial Terms take effect, 2026
- Oct 30
- businesses using Meta's AI agents in WhatsApp and Messenger
- 1M+
- mentions of robots.txt in the new terms
- 0
Meta a réécrit une clause de ses nouvelles conditions commerciales (Commercial Terms) qui lui permettait d'explorer les sites web de ses clients professionnels et d'utiliser leur contenu pour « entraîner » (« train ») ses produits. Le texte révisé, en ligne au 17 octobre 2026, abandonne le mot « train » après une journée de protestations des éditeurs de presse. Les conditions entrent toujours en vigueur le 30 octobre. Presque toutes les entreprises qui diffusent des publicités Meta y sont soumises.
The Next Web et Unite.AI ont rapporté ce changement le 17 octobre. Meta affirme que la formulation sur l'exploration n'a jamais concerné que ses produits publicitaires et professionnels, et que le nouveau texte ne fait que le préciser.
Ce que dit la clause
Les anciennes conditions commerciales, datées du 6 mars 2024, ne contenaient aucune formulation sur l'exploration, rapporte PPC Land. La nouvelle section 1 permet à Meta d'utiliser des « outils de scraping web, bots, robots, araignées, robots d'exploration et agents utilisateurs » sur les domaines « associés à vos produits ou services ». Elle permet aussi à Meta de « créer des identifiants de test », c'est-à-dire des comptes créés pour entrer dans ces sites.
Un robot d'exploration, ou crawler, est un programme qui visite des pages web et copie leur contenu automatiquement. La clause fixe ce que Meta peut faire de ce que ses robots copient.
| Version | Ce à quoi Meta peut utiliser le contenu exploré |
|---|---|
| Originale, telle qu'archivée le 16 octobre | « fournir, développer, améliorer, rechercher, entraîner » les produits de Meta |
| Révisée, telle qu'archivée le 17 octobre | « fournir, développer, améliorer, rechercher et maintenir des produits publicitaires et professionnels » |
Unite.AI rapporte que la section sur les licences a aussi perdu une phrase. La même clause révisée figure dans un aperçu des Self-Serve Ad Terms de Meta, qui entrent en vigueur à la même date.
Qui est concerné
Les conditions s'appliquent aux clients professionnels de Meta, un groupe très large. The Register cite toute personne qui diffuse des publicités ou envoie des messages marketing, vend ou référence des produits, crée des applications, ou gère une Page ou un Groupe. Nieman Lab a constaté que presque tous les éditeurs de presse ont au moins un compte professionnel Meta, ajoute The Register. Il cite aussi un décompte de Reuters : au moins un million d'entreprises utilisent les agents IA de Meta dans WhatsApp et Messenger.
Il n'existe aucune option de refus distincte. Les entreprises acceptent les conditions en continuant d'utiliser les produits commerciaux de Meta. Le seul moyen de refuser est d'arrêter de les utiliser.
Pourquoi les éditeurs ont protesté
Nieman Lab a révélé la clause le 15 octobre. La News/Media Alliance, qui représente les éditeurs de presse, l'a attaquée le lendemain. « Les nouvelles conditions commerciales d'utilisation de Meta sont scandaleuses et probablement illégales », a déclaré Danielle Coffey, sa présidente-directrice générale, dans The Register. Selon elle, on ne pouvait pas laisser ces conditions entrer en vigueur le 30 octobre.
Le porte-parole de Meta, Andy Stone, a qualifié les premiers articles de « faux » le 16 octobre. Il a affirmé qu'il n'y avait « aucun changement dans la façon dont Meta utilise les robots d'exploration ». La mise à jour était « conçue pour garantir que nous puissions récupérer des informations exactes sur les produits vendus sur des sites web tiers », a-t-il écrit, selon PPC Land.
La correction n'a pas mis fin au conflit. L'alliance affirme que l'entraînement a été retiré des usages listés mais pas expressément interdit, rapporte The Next Web. PPC Land et The Register, qui écrivaient les 16 et 17 octobre, décrivaient encore la clause comme autorisant l'entraînement. Leurs articles ont été rédigés au moment du changement.
La lacune du robots.txt
Le robots.txt est un petit fichier placé sur un site web, qui indique aux robots d'exploration quelles pages ils peuvent visiter. Meta affirme que les propriétaires peuvent l'utiliser. « Les propriétaires de contenu peuvent utiliser les indicateurs du robots.txt pour exprimer leurs préférences », a écrit Stone sur X.
Les conditions elles-mêmes ne mentionnent jamais le robots.txt, notent PPC Land et The Register. Eric Goldman, professeur de droit à l'université de Santa Clara, a déclaré à The Register que le texte n'oblige pas expressément Meta à le respecter. Tech AI Wire a rapporté en septembre que Cloudflare a commencé à proposer une règle robots.txt contre l'entraînement de l'IA, l'un des rares signaux dont disposent les éditeurs.
Ce que cela signifie pour les développeurs
- Lisez dès maintenant les conditions du 30 octobre. Si votre entreprise diffuse des publicités Meta, référence des produits ou gère une Page, vous acceptez ces conditions sans rien faire. Les équipes juridiques et marketing ont moins de deux semaines pour décider.
- Ne vous fiez pas au seul changement de mot. La clause révisée abandonne « train », mais le groupe d'éditeurs affirme que l'entraînement n'est pas expressément exclu. Considérez la clause comme large tant que Meta ne dit pas le contraire par écrit.
- Définissez vos règles robots.txt délibérément. Meta renvoie les propriétaires vers le robots.txt, même si les conditions ne promettent pas de le respecter. Nommez les robots d'exploration de Meta dans le fichier et enregistrez leurs visites, pour voir ce qu'ils font réellement.
- Surveillez les comptes de test. La clause permet à Meta de « créer des identifiants de test ». Les sites dont le contenu exige une inscription doivent surveiller les nouveaux comptes liés aux robots d'exploration de Meta.
- Prévoyez le coût d'une sortie. Le seul refus possible est d'arrêter d'utiliser les produits professionnels de Meta. Pour la plupart des entreprises, ce n'est pas une vraie option, et c'est pourquoi la formulation exacte compte.
Sources
- Meta drops 'train' from its website-crawling terms after backlash - The Next Web
- Meta Rewrites Web-Crawling Clause in Pending Commercial Terms - Unite.AI
- Meta's new terms let it crawl business websites to train AI from Oct 30 - PPC Land
- Meta grants itself right to scrape content from business customers for model training - The Register
Articles liés
La Chine prépare des restrictions à l'export de modèles d'IA et de conceptions de puces
Le projet chinois ajoute 23 technologies d'IA à sa liste de contrôle des exportations, des modèles de 2 000 milliards de paramètres aux conceptions de puces. La consultation se clôt le 15 novembre.
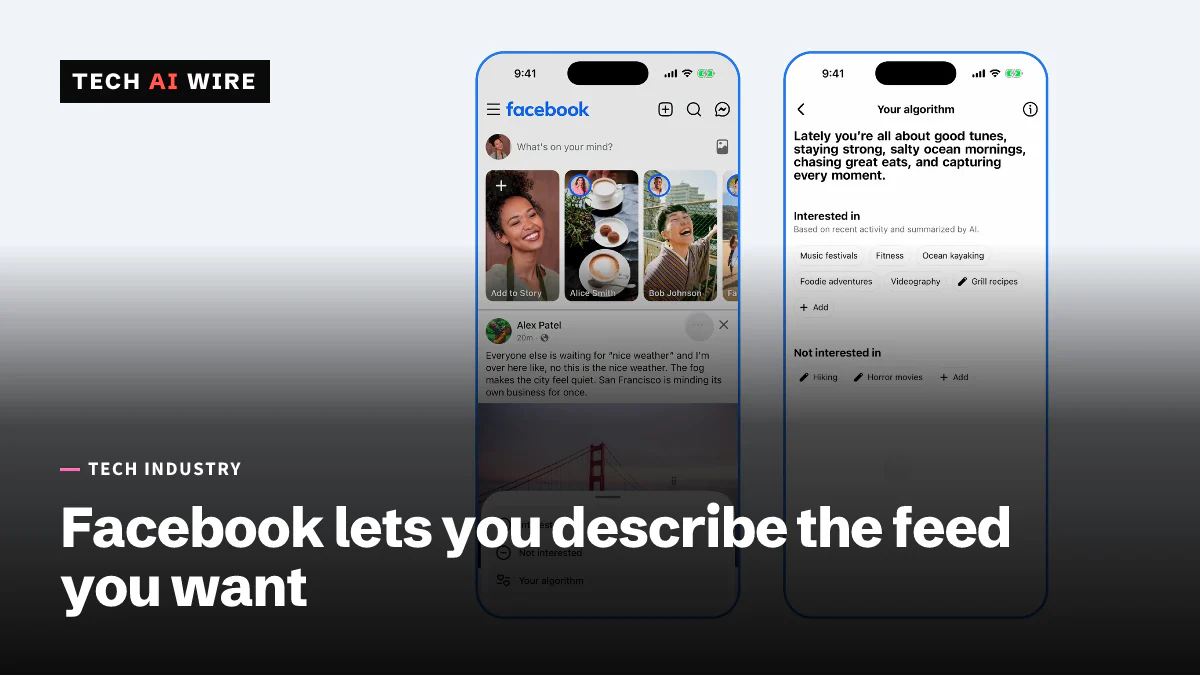
Facebook : Your Algorithm permet de décrire son fil avec ses propres mots
Meta a lancé Your Algorithm sur Facebook le 13 octobre : les utilisateurs décrivent avec leurs propres mots ce qu'ils veulent voir plus ou moins dans le fil et les Reels.
Le régulateur britannique Ofcom enquête sur Meta au sujet d'Instagram Instants
L'Ofcom vérifie si Meta a omis des évaluations des risques obligatoires avant de lancer Instagram Instants. Les amendes peuvent atteindre 18 millions de livres sterling ou 10 % du chiffre d'affaires mondial.