Torvalds' Seitencache-Patch überarbeitet: 4,5-mal schneller auf ext4
Kiryl Shutsemau von Meta hat Torvalds' Seitencache-Patch zu einem RFC mit 18 Patches ausgebaut. Mit 64 Threads auf ext4 stiegen kleine Lesezugriffe von etwa 15 auf 70 Millionen pro Sekunde.
4 Min. Lesezeit
- Before, mitigations on
- 15.7M
- After, mitigations on
- 70.1M
- Before, mitigations off
- 17.2M
- After, mitigations off
- 220M
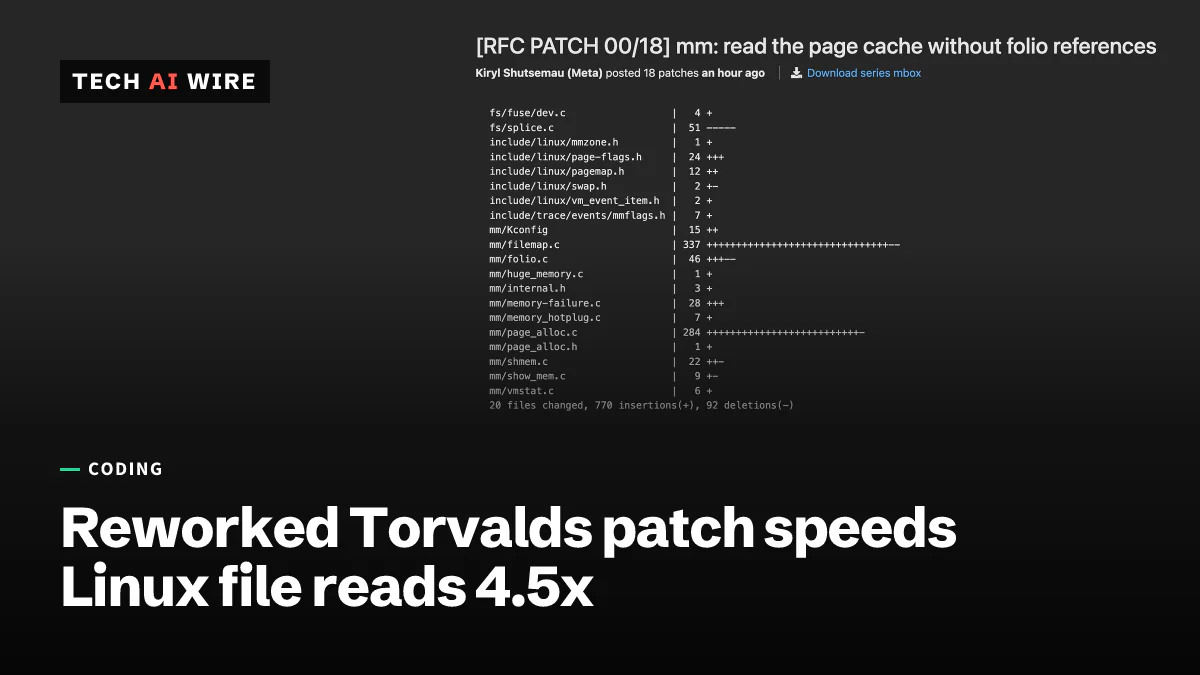
Meta-Ingenieur Kiryl Shutsemau hat am 19. Oktober 2026 eine überarbeitete Version von Linus Torvalds' Patch für den Linux-Page-Cache veröffentlicht. Die neue Serie umfasst 18 Patches. In einem Test mit 64 Threads auf dem Dateisystem ext4 stiegen kleine Lesezugriffe auf eine Datei von etwa 15 Millionen auf etwa 70 Millionen pro Sekunde. Sie bringt auch Korrekturen für Speicherprobleme, die Torvalds offen gelassen hatte, doch der Code ist noch ein Entwurf zur Prüfung.
Was sich seit Torvalds' Version geändert hat
Vor einer Woche veröffentlichte Torvalds eine Reihe von Page-Cache-Patches, die er mit Claude Code geschrieben hatte, dem KI-Coding-Assistenten von Anthropic. Shutsemau hat diese Arbeit nun weitergeführt. Seine Serie trägt den Titel „mm: read the page cache without folio references“.
Das Anschreiben, wie es auf Patchew archiviert ist, würdigt Torvalds' früheren Entwurf. Shutsemau schrieb 11 der 18 Patches, Torvalds schrieb 7. Zusammen ändern sie 20 Dateien, fügen 770 Zeilen hinzu und entfernen 92. Die Serie baut auf Linux 7.3-rc7 auf, einer Testversion.
Sie ist als RFC markiert, kurz für „request for comments“, also eine Bitte um Kommentare. Diese Kennzeichnung bedeutet, dass der Autor Feedback haben möchte, bevor jemand die Serie übernimmt. Phoronix, das über Linux-Performance berichtet, nannte die Ergebnisse eine „fabelhafte Verbesserung“.
Das Problem: ein Zähler, viele Prozessoren
Linux hält zuletzt genutzte Dateidaten im Arbeitsspeicher, in einem Bereich namens Page Cache (Seitencache). Der Kernel verwaltet diesen Speicher in Einheiten namens Folios. Jedes Folio hat einen Referenzzähler, der angibt, wie viele Leser es gerade nutzen.
Jeder Lesezugriff erhöht diesen Zähler kurz und senkt ihn dann wieder. Wenn viele Prozessorkerne dieselbe kleine Datei lesen, kämpfen alle um einen einzigen Zähler. „Kleine Lesezugriffe vieler CPUs auf eine Datei nehmen und lösen alle eine Referenz auf dasselbe Folio“, schreibt Shutsemau.
Wie die Serie das löst
Die Serie lässt normale Datei-Lesezugriffe Daten kopieren, ohne den Zähler anzufassen. Sie gilt für filemap_read(), die Kernel-Funktion hinter normalen Datei-Lesezugriffen. Sie gilt auch für shmem, den Code hinter tmpfs, einem Dateisystem, das vollständig im Arbeitsspeicher liegt.
Damit das sicher ist, wird ein Folio, aus dem ein solcher Leser kopieren darf, erst nach einer RCU-Grace-Period freigegeben. RCU ist eine Kernel-Methode, mit der Leser ohne Sperren arbeiten können. Eine Grace-Period ist eine kurze Wartezeit, nach der bekannt ist, dass jeder frühere Leser fertig ist.
Nur stark genutzte Folios werden so behandelt. Sie tragen ein neues Flag namens PG_rcu_free, das nur auf 64-Bit-Systemen funktioniert.
Vier Patches kümmern sich um den Speicher, der während dieser Verzögerung wartet. Sie fügen dafür einen Zähler hinzu und beschleunigen Grace-Periods, wenn der Speicher knapp wird. Wartende Seiten werden außerdem freigegeben, bevor der Out-of-Memory-Killer, große zusammenhängende Speicheranforderungen oder das Entfernen von Speicher aufgeben. Torvalds hatte die ersten beiden als ungelöste Probleme aufgeführt. Ein letzter Patch fügt einen Schalter hinzu, um den neuen schnellen Pfad abzuschalten.
Die Zahlen
Shutsemau testete auf einer virtuellen Maschine mit 64 virtuellen CPUs und 2 GB Arbeitsspeicher, die auf einem AMD Threadripper 7975WX lief. Jeder Thread las 16 Byte vom Anfang einer Datei. Die Ergebnisse sind Millionen Lesezugriffe pro Sekunde.
| Test | Vorher | Nachher |
|---|---|---|
| ext4, 64 Threads | 15,0-15,7 | 68,9-70,1 |
| tmpfs, 64 Threads | 1,6-1,7 | 71-72 |
| XFS, 64 Threads | 11,3-11,4 | 20,4-20,5 |
| Rohes Blockgerät, 64 Threads | 14,7 | 28,8-28,9 |
| Jedes davon, 1 Thread | 1,6-1,9 | 1,7-2,0 |
Diese Läufe nutzten die standardmäßigen CPU-Sicherheitsmaßnahmen (Mitigations), also Schutz gegen Fehler im Prozessor selbst. Laut Shutsemau fügen sie jedem Lesezugriff etwa 400 Nanosekunden hinzu, wenn er in den Kernel wechselt. Sind sie abgeschaltet, wächst der Gewinn bei ext4 von 4,5-fach auf 13-fach und erreicht 217-220 Millionen Lesezugriffe pro Sekunde. Diese Werte stammen aus einer früheren Version mit demselben Pfad für kleine Lesezugriffe.
Es gibt Kosten. Eine Last, die immer wieder Seiten liest, die der Kernel schon verworfen hat, verliert 4 bis 6 %.
Was noch offen ist
Das Anschreiben nennt mehrere offene Fragen:
- Ein Patch verlässt sich auf eine Prüfung, dass keine Datei den Inode offen hält. Ein Inode ist der Eintrag des Kernels zu einer Datei. Das Dateisystem f2fs hat diese Regel bei atomaren Schreibvorgängen gebrochen, und eine Korrektur ist unterwegs.
- Ein Patch entfernt eine Sperre aus tmpfs-Lesezugriffen. Shutsemau hält das für sicher, bittet aber einen anderen Entwickler, Hugh, es noch einmal zu prüfen.
- Während einer Grace-Period wird ein wartendes Folio keiner cgroup angerechnet, der Linux-Funktion, die den Speicher pro Container begrenzt.
- Die Auswirkung auf die Speicherverdichtung (Memory Compaction), die freien Speicher zu großen Blöcken zusammenfasst, wurde nicht gemessen.
- Auf manchen Architekturen nehmen zum Schreiben gemappte Dateien weiter den langsamen Pfad.
Was das für Entwickler bedeutet
- Noch wird nichts ausgeliefert. Dies ist ein RFC, und es wird kein Zielrelease genannt. Die Reviewer für Speicherverwaltung entscheiden über seine Form.
- Viel genutzte gemeinsame Lesezugriffe gewinnen am meisten. Die großen Gewinne entstehen, wenn viele Threads dieselbe kleine zwischengespeicherte Datei lesen. Lesezugriffe mit einem Thread verändern sich kaum.
- tmpfs-Nutzer sollten genau hinsehen. tmpfs stieg bei 64 Threads von etwa 1,6 Millionen auf 71 Millionen Lesezugriffe pro Sekunde, der größte Sprung in der Tabelle.
- Mit den echten Sicherheitseinstellungen messen. Die Mitigations kosteten hier etwa 400 Nanosekunden pro Lesezugriff. Ergebnisse ohne sie entsprechen keinem gehärteten Produktionsserver.
- KI-unterstützte Entwürfe durchlaufen weiter die Review. Torvalds' Entwurf mit Claude Code wurde innerhalb einer Woche zu einer überarbeiteten Serie eines anderen Ingenieurs. Den Rest erledigte der normale Review-Weg des Kernels.
Quellen
- [RFC PATCH 00/18] mm: read the page cache without folio references - Patchew (Linux kernel mailing list archive)
- Linus Torvalds' AI Code Improved: Huge Performance Wins With Reworked Code - Phoronix
Ähnliche Artikel
BeamFS-RFC: ein Reed-Solomon-Dateisystem für Linux
BeamFS, ein Linux-RFC mit 18 Patches, speichert jeden Block als Reed-Solomon-Codewörter und kann so gekippte Bits auf einer einzigen Festplatte reparieren, auf Kosten von 7 % des Speicherplatzes.
MeshXFS: ein von KI geschriebenes Cluster-Dateisystem auf Basis von XFS
MeshXFS 0.90.130 macht aus XFS ein Cluster-Dateisystem, freigegeben für bis zu 16 Knoten. KI-Agenten schrieben den Cluster-Code, ohne zeilenweise Prüfung durch Menschen.
Linux 7.3 erschienen: fchroot, failfs und schnelleres Btrfs
Linus Torvalds hat Linux 7.3 am 18. Oktober 2026 veröffentlicht: 18.765 Commits von 3.021 Entwicklern, neue Sandboxing-Werkzeuge und bis zu 5-mal schnelleres Btrfs-fsync.