El parche de caché de páginas de Torvalds, rehecho: 4,5 veces más rápido en ext4
Kiryl Shutsemau, de Meta, convirtió el parche de caché de páginas de Torvalds en un RFC de 18 parches. Con 64 hilos en ext4, las lecturas pequeñas pasaron de unos 15 a 70 millones por segundo.
4 min de lectura
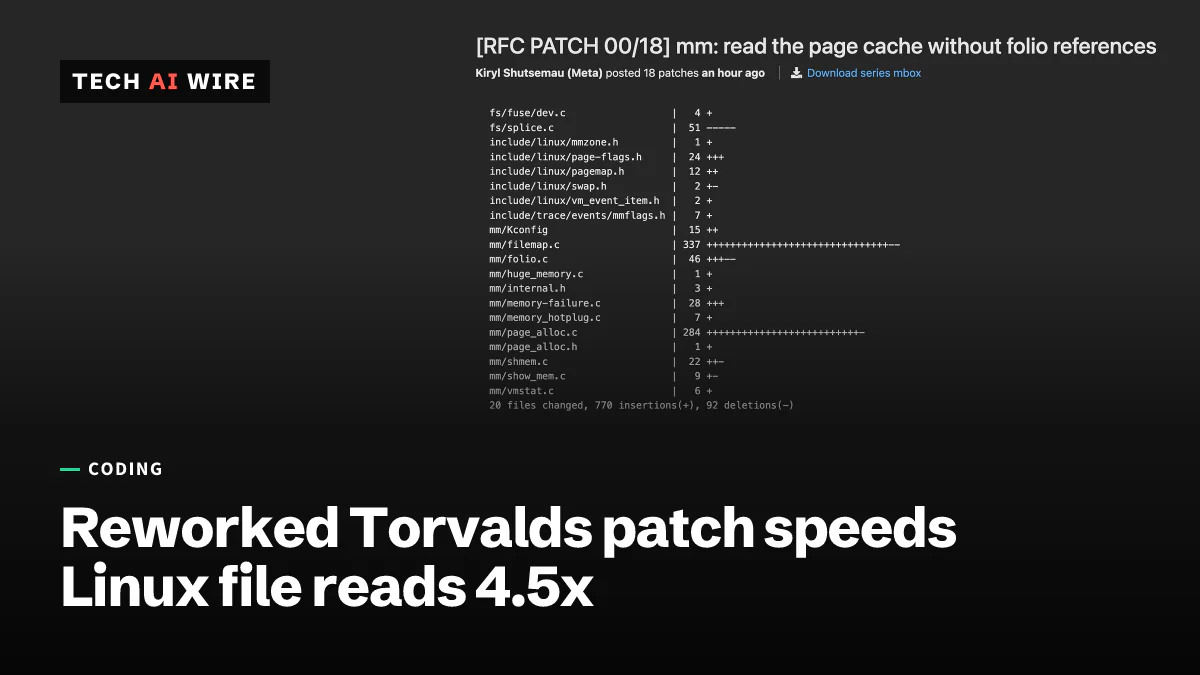
- Before, mitigations on
- 15.7M
- After, mitigations on
- 70.1M
- Before, mitigations off
- 17.2M
- After, mitigations off
- 220M
El ingeniero de Meta Kiryl Shutsemau publicó el 19 de octubre de 2026 una versión rehecha del parche de Linus Torvalds para la caché de páginas de Linux. La nueva serie tiene 18 parches. En una prueba con 64 hilos en el sistema de archivos ext4, las lecturas pequeñas de un mismo archivo pasaron de unos 15 millones a unos 70 millones por segundo. También añade correcciones para problemas de memoria que Torvalds había dejado abiertos, aunque el código sigue siendo un borrador para revisión.
Qué cambió desde la versión de Torvalds
Hace una semana, Torvalds publicó un conjunto de parches de la caché de páginas que escribió con Claude Code, el asistente de programación con IA de Anthropic. Shutsemau ha llevado ahora ese trabajo más lejos. Su serie se titula «mm: read the page cache without folio references».
La carta de presentación, tal como está archivada en Patchew, reconoce el borrador anterior de Torvalds. Shutsemau escribió 11 de los 18 parches y Torvalds escribió 7. Juntos tocan 20 archivos, con 770 líneas añadidas y 92 eliminadas. La serie se basa en Linux 7.3-rc7, una versión de prueba.
Está marcada como RFC, siglas de «request for comments», es decir, una solicitud de comentarios. Esa etiqueta significa que el autor quiere opiniones antes de que nadie la fusione. Phoronix, que cubre el rendimiento de Linux, calificó los resultados de «mejora fabulosa».
El problema: un contador, muchos procesadores
Linux guarda en memoria los datos de archivos usados recientemente, en una zona llamada caché de páginas (page cache). El kernel gestiona esa memoria en unidades llamadas folios. Cada folio tiene un contador de referencias, que indica cuántos lectores lo están usando.
Cada lectura sube brevemente ese contador y luego lo baja. Cuando muchos núcleos del procesador leen el mismo archivo pequeño, todos se disputan un único contador. «Las lecturas pequeñas de un archivo desde muchas CPU toman y sueltan todas una referencia sobre el mismo folio», escribe Shutsemau.
Cómo lo resuelve la serie
La serie permite que las lecturas normales de archivos copien datos sin tocar el contador. Cubre filemap_read(), la función del kernel detrás de las lecturas normales de archivos. También cubre shmem, el código detrás de tmpfs, un sistema de archivos que vive por completo en memoria.
Para que sea seguro, un folio del que un lector así pueda copiar solo se libera tras un periodo de gracia de RCU. RCU es un método del kernel que permite a los lectores trabajar sin bloqueos. Un periodo de gracia es una espera corta tras la cual se sabe que todos los lectores anteriores han terminado.
Solo los folios muy usados reciben este trato. Llevan un nuevo indicador llamado PG_rcu_free, que solo funciona en sistemas de 64 bits.
Cuatro parches se ocupan de la memoria que queda en espera durante ese retraso. Añaden un contador para ella y aceleran los periodos de gracia cuando la memoria escasea. Las páginas en espera también se liberan antes de que el OOM killer, las asignaciones contiguas grandes o la retirada de memoria se den por vencidos. Torvalds había señalado los dos primeros como problemas sin resolver. Un último parche añade un interruptor para desactivar la nueva ruta rápida.
Las cifras
Shutsemau hizo las pruebas en una máquina virtual con 64 CPU virtuales y 2 GB de memoria, que funcionaba sobre un AMD Threadripper 7975WX. Cada hilo leía 16 bytes del inicio de un archivo. Los resultados están en millones de lecturas por segundo.
| Prueba | Antes | Después |
|---|---|---|
| ext4, 64 hilos | 15,0-15,7 | 68,9-70,1 |
| tmpfs, 64 hilos | 1,6-1,7 | 71-72 |
| XFS, 64 hilos | 11,3-11,4 | 20,4-20,5 |
| Dispositivo de bloques en bruto, 64 hilos | 14,7 | 28,8-28,9 |
| Cualquiera de ellos, 1 hilo | 1,6-1,9 | 1,7-2,0 |
Esas pruebas usaron las mitigaciones de seguridad de CPU por defecto, que son protecciones contra fallos del propio procesador. Shutsemau dice que añaden unos 400 nanosegundos a cada lectura cuando pasa al kernel. Con ellas desactivadas, la ganancia en ext4 crece de 4,5 veces a 13 veces y alcanza 217-220 millones de lecturas por segundo. Esas cifras proceden de una versión anterior con la misma ruta para lecturas pequeñas.
Hay costes. Una carga de trabajo que vuelve a leer una y otra vez páginas que el kernel ya descartó pierde entre un 4 % y un 6 %.
Qué sigue abierto
La carta de presentación enumera varias preguntas abiertas:
- Un parche depende de una comprobación de que ningún archivo mantiene abierto el inode. Un inode es el registro que el kernel tiene de un archivo. El sistema de archivos f2fs rompió esa regla en las escrituras atómicas, y hay una corrección en camino.
- Un parche quita un bloqueo de las lecturas de tmpfs. Shutsemau cree que es seguro, pero pide a otro desarrollador, Hugh, que lo vuelva a comprobar.
- Durante un periodo de gracia, un folio en espera no cuenta para ningún cgroup, la función de Linux que limita la memoria por contenedor.
- No se ha medido el efecto sobre la compactación de memoria, que agrupa la memoria libre en bloques grandes.
- En algunas arquitecturas, los archivos mapeados para escritura siguen tomando la ruta lenta.
Qué significa para los desarrolladores
- Todavía no se publica nada. Esto es un RFC, y no se nombra ninguna versión objetivo. Los revisores de gestión de memoria decidirán su forma.
- Las lecturas compartidas intensas ganan más. Las grandes mejoras llegan cuando muchos hilos leen el mismo archivo pequeño en caché. Las lecturas con un solo hilo apenas cambian.
- Los usuarios de tmpfs deberían seguirlo de cerca. tmpfs pasó de unos 1,6 millones a 71 millones de lecturas por segundo con 64 hilos, el mayor salto de la tabla.
- Medir con la configuración de seguridad real. Las mitigaciones costaron aquí unos 400 nanosegundos por lectura. Los resultados sin ellas no coincidirán con los de un servidor de producción reforzado.
- Los borradores asistidos por IA siguen pasando por revisión. El borrador de Torvalds hecho con Claude Code se convirtió en una semana en una serie rehecha por otro ingeniero. El proceso normal de revisión del kernel hizo el resto.
Fuentes
- [RFC PATCH 00/18] mm: read the page cache without folio references - Patchew (Linux kernel mailing list archive)
- Linus Torvalds' AI Code Improved: Huge Performance Wins With Reworked Code - Phoronix
Artículos relacionados
RFC de BeamFS: un sistema de archivos Reed-Solomon para Linux
BeamFS, un RFC de 18 parches para Linux, guarda cada bloque como palabras de código Reed-Solomon para reparar bits invertidos en un solo disco, a costa del 7 % del espacio.
MeshXFS: un sistema de archivos en clúster escrito por IA sobre XFS
MeshXFS 0.90.130 convierte XFS en un sistema de archivos en clúster, publicado para hasta 16 nodos. Agentes de IA escribieron su código de clúster, sin revisión humana línea por línea.
Linux 7.3 llega con fchroot, failfs y un Btrfs más rápido
Linus Torvalds publicó Linux 7.3 el 18 de octubre de 2026: 18.765 commits de 3.021 desarrolladores, nuevas herramientas de sandboxing y un fsync de Btrfs hasta 5 veces más rápido.