Le correctif de cache de pages de Torvalds remanié : 4,5 fois plus rapide sur ext4
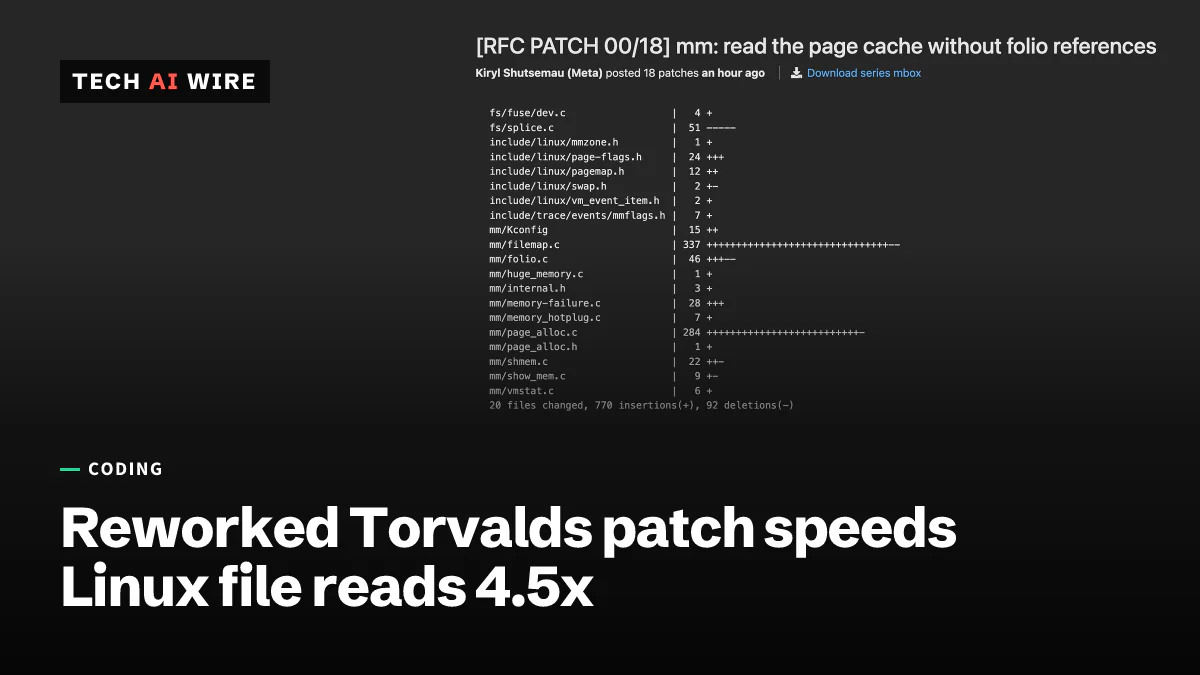
Kiryl Shutsemau, de Meta, a fait du correctif de cache de pages de Torvalds un RFC de 18 correctifs. À 64 threads sur ext4, les petites lectures sont passées d'environ 15 à 70 millions par seconde.
4 min de lecture
- Before, mitigations on
- 15.7M
- After, mitigations on
- 70.1M
- Before, mitigations off
- 17.2M
- After, mitigations off
- 220M
L'ingénieur de Meta Kiryl Shutsemau a publié le 19 octobre 2026 une version remaniée du correctif de Linus Torvalds pour le cache de pages de Linux. La nouvelle série compte 18 correctifs. Dans un test à 64 threads sur le système de fichiers ext4, les petites lectures d'un seul fichier sont passées d'environ 15 millions à environ 70 millions par seconde. Elle ajoute aussi des corrections pour des problèmes de mémoire que Torvalds avait laissés ouverts, mais le code reste un brouillon soumis à la relecture.
Ce qui a changé depuis la version de Torvalds
Il y a une semaine, Torvalds a publié une série de correctifs du cache de pages qu'il a écrits avec Claude Code, l'assistant de programmation par IA d'Anthropic. Shutsemau a maintenant poussé ce travail plus loin. Sa série s'intitule « mm: read the page cache without folio references ».
La lettre de présentation, telle qu'archivée sur Patchew, reconnaît le brouillon antérieur de Torvalds. Shutsemau a écrit 11 des 18 correctifs, et Torvalds en a écrit 7. Ensemble, ils touchent 20 fichiers, ajoutent 770 lignes et en suppriment 92. La série s'appuie sur Linux 7.3-rc7, une version de test.
Elle porte la mention RFC, pour « request for comments », soit un appel à commentaires. Cette mention signifie que l'auteur veut des retours avant que quiconque ne la fusionne. Phoronix, qui couvre les performances de Linux, a qualifié les résultats d'« amélioration fabuleuse ».
Le problème : un compteur, beaucoup de processeurs
Linux garde en mémoire les données de fichiers récemment utilisées, dans une zone appelée cache de pages (page cache). Le noyau gère cette mémoire en unités appelées folios. Chaque folio a un compteur de références, qui indique combien de lecteurs l'utilisent.
Chaque lecture augmente brièvement ce compteur, puis le diminue. Quand de nombreux cœurs de processeur lisent le même petit fichier, ils se disputent tous un seul compteur. « Les petites lectures d'un fichier depuis de nombreux CPU prennent et relâchent toutes une référence sur le même folio », écrit Shutsemau.
Comment la série règle le problème
La série permet aux lectures de fichiers ordinaires de copier les données sans toucher au compteur. Elle couvre filemap_read(), la fonction du noyau derrière les lectures de fichiers normales. Elle couvre aussi shmem, le code derrière tmpfs, un système de fichiers qui réside entièrement en mémoire.
Pour que ce soit sûr, un folio depuis lequel un tel lecteur peut copier n'est libéré qu'après une période de grâce RCU. RCU est une méthode du noyau qui permet aux lecteurs de travailler sans verrous. Une période de grâce est une courte attente au terme de laquelle on sait que tous les lecteurs antérieurs ont fini.
Seuls les folios très sollicités reçoivent ce traitement. Ils portent un nouveau drapeau appelé PG_rcu_free, qui ne fonctionne que sur les systèmes 64 bits.
Quatre correctifs traitent la mémoire laissée en attente pendant ce délai. Ils ajoutent un compteur pour elle et accélèrent les périodes de grâce quand la mémoire se raréfie. Les pages en attente sont aussi libérées avant que l'OOM killer, les grandes allocations contiguës ou le retrait de mémoire n'abandonnent. Torvalds avait listé les deux premiers comme des problèmes non résolus. Un dernier correctif ajoute un interrupteur pour désactiver le nouveau chemin rapide.
Les chiffres
Shutsemau a testé sur une machine virtuelle dotée de 64 CPU virtuels et de 2 Go de mémoire, qui tournait sur un AMD Threadripper 7975WX. Chaque thread lisait 16 octets au début d'un fichier. Les résultats sont en millions de lectures par seconde.
| Test | Avant | Après |
|---|---|---|
| ext4, 64 threads | 15,0-15,7 | 68,9-70,1 |
| tmpfs, 64 threads | 1,6-1,7 | 71-72 |
| XFS, 64 threads | 11,3-11,4 | 20,4-20,5 |
| Périphérique bloc brut, 64 threads | 14,7 | 28,8-28,9 |
| N'importe lequel, 1 thread | 1,6-1,9 | 1,7-2,0 |
Ces tests utilisaient les mesures d'atténuation de sécurité CPU par défaut, des protections contre des failles du processeur lui-même. Selon Shutsemau, elles ajoutent environ 400 nanosecondes à chaque lecture quand elle passe dans le noyau. Quand elles sont désactivées, le gain sur ext4 passe de 4,5 fois à 13 fois, pour atteindre 217-220 millions de lectures par seconde. Ces chiffres viennent d'une version antérieure avec le même chemin pour les petites lectures.
Il y a des coûts. Une charge qui relit sans cesse des pages que le noyau a déjà écartées perd 4 à 6 %.
Ce qui reste ouvert
La lettre de présentation énumère plusieurs questions ouvertes :
- Un correctif repose sur une vérification qu'aucun fichier ne garde l'inode ouvert. Un inode est l'enregistrement d'un fichier par le noyau. Le système de fichiers f2fs a enfreint cette règle pour les écritures atomiques, et une correction est en route.
- Un correctif retire un verrou des lectures tmpfs. Shutsemau pense que c'est sûr, mais demande à un autre développeur, Hugh, de revérifier.
- Pendant une période de grâce, un folio en attente n'est compté dans aucun cgroup, la fonction de Linux qui limite la mémoire par conteneur.
- L'effet sur le compactage de la mémoire, qui regroupe la mémoire libre en grands blocs, n'a pas été mesuré.
- Sur certaines architectures, les fichiers mappés en écriture passent encore par le chemin lent.
Ce que cela change pour les développeurs
- Rien n'est livré pour l'instant. C'est un RFC, et aucune version cible n'est nommée. Les relecteurs de la gestion de la mémoire décideront de sa forme.
- Les lectures partagées intensives gagnent le plus. Les gros gains apparaissent quand de nombreux threads lisent le même petit fichier en cache. Les lectures à un seul thread bougent à peine.
- Les utilisateurs de tmpfs doivent suivre cela de près. tmpfs est passé d'environ 1,6 million à 71 millions de lectures par seconde à 64 threads, le plus grand bond du tableau.
- Mesurer avec les vrais réglages de sécurité. Les atténuations coûtaient ici environ 400 nanosecondes par lecture. Les résultats sans elles ne correspondront pas à un serveur de production durci.
- Les brouillons assistés par IA passent toujours par la relecture. Le brouillon de Torvalds fait avec Claude Code est devenu en une semaine une série remaniée par un autre ingénieur. Le circuit normal de relecture du noyau a fait le reste.
Sources
- [RFC PATCH 00/18] mm: read the page cache without folio references - Patchew (Linux kernel mailing list archive)
- Linus Torvalds' AI Code Improved: Huge Performance Wins With Reworked Code - Phoronix
Articles liés
RFC BeamFS : un système de fichiers Reed-Solomon pour Linux
BeamFS, une RFC Linux de 18 patchs, stocke chaque bloc sous forme de mots de code Reed-Solomon pour réparer des bits inversés sur un seul disque, au prix de 7 % de l'espace.
MeshXFS : un système de fichiers en cluster écrit par l'IA, bâti sur XFS
MeshXFS 0.90.130 transforme XFS en système de fichiers en cluster, publié pour 16 nœuds au maximum. Des agents d'IA ont écrit son code de clustering, sans relecture humaine ligne par ligne.
Linux 7.3 est sorti avec fchroot, failfs et un Btrfs plus rapide
Linus Torvalds a publié Linux 7.3 le 18 octobre 2026 : 18 765 commits de 3 021 développeurs, de nouveaux outils de sandboxing et un fsync Btrfs jusqu'à 5 fois plus rapide.