Patch de Torvalds para o cache de páginas é refeito: 4,5 vezes mais rápido no ext4
Kiryl Shutsemau, da Meta, transformou o patch de cache de páginas de Torvalds em um RFC de 18 patches. Com 64 threads no ext4, as leituras pequenas passaram de cerca de 15 para 70 milhões por segundo.
4 min de leitura
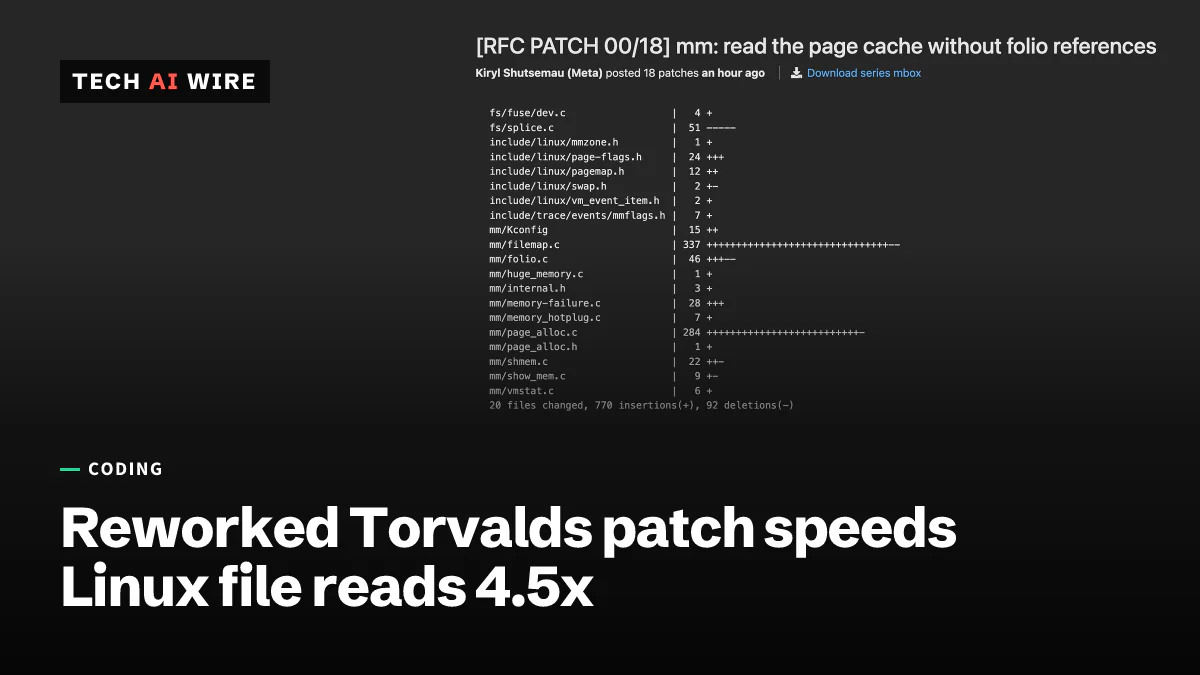
- Before, mitigations on
- 15.7M
- After, mitigations on
- 70.1M
- Before, mitigations off
- 17.2M
- After, mitigations off
- 220M
O engenheiro da Meta Kiryl Shutsemau publicou em 19 de outubro de 2026 uma versão refeita do patch de Linus Torvalds para o cache de páginas do Linux. A nova série tem 18 patches. Em um teste com 64 threads no sistema de arquivos ext4, as leituras pequenas de um mesmo arquivo passaram de cerca de 15 milhões para cerca de 70 milhões por segundo. Ela também traz correções para problemas de memória que Torvalds tinha deixado em aberto, mas o código ainda é um rascunho para revisão.
O que mudou desde a versão de Torvalds
Há uma semana, Torvalds publicou um conjunto de patches do cache de páginas que escreveu com o Claude Code, o assistente de programação com IA da Anthropic. Agora Shutsemau levou esse trabalho adiante. A série dele se chama "mm: read the page cache without folio references".
A carta de apresentação, arquivada no Patchew, dá crédito ao rascunho anterior de Torvalds. Shutsemau escreveu 11 dos 18 patches e Torvalds escreveu 7. Juntos, eles mexem em 20 arquivos, adicionando 770 linhas e removendo 92. A série se baseia no Linux 7.3-rc7, uma versão de teste.
Ela está marcada como RFC, sigla de "request for comments", ou seja, um pedido de comentários. Esse rótulo significa que o autor quer opiniões antes que alguém a incorpore. O Phoronix, que cobre desempenho do Linux, chamou os resultados de "melhoria fabulosa".
O problema: um contador, muitos processadores
O Linux mantém na memória os dados de arquivos usados recentemente, em uma área chamada cache de páginas (page cache). O kernel controla essa memória em unidades chamadas folios. Cada folio tem uma contagem de referências, um contador que diz quantos leitores o estão usando.
Cada leitura aumenta esse contador por um instante e depois o diminui. Quando muitos núcleos do processador leem o mesmo arquivo pequeno, todos disputam um único contador. "Leituras pequenas de um arquivo a partir de muitas CPUs pegam e soltam, todas, uma referência no mesmo folio", escreve Shutsemau.
Como a série resolve isso
A série permite que leituras comuns de arquivos copiem dados sem tocar no contador. Ela cobre filemap_read(), a função do kernel por trás das leituras normais de arquivos. Ela também cobre o shmem, o código por trás do tmpfs, um sistema de arquivos que fica inteiramente na memória.
Para que isso seja seguro, um folio do qual esse tipo de leitor pode copiar só é liberado após um período de carência do RCU. O RCU é um método do kernel que permite aos leitores trabalhar sem bloqueios. Um período de carência é uma espera curta após a qual se sabe que todos os leitores anteriores terminaram.
Só os folios muito usados recebem esse tratamento. Eles levam uma nova flag chamada PG_rcu_free, que só funciona em sistemas de 64 bits.
Quatro patches tratam da memória que fica esperando durante esse atraso. Eles adicionam um contador para ela e aceleram os períodos de carência quando a memória fica escassa. As páginas em espera também são liberadas antes que o OOM killer, as alocações contíguas grandes ou a remoção de memória desistam. Torvalds tinha listado os dois primeiros como problemas não resolvidos. Um último patch adiciona uma chave para desligar o novo caminho rápido.
Os números
Shutsemau testou em uma máquina virtual com 64 CPUs virtuais e 2 GB de memória, rodando em um AMD Threadripper 7975WX. Cada thread lia 16 bytes do início de um arquivo. Os resultados estão em milhões de leituras por segundo.
| Teste | Antes | Depois |
|---|---|---|
| ext4, 64 threads | 15,0-15,7 | 68,9-70,1 |
| tmpfs, 64 threads | 1,6-1,7 | 71-72 |
| XFS, 64 threads | 11,3-11,4 | 20,4-20,5 |
| Dispositivo de bloco bruto, 64 threads | 14,7 | 28,8-28,9 |
| Qualquer um deles, 1 thread | 1,6-1,9 | 1,7-2,0 |
Essas execuções usaram as mitigações de segurança de CPU padrão, que são proteções contra falhas no próprio processador. Shutsemau diz que elas acrescentam cerca de 400 nanossegundos a cada leitura quando ela entra no kernel. Com elas desligadas, o ganho no ext4 cresce de 4,5 vezes para 13 vezes, chegando a 217-220 milhões de leituras por segundo. Esses números vêm de uma versão anterior com o mesmo caminho para leituras pequenas.
Há custos. Uma carga de trabalho que relê o tempo todo páginas que o kernel já descartou perde de 4% a 6%.
O que ainda está em aberto
A carta de apresentação lista várias questões em aberto:
- Um patch depende de uma verificação de que nenhum arquivo mantém o inode aberto. Um inode é o registro que o kernel tem de um arquivo. O sistema de arquivos f2fs quebrou essa regra em gravações atômicas, e uma correção está a caminho.
- Um patch remove um bloqueio das leituras do tmpfs. Shutsemau acha que é seguro, mas pede a outro desenvolvedor, Hugh, que confira de novo.
- Durante um período de carência, um folio em espera não conta para nenhum cgroup, o recurso do Linux que limita a memória por contêiner.
- O efeito na compactação de memória, que junta a memória livre em blocos grandes, não foi medido.
- Em algumas arquiteturas, arquivos mapeados para escrita ainda usam o caminho lento.
O que isso significa para os desenvolvedores
- Nada é lançado ainda. Isto é um RFC, e nenhuma versão-alvo foi citada. Os revisores de gerenciamento de memória vão decidir o formato dele.
- Leituras compartilhadas intensas ganham mais. Os grandes ganhos aparecem quando muitas threads leem o mesmo arquivo pequeno em cache. Leituras com uma thread quase não mudam.
- Quem usa tmpfs deve acompanhar de perto. O tmpfs passou de cerca de 1,6 milhão para 71 milhões de leituras por segundo com 64 threads, o maior salto da tabela.
- Faça benchmarks com as configurações reais de segurança. As mitigações custaram aqui cerca de 400 nanossegundos por leitura. Resultados sem elas não vão corresponder a um servidor de produção reforçado.
- Rascunhos assistidos por IA continuam passando por revisão. O rascunho de Torvalds feito com o Claude Code virou, em uma semana, uma série refeita por outro engenheiro. O caminho normal de revisão do kernel fez o resto.
Fontes
- [RFC PATCH 00/18] mm: read the page cache without folio references - Patchew (Linux kernel mailing list archive)
- Linus Torvalds' AI Code Improved: Huge Performance Wins With Reworked Code - Phoronix
Artigos relacionados
RFC do BeamFS: um sistema de arquivos com Reed-Solomon para o Linux
O BeamFS, uma RFC de 18 patches para o Linux, grava cada bloco como palavras de código Reed-Solomon para reparar bits invertidos em um único disco, ao custo de 7% do espaço.
MeshXFS: um sistema de arquivos em cluster escrito por IA sobre o XFS
O MeshXFS 0.90.130 transforma o XFS em um sistema de arquivos em cluster, lançado para até 16 nós. Agentes de IA escreveram o código de cluster, sem revisão humana linha por linha.
Linux 7.3 é lançado com fchroot, failfs e Btrfs mais rápido
Linus Torvalds lançou o Linux 7.3 em 18 de outubro de 2026: 18.765 commits de 3.021 desenvolvedores, novas ferramentas de sandboxing e fsync do Btrfs até 5 vezes mais rápido.