MeshXFS: ein von KI geschriebenes Cluster-Dateisystem auf Basis von XFS
MeshXFS 0.90.130 macht aus XFS ein Cluster-Dateisystem, freigegeben für bis zu 16 Knoten. KI-Agenten schrieben den Cluster-Code, ohne zeilenweise Prüfung durch Menschen.
4 Min. Lesezeit
Die Zahlen
- lines in MeshXFS's xfs/ tree, up from ~226k upstream
- ~314k
- largest node count in a released configuration
- 16
- open defect records listed in the repository
- 123
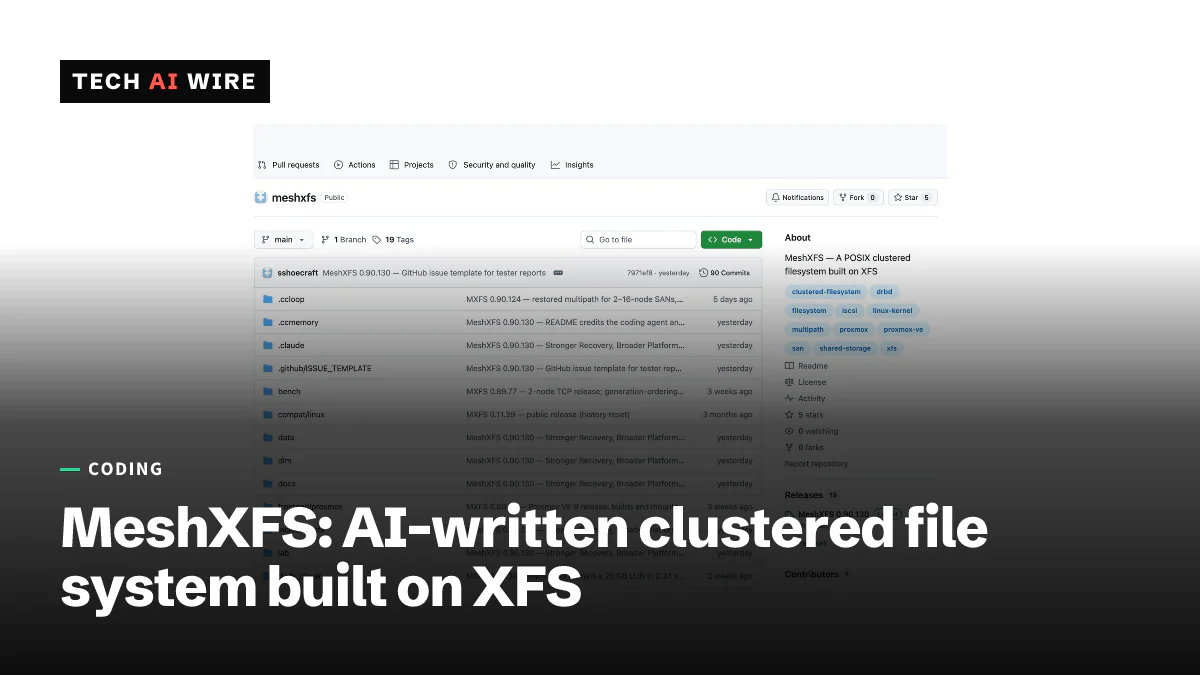
MeshXFS ist ein neues Open-Source-Dateisystem, mit dem mehrere Linux-Server gleichzeitig denselben Datenträger nutzen können. Es entstand durch den Umbau von XFS mit KI-Coding-Agenten, berichtete Phoronix am 17. Oktober 2026. Laut dem Repository des Projekts hat kein Mensch den Cluster-Code geschrieben, von Hand bearbeitet oder Zeile für Zeile geprüft. Damit ist es einer der bislang deutlichsten Tests für KI-geschriebenen Code an einer Stelle, an der ein Fehler Daten zerstören kann.
XFS ist ein ausgereiftes Dateisystem, das im Linux-Kernel enthalten ist. Ein normales XFS-Volume kann jeweils nur von einem Rechner eingebunden werden. Ein Cluster-Dateisystem erlaubt es mehreren Rechnern, denselben gemeinsamen Datenträger einzubinden und gemeinsam darauf zu schreiben, was in Virtualisierungsclustern üblich ist.
Wie der Code entstand
Claude Opus, das als autonomer Coding-Agent in Anthropics Claude Code lief, „schrieb einen großen Teil“ des Codes, so die GitHub-Seite des Projekts. Claude Fable, GPT, Gemini und Astra wurden bei den schwierigsten Problemen hinzugezogen. Das Repository wird von Stephen P. Shoecraft betreut. Es beschreibt die Rolle des Menschen als Steuern der Arbeit, Festlegen der Anforderungen und Testen.
„Kein Mensch hat den Cluster-Code geschrieben, von Hand bearbeitet oder Zeile für Zeile geprüft“, heißt es im Repository. Laut Phoronix haben die KI-Agenten auch die Tests geschrieben und ausgeführt.
Die Änderung ist groß. Der xfs/-Baum des Projekts ist laut Phoronix und dem Repository von etwa 226.000 auf etwa 314.000 Zeilen gewachsen. MeshXFS ist ein Fork des XFS-Codes aus dem Entwicklungsbaum von Linux 6.19 und steht unter Version 2 der GNU General Public License.
Phoronix zitiert die Ziele des Projekts: „Datenintegrität zuerst, niemals den Host zum Absturz bringen und höchstens doppelt so lange brauchen wie natives XFS auf demselben Speicher.“
Wie MeshXFS clustert
Mehrere Rechner, die auf einen Datenträger schreiben, brauchen Regeln, damit sie sich nicht gegenseitig überschreiben. MeshXFS nutzt dafür einige Standardbausteine, laut Phoronix und dem Repository:
- Lock-Manager. Einer arbeitet über das Netzwerk zwischen den Knoten. Der andere hält den Sperrstatus auf dem gemeinsamen Datenträger selbst, mithilfe eines Speicherbefehls namens SCSI COMPARE AND WRITE.
- Fencing. Reagiert ein Knoten nicht mehr, trennen ihn die anderen vom Datenträger, damit er keine Daten beschädigen kann. MeshXFS erledigt das mit SCSI Persistent Reservations.
- Wiederherstellung. Jeder Knoten hat seinen eigenen Abschnitt des Journals, also des Protokolls ausstehender Änderungen. Ein überlebender Knoten trennt einen ausgefallenen per Fencing ab, spielt dessen Journal erneut ab und arbeitet weiter.
Laut Repository haben die anderen Knoten 120 Sekunden, um einen Knoten für ausgefallen zu erklären, und 180 Sekunden, um ihn per Fencing abzutrennen.
Was freigegeben ist und was nicht
Die neueste Version ist 0.90.130 mit dem Titel „Stronger Recovery, Broader Platform Support“. Das Repository benennt seine Grenzen genau:
| Bereich | Status laut Repository |
|---|---|
| Clustergrößen | Freigegeben für 2, 4, 8 und 16 Knoten; 32 Knoten implementiert, aber nicht freigegeben |
| Speicheranbindungen | iSCSI verifiziert; Fibre Channel und SAS nicht verifiziert |
| NVMe und NVMe-oF | Nicht unterstützt, weil Fencing und Sperren auf SCSI-Befehlen beruhen |
| Speicher-Arrays | „Keine Version wurde auf einem Speicher-Array verifiziert“ |
| Offene Fehler | 123 Einträge; 69 betreffen eine freigegebene Konfiguration |
| Pakete | DKMS-Modul für Proxmox VE 9, RHEL 9, Ubuntu 24.04 und 26.04, Debian 12 und 13 |
Jede Version durchläuft pro Konfiguration eine Testsuite mit etwa 30 Zeilen auf echten Clustern mit mehreren Knoten, berichtet Phoronix. Das Repository enthält außerdem zwei deutliche Warnungen: „Nutzen Sie die MeshXFS-Werkzeuge, niemals die Standard-XFS-Werkzeuge“ und „Sie nutzen 0.90.37 oder älter? Aktualisieren Sie.“
Das Projekt erscheint einen Tag, nachdem Linux-Kernel-Entwickler sich daranmachten, den KI-Tag Assisted-by aus Commits zu streichen. MeshXFS ist ein eigenständiges Projekt außerhalb des Kernels. Es wirft aber dieselbe Frage auf, wie viel Prüfung KI-geschriebener Code braucht.
Was das für Entwickler bedeutet
- Legen Sie noch keine Produktivdaten darauf ab. Das Projekt listet 69 offene Fehler, die freigegebene Setups betreffen, und sagt, dass keine Version auf einem Speicher-Array verifiziert wurde. Behandeln Sie es als Laborprojekt.
- Testen Sie es, wenn Sie Cluster mit gemeinsamem Speicher betreiben. Wenn Sie Proxmox oder einen anderen Virtualisierungs-Stack auf iSCSI-Speicher nutzen, zeigt ein Labortest, wie das Failover abläuft. Trennen Sie einen Knoten vom Strom und messen Sie, wie lange das Fencing im Vergleich zu den angegebenen 180 Sekunden dauert.
- Prüfen Sie zuerst Ihr Speicherprotokoll. NVMe und NVMe-oF werden überhaupt nicht unterstützt. Fibre Channel und SAS sind ungetestet.
- Führen Sie niemals die Standard-Reparaturwerkzeuge von XFS darauf aus. Das Projekt warnt, dass die Standard-XFS-Werkzeuge auf einem MeshXFS-Datenträger an den falschen Stellen lesen. Nutzen Sie die eigenen Werkzeuge des Projekts.
- Lesen Sie die Fehlerliste als Vorbild. Offene Fehler nach Schweregrad und Konfiguration zu veröffentlichen, ist eine nützliche Gewohnheit für jedes Projekt, ob KI-geschrieben oder nicht. So sehen Nutzer genau, was zugesagt wird.
Quellen
- MeshXFS: AI Adapts XFS Into A Clustered File-System - Phoronix
- sshoecraft/meshxfs - GitHub
Ähnliche Artikel
Linux-Kernel will sein KI-Tag Assisted-by streichen
Nur etwa 10 % der Commits in Linux 7.3 trugen das KI-Tag Assisted-by, daher haben sich die Kernel-Maintainer darauf geeinigt, es zu streichen. Torvalds unterstützt die Änderung; Kritiker wollen einen Ersatz.
Torvalds nutzt Claude Code, um den Linux-Seitencache umzubauen
Linus Torvalds hat acht Linux-Kernel-Patches veröffentlicht, die mit Claude Code entstanden sind. Auf seinem Laptop brauchten kleine Lesezugriffe mit 8 Threads etwa 4-mal weniger CPU-Zyklen.
Linux LZ4: Resync auf v1.10.0 macht Dekompression bis zu 21% schneller
Eine Serie aus 9 Patches bringt den LZ4-Code des Kernels aus den Jahren 2017-2018 auf Upstream v1.10.0, ergänzt Grenzprüfungen und beschleunigt die Dekompression bei 16K-Blöcken um 21%.