Ling-3.1-flash: Ant Group öffnet 560B-Modell unter MIT-Lizenz
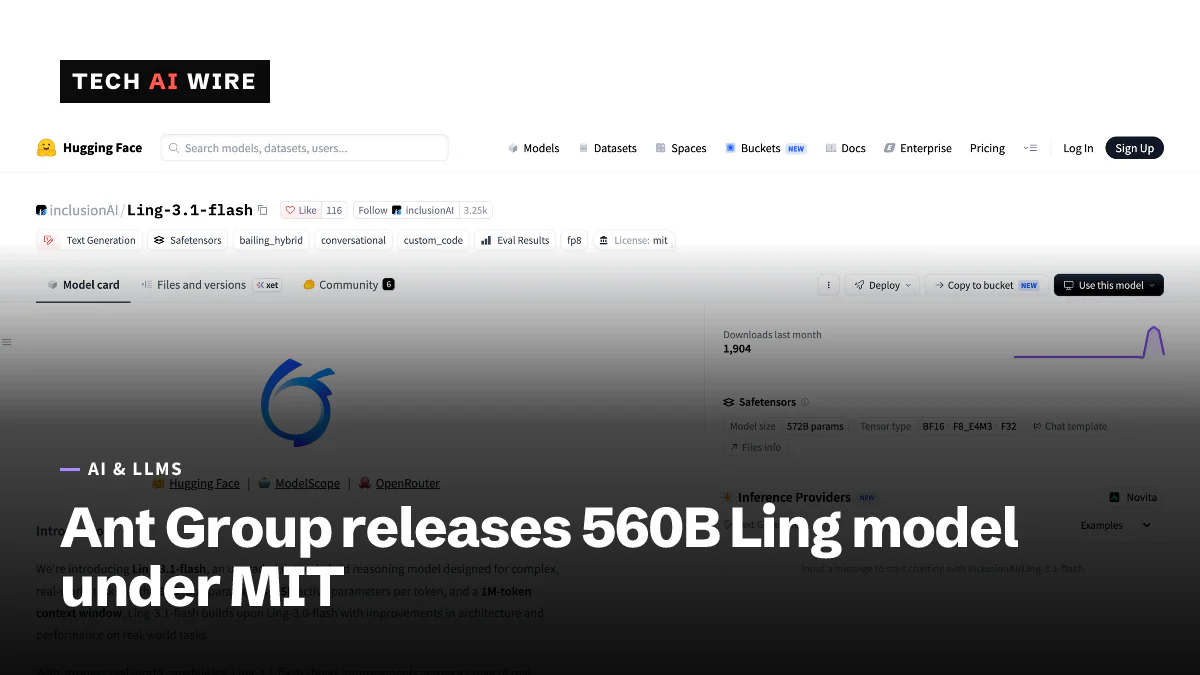
Ant Groups inclusionAI hat die Gewichte von Ling-3.1-flash unter der MIT-Lizenz veröffentlicht: 560B Parameter, davon 25B aktiv pro Token, und 1M Token Kontext.
3 Min. Lesezeit
Die Zahlen
- total parameters
- 560B
- parameters active for each token
- 25B
- tokens of context
- 1M
- H200 GPUs in the recommended serving setup
- 8
Das KI-Forschungsteam der Ant Group, inclusionAI, hat die Gewichte von Ling-3.1-flash unter der MIT-Lizenz auf Hugging Face veröffentlicht. Das Modell hat 560 Milliarden Parameter, nutzt 25 Milliarden davon pro Token und liest bis zu 1 Million Token auf einmal. Die MIT-Lizenz bedeutet, dass Unternehmen mit sehr wenigen Auflagen Produkte darauf aufbauen können.
Was inclusionAI veröffentlicht hat
Die Modellkarte auf Hugging Face beschreibt ein "hybrid-lineares" Mixture-of-Experts-Modell. Ein Mixture-of-Experts-Modell verteilt seine Arbeit auf viele kleine Experten-Netze und schaltet pro Token nur einige davon ein. Ein Token ist das Wortstück, das ein Modell liest oder schreibt. Ling-3.1-flash hat 512 geroutete Experten und schaltet pro Token 8 davon ein, dazu 1 gemeinsamen Experten.
"Hybrid-linear" bezieht sich auf die Attention-Schichten, also den Teil eines Modells, der jedes Wort zu den anderen in Beziehung setzt. Die meisten der 72 Attention-Schichten nutzen eine günstigere lineare Bauweise, und 9 nutzen eine vollständigere Bauweise namens Gated MLA.
Der erste Commit des Repositorys stammt vom 13. Oktober, und die Modellkarte wurde zuletzt am 15. Oktober aktualisiert. Tech360 berichtet, dass Ant das Modell zunächst als zweiwöchige kostenlose API-Testphase angeboten hat, begrenzt auf 256.000 Token Kontext. Ant versprach das volle Fenster und die Gewichte für die Zeit nach der Testphase und veröffentlichte sie, als die Testphase endete.
Wie es abschneidet
Die Modellkarte nennt diese Ergebnisse. Es sind inclusionAIs eigene Werte, und die Karte nennt nicht die Modelle, mit denen sie vergleicht.
| Benchmark | Ling-3.1-flash |
|---|---|
| SWE-bench Multilingual | 88,5 |
| Terminal-Bench 2.1 | 81,18 |
| SWE-bench Pro | 68,74 |
| SkillsBench v1.1 | 68,7 |
| Deep SWE | 59,7 |
| Terminal-Bench 4 | 46,03 |
| Humanity's Last Exam | 37,44 |
Eine Sicht von außen kommt von Artificial Analysis, einer unabhängigen Benchmarking-Firma. AlphaSignal berichtete am 6. Oktober, dass sie dem gehosteten Modell 41 Punkte auf ihrem Intelligence Index gab, nach 20 für Ling 3.0 Flash. Am meisten legten Agenten-Aufgaben zu: AutomationBench-AA stieg von 3 % auf 62 %.
Was der Betrieb erfordert
Die Gewichte sind groß. AlphaSignal bezifferte den Speicherbedarf auf 1,12 TB in voller BF16-Präzision, 560 GB bei 8 Bit und 280 GB bei 4 Bit.
Die Modellkarte empfiehlt SGLang, eine Serving-Engine, auf 8 Nvidia-H200-GPUs oder 4 GB300-GPUs. Sie liefert auch ein Rezept für vLLM, eine weitere Engine. Beide nutzen Multi-Token-Prediction, einen Trick, bei dem das Modell mehrere Token im Voraus entwirft, um die Ausgabe zu beschleunigen. Die Karte verweist außerdem auf quantisierte Versionen für llama.cpp, Ollama und LM Studio, die das Modell verkleinern, damit es auf kleineren Rechnern läuft.
| Bezugsquelle | Detail |
|---|---|
| Hugging Face | Gewichte, MIT-Lizenz |
| ModelScope | Gewichte |
| OpenRouter | Gehostete API |
| Novita | Gehostete API, auch auf Hugging Face gelistet |
Am 6. Oktober nannte AlphaSignal für Novita einen Preis von 0,30 $ pro Million Eingabe-Token und 0,90 $ pro Million Ausgabe-Token. Tech360 ergänzt, dass Ant LingCode gebaut hat, einen Coding-Harness auf Basis des Open-Source-Agenten Pi, und ihn später als Open Source veröffentlichen könnte.
Wie es bei den Kosten abschneidet
Der Preis pro Token ist bei Agenten, die viele Schritte lang laufen, nicht die ganzen Kosten. AlphaSignal zitierte Zahlen von Artificial Analysis zu den Kosten einer Benchmark-Aufgabe. Ling 3.1 Flash kam auf 0,99 $, gegenüber 0,32 $ für DeepSeek V4.1 Flash im Max-Modus und 1,24 $ für Gemini 3.8 Flash in der Einstellung High. DeepSeek hat heute einen aktualisierten Checkpoint von V4.1 Flash veröffentlicht, daher hat sich dieser Abstand womöglich verschoben.
Ling-3.1-flash kommt in einer vollen Woche für große offene Modelle. Meta hat am 15. Oktober Muse Spark Open mit 816 Milliarden Parametern veröffentlicht.
Was das für Entwickler bedeutet
Für die meisten Teams ist die MIT-Lizenz die wichtigste Nachricht. Sie erlaubt kommerzielle Nutzung und Änderungen mit wenigen Auflagen, die rechtliche Prüfung sollte also kurz ausfallen. Metas Modell nutzt dagegen eine eigene Lizenz.
Selbst hosten bleibt eine Aufgabe für Rechenzentren. Acht H200 sind der empfohlene Ausgangspunkt, daher werden die meisten Teams mit OpenRouter oder Novita beginnen. Vergleichen Sie deren Preise mit dem Wert aus der Testphase, da keine der Quellen einen Preis für die Zeit nach der Testphase nennt.
Testen Sie es an Ihrer eigenen Arbeit mit langem Kontext. Ein Fenster von 1 Million Token hilft nur, wenn die Qualität bis zum Ende einer langen Eingabe hält, und die Werte auf inclusionAIs Karte enthalten keinen Test für langen Kontext.
Prüfen Sie die Benchmark-Harnesses, bevor Sie vergleichen. Anbieter führen Terminal-Bench und SWE-bench in unterschiedlichen Setups aus, daher bedeuten ein paar Punkte Unterschied zwischen zwei Modellkarten womöglich wenig.
Quellen
Ähnliche Artikel

Xiaomi veröffentlicht MiMo-V2.6-Pro mit 1 Billion Parametern als offene Gewichte unter MIT
Xiaomis MiMo-V2.6-Pro hat 1,02 Billionen Parameter, davon 42 Milliarden aktiv, einen Kontext von 1 Million Tokens und MIT-lizenzierte Gewichte, braucht aber rund 680 GB GPU-Speicher.
StepFun Step 5 Preview: 600B-Agentenmodell mit offenen Gewichten
Step 5 Preview von StepFun, ein Modell mit 600B Parametern, davon 27B aktiv, und 1M Token Kontext, ist auf Hugging Face. Zuvor gab es das Modell einen Monat nur per API, zu 1 $/2,70 $ pro Mio. Tokens.
Meta Muse Spark Open: 816B offene Gewichte veröffentlicht
Meta hat Muse Spark Open veröffentlicht, ein Modell mit offenen Gewichten, 816B Parametern, davon 42B aktiv, und 1M Token Kontext, auf Hugging Face und drei Cloud-Plattformen.