Ling-3.1-flash: Ant Group abre un modelo de 560B bajo licencia MIT
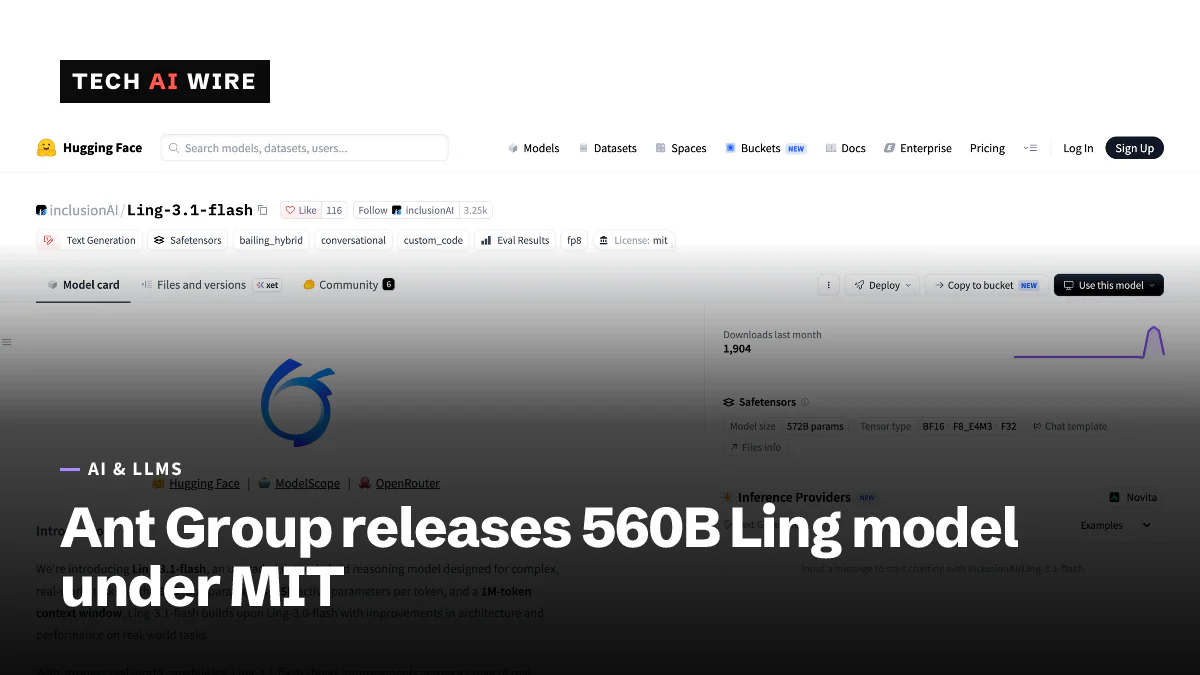
inclusionAI, de Ant Group, publicó los pesos de Ling-3.1-flash bajo la licencia MIT: 560B parámetros, 25B activos por token y un contexto de 1M de tokens.
3 min de lectura
En cifras
- total parameters
- 560B
- parameters active for each token
- 25B
- tokens of context
- 1M
- H200 GPUs in the recommended serving setup
- 8
El equipo de investigación de IA de Ant Group, inclusionAI, ha publicado los pesos de Ling-3.1-flash en Hugging Face bajo la licencia MIT. El modelo tiene 560.000 millones de parámetros, usa 25.000 millones para cada token y lee hasta 1 millón de tokens a la vez. La licencia MIT significa que las empresas pueden crear productos sobre él con muy pocas condiciones.
Qué publicó inclusionAI
La ficha del modelo en Hugging Face describe un modelo de mezcla de expertos "híbrido-lineal". Un modelo de mezcla de expertos reparte su trabajo entre muchas redes expertas pequeñas y solo activa unas pocas para cada token, el fragmento de palabra que un modelo lee o escribe. Ling-3.1-flash tiene 512 expertos enrutados y activa 8 de ellos por token, más 1 experto compartido.
"Híbrido-lineal" se refiere a sus capas de atención, la parte de un modelo que relaciona cada palabra con las demás. La mayoría de sus 72 capas de atención usan un diseño lineal más barato, y 9 usan un diseño más completo llamado Gated MLA.
El primer commit del repositorio tiene fecha del 13 de octubre, y la ficha del modelo se actualizó por última vez el 15 de octubre. Tech360 informa de que Ant ofreció primero el modelo como una prueba gratuita de API de dos semanas, limitada a 256.000 tokens de contexto. Prometió la ventana completa y los pesos tras la prueba, y los publicó cuando la prueba terminó.
Qué puntuación obtiene
La ficha del modelo recoge estos resultados. Son cifras propias de inclusionAI, y la ficha no nombra los modelos con los que se compara.
| Benchmark | Ling-3.1-flash |
|---|---|
| SWE-bench Multilingual | 88,5 |
| Terminal-Bench 2.1 | 81,18 |
| SWE-bench Pro | 68,74 |
| SkillsBench v1.1 | 68,7 |
| Deep SWE | 59,7 |
| Terminal-Bench 4 | 46,03 |
| Humanity's Last Exam | 37,44 |
Una visión externa llega de Artificial Analysis, una empresa independiente de benchmarks. AlphaSignal informó el 6 de octubre de que esta empresa dio al modelo alojado un 41 en su Intelligence Index, frente al 20 de Ling 3.0 Flash. Las tareas de agentes fueron las que más ganaron: AutomationBench-AA pasó del 3 % al 62 %.
Qué hace falta para ejecutarlo
Los pesos son grandes. AlphaSignal cifró la memoria en 1,12 TB con precisión BF16 completa, 560 GB a 8 bits y 280 GB a 4 bits.
La ficha del modelo recomienda SGLang, un motor de servicio, en 8 GPU Nvidia H200 o 4 GPU GB300. También da una receta para vLLM, otro motor. Ambos usan predicción de múltiples tokens, un truco en el que el modelo esboza varios tokens por adelantado para acelerar la salida. La ficha también remite a versiones cuantizadas para llama.cpp, Ollama y LM Studio, que reducen el modelo para que funcione en máquinas más pequeñas.
| Dónde conseguirlo | Detalle |
|---|---|
| Hugging Face | Pesos, licencia MIT |
| ModelScope | Pesos |
| OpenRouter | API alojada |
| Novita | API alojada, también listada en Hugging Face |
El 6 de octubre, AlphaSignal indicó que el precio de Novita era de 0,30 dólares por millón de tokens de entrada y 0,90 dólares por millón de tokens de salida. Tech360 añade que Ant creó LingCode, un entorno de programación construido sobre el agente de código abierto Pi, y que podría publicarlo como código abierto más adelante.
Cómo se compara en coste
El precio por token no es todo el coste para los agentes, que ejecutan muchos pasos. AlphaSignal citó cifras de Artificial Analysis sobre el coste de una tarea de benchmark. Ling 3.1 Flash salió a 0,99 dólares, frente a 0,32 dólares de DeepSeek V4.1 Flash en su modo Max y 1,24 dólares de Gemini 3.8 Flash en su ajuste High. DeepSeek lanzó hoy un checkpoint actualizado de V4.1 Flash, así que esa diferencia puede haber cambiado.
Ling-3.1-flash se suma a una semana intensa de grandes modelos abiertos. Meta publicó Muse Spark Open con 816.000 millones de parámetros el 15 de octubre.
Qué significa esto para los desarrolladores
La licencia MIT es lo más destacado para la mayoría de los equipos. Permite el uso comercial y las modificaciones con pocas condiciones, así que la revisión legal debería ser breve. El modelo de Meta, en cambio, usa una licencia propia.
Autoalojarlo sigue siendo trabajo de centro de datos. Ocho H200 son el punto de partida recomendado, así que la mayoría de los equipos empezará en OpenRouter o Novita. Compara sus precios con la cifra de la prueba, ya que ninguna de las fuentes da un precio posterior a la prueba.
Pruébalo con tu propio trabajo de contexto largo. Una ventana de 1 millón de tokens solo ayuda si la calidad se mantiene cerca del final de una entrada larga, y las puntuaciones de la ficha de inclusionAI no incluyen una prueba de contexto largo.
Revisa los entornos de benchmark antes de comparar. Los proveedores ejecutan Terminal-Bench y SWE-bench con configuraciones distintas, así que unos pocos puntos entre dos fichas de modelo pueden no significar mucho.
Fuentes
Artículos relacionados

Xiaomi lanza MiMo-V2.6-Pro con 1 billón de parámetros en pesos abiertos bajo MIT
MiMo-V2.6-Pro de Xiaomi tiene 1,02 billones de parámetros, 42.000 millones activos, un contexto de 1 millón de tokens y pesos con licencia MIT, pero necesita unos 680 GB de memoria de GPU.
StepFun Step 5 Preview: modelo para agentes de 600B con pesos abiertos
Step 5 Preview de StepFun, un modelo de 600B parámetros con 27B activos y un contexto de 1M de tokens, está en Hugging Face tras un mes solo por API a 1 y 2,70 dólares por millón.
Meta Muse Spark Open publica 816B de pesos abiertos
Meta publicó Muse Spark Open, un modelo de pesos abiertos con 816B parámetros, 42B activos y un contexto de 1M de tokens, en Hugging Face y tres plataformas en la nube.