Ling-3.1-flash : Ant Group ouvre un modèle de 560B sous licence MIT
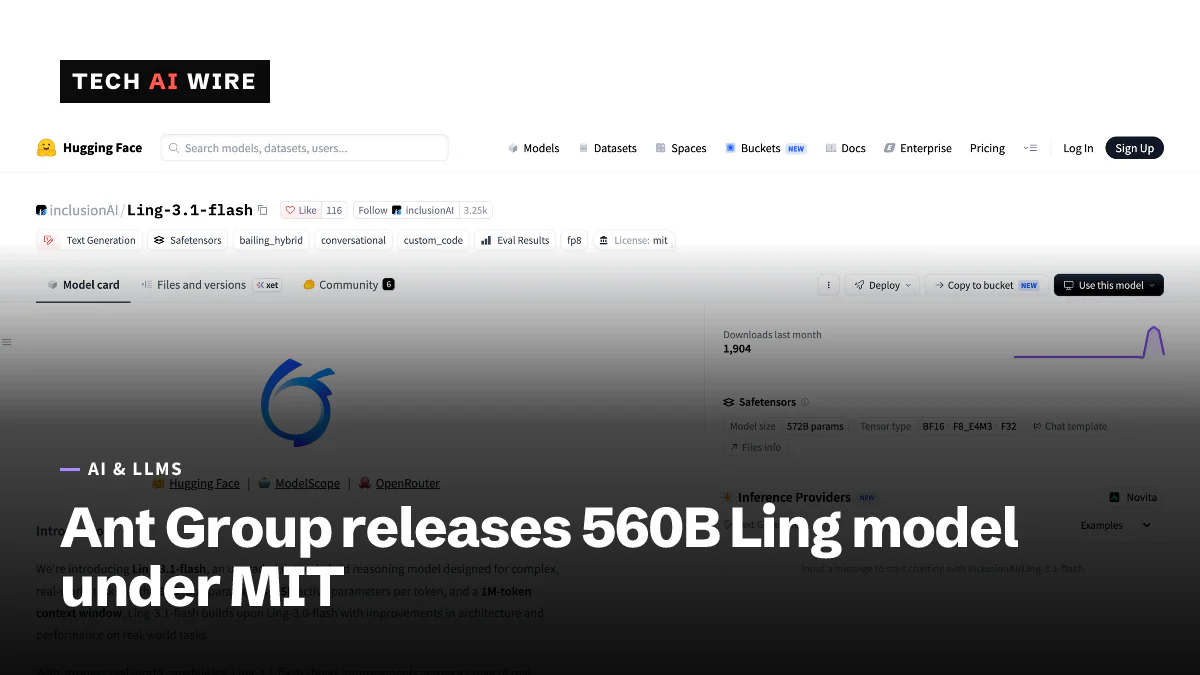
L'équipe inclusionAI d'Ant Group a publié les poids de Ling-3.1-flash sous licence MIT : 560B paramètres, dont 25B actifs par token, et un contexte de 1M de tokens.
3 min de lecture
En chiffres
- total parameters
- 560B
- parameters active for each token
- 25B
- tokens of context
- 1M
- H200 GPUs in the recommended serving setup
- 8
L'équipe de recherche en IA d'Ant Group, inclusionAI, a publié les poids de Ling-3.1-flash sur Hugging Face sous licence MIT. Le modèle compte 560 milliards de paramètres, en utilise 25 milliards pour chaque token et lit jusqu'à 1 million de tokens d'un coup. La licence MIT signifie que les entreprises peuvent bâtir des produits sur ce modèle avec très peu de conditions.
Ce qu'inclusionAI a publié
La fiche du modèle sur Hugging Face décrit un modèle à mélange d'experts « hybride-linéaire ». Un modèle à mélange d'experts répartit son travail entre de nombreux petits réseaux experts et n'en active que quelques-uns pour chaque token, le fragment de mot qu'un modèle lit ou écrit. Ling-3.1-flash compte 512 experts routés et en active 8 par token, plus 1 expert partagé.
« Hybride-linéaire » désigne ses couches d'attention, la partie d'un modèle qui relie chaque mot aux autres. La plupart de ses 72 couches d'attention utilisent une conception linéaire moins coûteuse, et 9 utilisent une conception plus complète appelée Gated MLA.
Le premier commit du dépôt date du 13 octobre, et la fiche du modèle a été mise à jour pour la dernière fois le 15 octobre. Tech360 rapporte qu'Ant a d'abord proposé le modèle sous forme d'essai gratuit de l'API pendant deux semaines, limité à 256 000 tokens de contexte. L'entreprise avait promis la fenêtre complète et les poids après l'essai, et les a publiés à la fin de celui-ci.
Ses scores
La fiche du modèle liste ces résultats. Ce sont les chiffres d'inclusionAI, et la fiche ne nomme pas les modèles auxquels elle se compare.
| Benchmark | Ling-3.1-flash |
|---|---|
| SWE-bench Multilingual | 88,5 |
| Terminal-Bench 2.1 | 81,18 |
| SWE-bench Pro | 68,74 |
| SkillsBench v1.1 | 68,7 |
| Deep SWE | 59,7 |
| Terminal-Bench 4 | 46,03 |
| Humanity's Last Exam | 37,44 |
Un regard extérieur vient d'Artificial Analysis, une société indépendante de benchmarks. AlphaSignal a rapporté le 6 octobre qu'elle avait attribué au modèle hébergé un score de 41 à son Intelligence Index, contre 20 pour Ling 3.0 Flash. Les tâches d'agents ont le plus progressé : AutomationBench-AA est passé de 3 % à 62 %.
Ce qu'il faut pour le faire tourner
Les poids sont volumineux. AlphaSignal a estimé la mémoire nécessaire à 1,12 To en pleine précision BF16, 560 Go en 8 bits et 280 Go en 4 bits.
La fiche du modèle recommande SGLang, un moteur de service, sur 8 GPU Nvidia H200 ou 4 GPU GB300. Elle donne aussi une recette pour vLLM, un autre moteur. Les deux utilisent la prédiction multi-tokens, une astuce où le modèle prépare plusieurs tokens à l'avance pour accélérer la sortie. La fiche renvoie aussi vers des versions quantifiées pour llama.cpp, Ollama et LM Studio, qui réduisent le modèle pour le faire tourner sur des machines plus modestes.
| Où le trouver | Détail |
|---|---|
| Hugging Face | Poids, licence MIT |
| ModelScope | Poids |
| OpenRouter | API hébergée |
| Novita | API hébergée, également listée sur Hugging Face |
Le 6 octobre, AlphaSignal indiquait le prix de Novita à 0,30 $ par million de tokens en entrée et 0,90 $ par million de tokens en sortie. Tech360 ajoute qu'Ant a construit LingCode, un harnais de code bâti sur l'agent open source Pi, et pourrait le rendre open source plus tard.
Comment il se compare sur le coût
Pour les agents, qui enchaînent de nombreuses étapes, le prix par token ne représente pas tout le coût. AlphaSignal a cité des chiffres d'Artificial Analysis sur le coût d'une tâche de benchmark. Ling 3.1 Flash arrivait à 0,99 $, contre 0,32 $ pour DeepSeek V4.1 Flash en mode Max et 1,24 $ pour Gemini 3.8 Flash avec son réglage High. DeepSeek a publié aujourd'hui un checkpoint mis à jour de V4.1 Flash, donc cet écart a peut-être bougé.
Ling-3.1-flash arrive dans une semaine chargée pour les grands modèles ouverts. Meta a publié Muse Spark Open, avec 816 milliards de paramètres, le 15 octobre.
Ce que cela signifie pour les développeurs
La licence MIT est l'information principale pour la plupart des équipes. Elle autorise l'usage commercial et les modifications avec peu de conditions, donc la revue juridique devrait être courte. Le modèle de Meta, à l'inverse, utilise une licence sur mesure.
L'auto-hébergement reste un travail de data center. Huit H200 sont le point de départ recommandé, donc la plupart des équipes commenceront sur OpenRouter ou Novita. Comparez leurs prix au chiffre de l'essai, puisqu'aucune des sources ne donne de prix après l'essai.
Testez-le sur votre propre travail à long contexte. Une fenêtre de 1 million de tokens n'aide que si la qualité tient vers la fin d'une longue entrée, et les scores de la fiche d'inclusionAI n'incluent aucun test de long contexte.
Vérifiez les harnais de benchmark avant de comparer. Les fournisseurs exécutent Terminal-Bench et SWE-bench dans des configurations différentes, donc quelques points d'écart entre deux fiches de modèle ne veulent peut-être pas dire grand-chose.
Sources
Articles liés

Xiaomi publie MiMo-V2.6-Pro, 1 000 milliards de paramètres en poids ouverts sous MIT
Le MiMo-V2.6-Pro de Xiaomi compte 1 020 milliards de paramètres, dont 42 milliards actifs, un contexte de 1 million de tokens et des poids sous licence MIT, mais il demande environ 680 Go de mémoire GPU.
StepFun Step 5 Preview : un modèle pour agents de 600B à poids ouverts
Step 5 Preview de StepFun, un modèle de 600B paramètres dont 27B actifs, avec un contexte de 1M de tokens, arrive sur Hugging Face après un mois limité à l'API, à 1 $/2,70 $ par million.
Meta Muse Spark Open publie 816B de poids ouverts
Meta a publié Muse Spark Open, un modèle à poids ouverts de 816B paramètres, dont 42B actifs, avec un contexte de 1M de tokens, sur Hugging Face et trois plateformes cloud.