DeepSeek veröffentlicht die Inferenz-Engine DeepInfer als Open Source
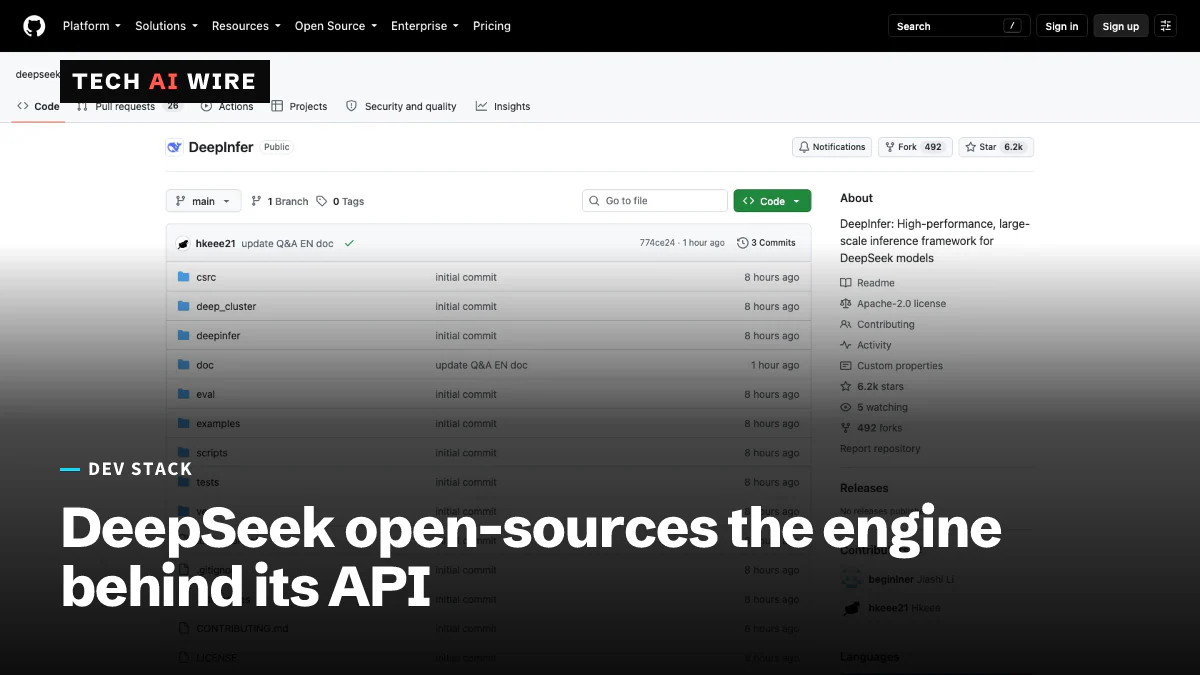
Die Engine hinter DeepSeeks eigener API ist jetzt Code unter Apache 2.0. Sie führt V4.1-Flash auf SM100-GPUs von Nvidia und Huaweis Chips Ascend 950 aus, ohne eine KV-Cache-Schicht.
3 Min. Lesezeit
Die Zahlen
- license for the DeepInfer code
- Apache 2.0
- chip families: Nvidia SM100 and Huawei Ascend 950
- 2
- pieces of a full service left out of this release
- 3
DeepSeek hat am 20. Oktober 2026 DeepInfer als Open Source veröffentlicht. Mit dieser Software führt das Unternehmen seine eigenen KI-Modelle im Produktivbetrieb aus. Der Code steht unter der Lizenz Apache 2.0 und unterstützt Chips von Nvidia und von Huawei. Er zeigt Außenstehenden, wie DeepSeek seine eigenen Modelle bereitstellt, auch wenn einige wichtige Teile zurückgehalten werden.
Was DeepInfer ist
Eine Inferenz-Engine ist die Software, die ein trainiertes KI-Modell ausführt und Anfragen in Antworten verwandelt. Sie entscheidet, wie das Modell auf Chips aufgeteilt wird, wie Anfragen zu Batches gebündelt werden und wie schnell Token herauskommen. Diese Arbeit bestimmt zu einem großen Teil die Kosten eines KI-Dienstes.
"DeepInfer ist das leistungsstarke Inferenz-Framework, das die großen Produktivdienste von DeepSeek antreibt", heißt es auf der GitHub-Seite des Projekts. Laut Repository wurde es ursprünglich hauptsächlich auf vLLM aufgebaut, einer beliebten Open-Source-Engine, mit Ideen aus SGLang und Nvidias TensorRT-LLM.
Vorerst unterstützt es ein Modell: DeepSeek-V4.1-Flash, mit dem Update V4.1-Flash-1017 als Standard. DeepSeek will Code für künftige Modelle im selben Framework unterbringen, so die Ankündigung, wie TechFlow sie wiedergibt.
Hardware von Nvidia und Huawei
DeepInfer läuft auf zwei Arten von Chips: Nvidias Rechenzentrums-GPUs der Generation SM100 und Huaweis NPUs vom Typ Ascend 950. Eine NPU ist ein Prozessor, der für KI-Arbeit gebaut ist. Die Unterstützung für Huaweis Chips ist wichtig, weil DeepSeek große Bestellungen davon geplant hat.
| Anforderung | Detail |
|---|---|
| Betriebssystem | Linux |
| Compiler | GCC 13 oder neuer |
| Python | 3.12 |
| Nvidia-Software | CUDA 13 |
| Huawei-Software | CANN 9.2 |
| Lizenz | Apache 2.0 |
Die Einrichtung ist laut README kurz. Sie setzen DEEPINFER_ACCELERATOR auf nvidia oder ascend, führen ./build.sh aus und danach python examples/offline_inference.py. Das Standardmodell wird beim ersten Start von Hugging Face heruntergeladen.
Funktionen der Veröffentlichung
Das README nennt die wichtigsten Bausteine:
- Eigene Kernel. Von Hand optimierter Chip-Code, darunter FlashMLA, DeepGEMM, DeepEP und in TileLang geschriebene Kernel.
- Parallelisierung. Die Arbeit wird nach Daten und nach Experten auf Chips verteilt. DeepSeeks Modelle sind Mixture-of-Experts-Designs, die jedes Token an einige spezialisierte Teilnetze weiterleiten.
- Spekulatives Decoding. Eine Funktion namens DSpark rät mehrere Token im Voraus und prüft sie, was die Ausgabe beschleunigt.
- Strukturierte Ausgaben. Antworten lassen sich so erzwingen, dass sie einem regulären Ausdruck, einem JSON-Schema oder einer Grammatik entsprechen.
- Wiederholbare Ergebnisse. Auf Nvidia-Chips liefert ein batch-invarianter Modus mit festen Seeds identische Ausgaben für identische Eingaben.
DeepSeek hat außerdem deepseek-recipe veröffentlicht, ein Werkzeug, das Text in Token und wieder zurück umwandelt und auf die offizielle API abgestimmt ist, berichtet Crypto Briefing.
Was fehlt
Die Veröffentlichung ist kein vollständiger Dienst. "Diese Open-Source-Veröffentlichung bietet Offline-Inferenz mit den Kernfunktionen, die für den Betrieb im großen Maßstab nötig sind", heißt es im README. Es nennt drei Teile, die für einen vollständigen Dienst nötig sind und "in dieser Veröffentlichung nicht enthalten" sind:
- Ein KV-Cache-System, das frühere Arbeit speichert, damit wiederholte Prompts günstiger werden.
- Die Disaggregation von Prefill und Decode, bei der die Lese- und die Schreibphase auf getrennten Maschinen laufen.
- Lastverteilung über mehrere Kopien des Modells.
Auch die Leistungsangaben sind unklar. Das README zeigt nur Diagramme, gemessen auf 4 SM100-GPUs für die Prompt-Verarbeitung und auf 64 für die Ausgabe. Crypto Briefing nennt Zahlen wie 155 Billionen Token pro Tag und Cluster sowie eine Cache-Trefferquote von 96 % bei Eingaben. Diese Zahlen stehen nicht im README, und ein Thread auf Hacker News führte die Token-Zahl auf einen Beitrag bei Zhihu zurück, einer chinesischen Frage-und-Antwort-Seite.
Was das für Entwickler bedeutet
DeepInfer ist weniger ein Server zum direkten Einsetzen als ein detaillierter Einblick, wie DeepSeek seine Modelle günstig betreibt. Sein Wert hängt von Ihrer Hardware ab und davon, wie viel Sie selbst bauen wollen.
- Prüfen Sie zuerst Ihre Hardware. DeepInfer zielt nur auf Nvidia-GPUs der SM100-Klasse und NPUs vom Typ Ascend 950. Ältere GPUs sind nicht aufgeführt, also können Teams ohne diese Hardware es nicht ohne Weiteres ausführen.
- Planen Sie, die fehlenden Teile selbst zu bauen. Ohne KV-Cache, Disaggregation oder Lastverteilung brauchen Sie für Produktiv-Traffic eine eigene Serving-Schicht.
- Lesen Sie die Kernel, auch wenn Sie DeepInfer nie einsetzen. Teams, die Mixture-of-Experts-Modelle auf vLLM oder SGLang betreiben, können den Code für Parallelisierung und spekulatives Decoding nach Ideen durchsuchen.
- Nutzen Sie den wiederholbaren Modus zum Testen. Identische Ausgaben für identische Eingaben machen Regressionstests bei Modelländerungen auf Nvidia-Hardware viel einfacher.
- Behandeln Sie Durchsatzangaben als unbestätigt. Führen Sie das Sweep-Skript des Repositorys auf Ihren eigenen Chips aus, bevor Sie DeepInfer mit Ihrer aktuellen Engine vergleichen.
Quellen
- deepseek-ai/DeepInfer - GitHub
- DeepSeek open-sources DeepInfer, the inference engine behind its production models - Crypto Briefing
- DeepSeek Announces Full Open-Sourcing of Its Internal Inference Framework, DeepInfer - TechFlow via KuCoin
Ähnliche Artikel
NVIDIA Run:ai wird Open Source, samt GPU-Sharing
NVIDIA hat die komplette GPU-Orchestrierungsplattform Run:ai am 13. Oktober als Open Source veröffentlicht, aufgeteilt in vier Module, die Teams einzeln einführen können.
DeepSeek Harness Desktop erscheint für macOS und Windows
DeepSeeks MIT-lizenzierter Agent Harness erscheint jetzt als offizielle Desktop-App für Macs mit Apple silicon und 64-Bit-Windows, ohne dass Node.js installiert werden muss.
SDL3 unterstützt jetzt HarmonyOS, Ziel ist SDL 3.6.0
Ryan Gordons Portierung, von Outfit7 gesponsert und aus 77 Commits zusammengefasst, wurde am 15. September 2026 upstream übernommen, mit funktionierendem Video, Audio und Touch.