DeepSeek、推論エンジンDeepInferをオープンソース化
DeepSeek(ディープシーク)が自社APIを支えるエンジンを、Apache 2.0のコードとして公開しました。NvidiaのSM100 GPUとHuaweiのAscend 950チップでV4.1-Flashを動かします。ただし、KVキャッシュの層は含まれていません。
3 分で読めます
数字で見る
- license for the DeepInfer code
- Apache 2.0
- chip families: Nvidia SM100 and Huawei Ascend 950
- 2
- pieces of a full service left out of this release
- 3
DeepSeekは2026年10月20日、DeepInferをオープンソースとして公開しました。DeepInferは、同社が自社のAIモデルを本番環境で動かすために使っているソフトウェアです。コードはApache 2.0ライセンスで、NvidiaとHuaweiの両方のチップに対応しています。DeepSeekが自社モデルをどのように提供しているのかを外部に示すものですが、いくつかの重要な部分は公開されていません。
DeepInferとは
推論エンジンとは、学習済みのAIモデルを動かし、リクエストを回答に変えるソフトウェアです。モデルを複数のチップにどう分けるか、リクエストをどうまとめて処理するか、トークンをどれだけ速く出力するかを決めます。AIサービスのコストの大部分は、この処理で決まります。
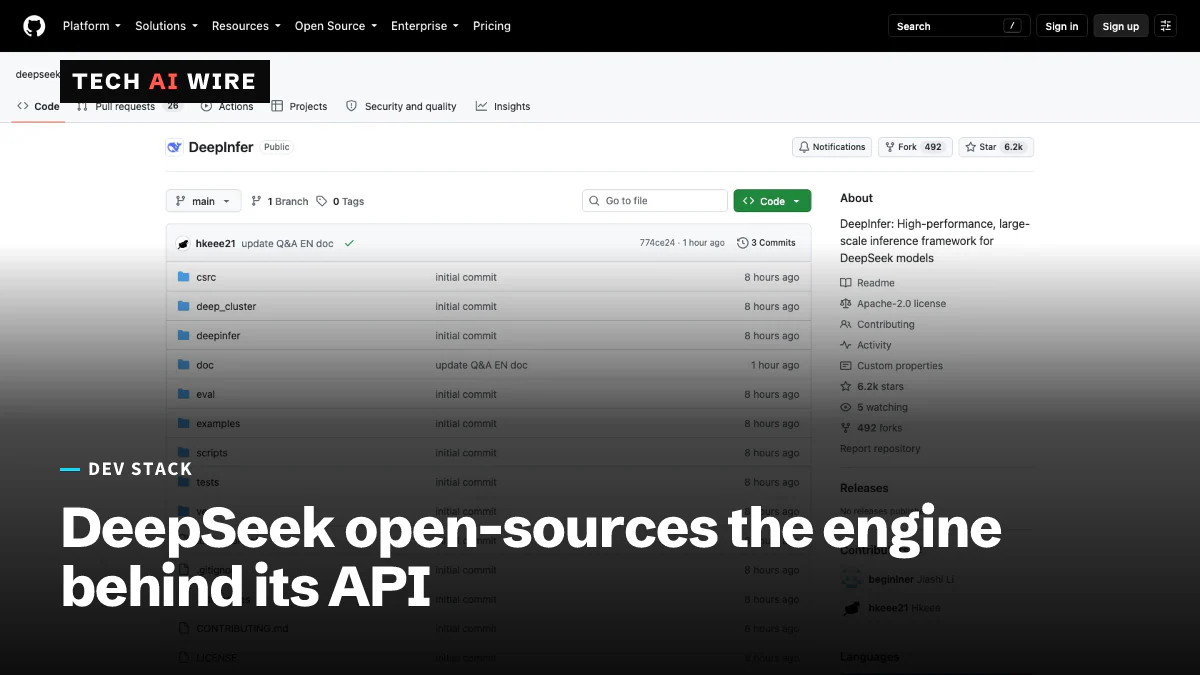
プロジェクトのGitHubページには、「DeepInferは、DeepSeekの大規模な本番サービスを支える高性能な推論フレームワークです」と書かれています。リポジトリによると、もともとは主にvLLMをもとに作られました。vLLMは人気のあるオープンソースのエンジンです。SGLangとNvidiaのTensorRT-LLMの考え方も取り入れています。
現時点で対応しているモデルは、DeepSeek-V4.1-Flashの1つだけです。デフォルトではV4.1-Flash-1017アップデートを使います。TechFlowが伝えた発表によると、DeepSeekは今後のモデルのコードも同じフレームワークに追加する予定です。
NvidiaとHuaweiのハードウェア
DeepInferは2種類のチップで動きます。NvidiaのSM100世代のデータセンター向けGPUと、HuaweiのAscend 950 NPUです。NPUとは、AIの処理向けに作られたプロセッサーです。Huaweiのチップへの対応が重要なのは、DeepSeekがこのチップの大量発注を計画しているからです。
| 要件 | 詳細 |
|---|---|
| オペレーティングシステム | Linux |
| コンパイラー | GCC 13以降 |
| Python | 3.12 |
| Nvidiaのソフトウェア | CUDA 13 |
| Huaweiのソフトウェア | CANN 9.2 |
| ライセンス | Apache 2.0 |
READMEによると、セットアップは短い手順で済みます。DEEPINFER_ACCELERATORをnvidiaかascendに設定し、./build.shを実行してから、python examples/offline_inference.pyを実行します。デフォルトのモデルは、初回の実行時にHugging Faceからダウンロードされます。
今回のリリースに含まれる機能
READMEには、主な要素が次のように挙げられています。
- 独自のカーネル。 手作業で調整したチップ向けのコードです。FlashMLA、DeepGEMM、DeepEP、TileLangで書かれたカーネルが含まれます。
- 並列化。 処理をデータ単位とエキスパート単位でチップに分散します。DeepSeekのモデルは混合エキスパート(Mixture of Experts)設計で、各トークンを少数の専門のサブネットワークに振り分けます。
- 投機的デコーディング。 DSparkという機能が数トークン先を予測して確認し、出力を速くします。
- 構造化出力。 回答を正規表現、JSONスキーマ、文法のいずれかに必ず合わせることができます。
- 再現可能な結果。 Nvidiaのチップでは、シードを固定したバッチ不変モードで、同じ入力に対して同じ出力が得られます。
Crypto Briefingによると、DeepSeekはdeepseek-recipeも公開しました。テキストをトークンに変換し、トークンからテキストに戻すツールで、公式APIと一致するように作られています。
含まれていないもの
今回のリリースは、完全なサービスではありません。READMEには「このオープンソースリリースは、大規模な提供に必要なコア機能を備えたオフライン推論を提供します」とあります。完全なサービスに必要な部分のうち、「今回のリリースには含まれていない」ものとして、次の3つを挙げています。
- KVキャッシュシステム。以前の処理結果を保存し、同じプロンプトを繰り返すときのコストを下げます。
- プリフィルとデコードの分離。読み込みと書き出しの段階を、別々のマシンで実行します。
- モデルの複数のコピーの間での負荷分散。
性能に関する主張も、はっきりしません。READMEにあるのはグラフだけで、プロンプト処理は4基、出力は64基のSM100 GPUで測定したものです。Crypto Briefingは、クラスターあたり1日155兆トークン、入力キャッシュのヒット率96%といった数字を挙げています。これらの数字はREADMEには載っていません。Hacker Newsのスレッドでは、このトークン数の出どころが、中国のQ&AサイトであるZhihuの投稿だと突き止められています。
開発者にとっての意味
DeepInferは、そのまま組み込んで使えるサーバーというより、DeepSeekがどのようにモデルを安く動かしているかを詳しく知るための資料です。その価値は、手元のハードウェアと、自分でどこまで作り込むつもりかによって変わります。
- まずハードウェアを確認してください。 対象はSM100クラスのNvidia GPUとAscend 950 NPUだけです。古いGPUは記載されていないため、このハードウェアがないチームはそのままでは動かせません。
- 足りない部分は自分で作る前提で計画してください。 KVキャッシュ、プリフィルとデコードの分離、負荷分散がないため、本番のトラフィックには独自のサービング層が必要です。
- 導入しないとしても、カーネルを読んでみてください。 vLLMやSGLangで混合エキスパートモデルを動かしているチームは、並列化と投機的デコーディングのコードからヒントを得られます。
- テストには再現モードを使ってください。 同じ入力に同じ出力が返るので、Nvidiaのハードウェアでモデルを変えたときの回帰テストがずっと簡単になります。
- スループットの主張は未検証として扱ってください。 今使っているエンジンと比べる前に、リポジトリのスイープスクリプトを自分のチップで実行してください。
出典
- deepseek-ai/DeepInfer - GitHub
- DeepSeek open-sources DeepInfer, the inference engine behind its production models - Crypto Briefing
- DeepSeek Announces Full Open-Sourcing of Its Internal Inference Framework, DeepInfer - TechFlow via KuCoin
関連記事
NVIDIA Run:aiがオープンソース化、GPU共有機能も含めて公開
NVIDIAは10月13日、GPUオーケストレーション基盤Run:ai(ランエーアイ)の全体をオープンソースとして公開しました。GPU分割(フラクショニング)を含む4つのモジュールに分かれ、1つずつ導入できます。
DeepSeek Harness Desktopが登場、macOSとWindowsに対応
DeepSeek(ディープシーク)がMITライセンスで公開しているエージェントHarnessが、Apple silicon搭載Macと64ビット版Windows向けの公式デスクトップアプリになりました。Node.jsのインストールは不要です。
SDL3がHarmonyOSに対応、SDL 3.6.0で提供へ
Outfit7が支援し77コミットをまとめたRyan Gordon氏の移植が2026年9月15日に上流へ取り込まれました。映像、音声、タッチが動作します。