DeepSeek abre o código do DeepInfer, seu motor de inferência
O motor por trás da própria API da DeepSeek agora é código Apache 2.0. Ele roda o V4.1-Flash em GPUs Nvidia SM100 e chips Huawei Ascend 950, mas sem uma camada de cache KV.
3 min de leitura
Em números
- license for the DeepInfer code
- Apache 2.0
- chip families: Nvidia SM100 and Huawei Ascend 950
- 2
- pieces of a full service left out of this release
- 3
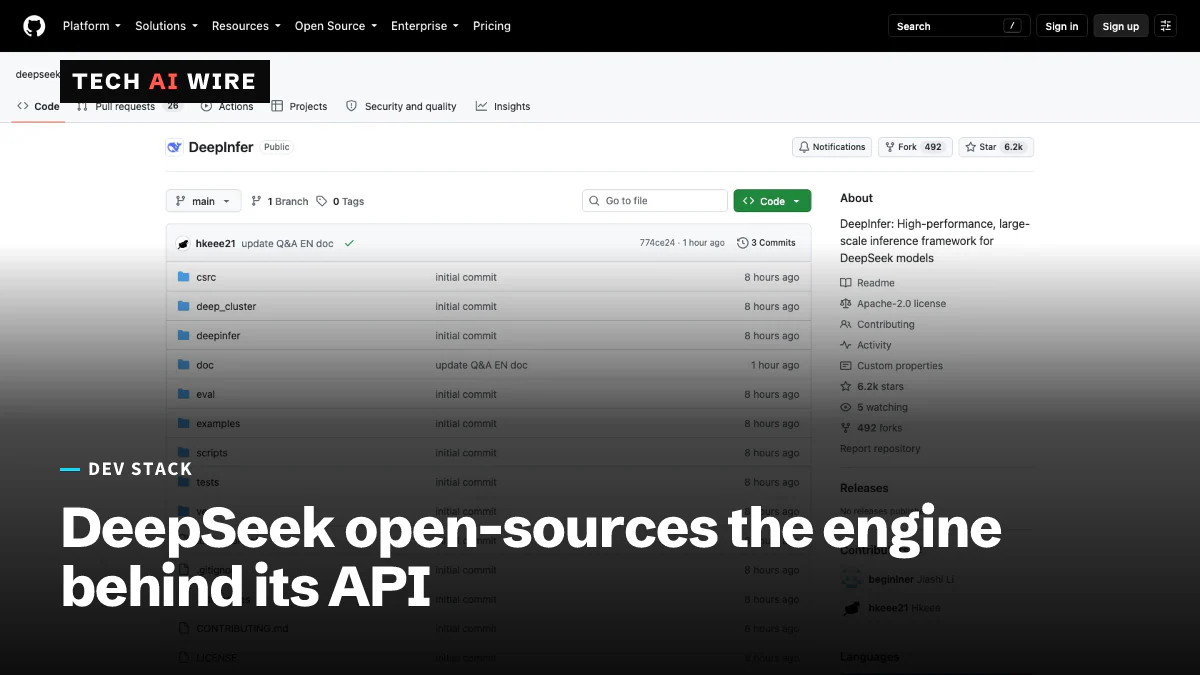
A DeepSeek abriu o código do DeepInfer em 20 de outubro de 2026. É o software que a empresa usa para rodar os próprios modelos de IA em produção. O código está sob a licença Apache 2.0 e funciona com chips da Nvidia e da Huawei. Ele mostra a quem está de fora como a DeepSeek serve os próprios modelos, embora algumas peças-chave continuem retidas.
O que é o DeepInfer
Um motor de inferência é o software que roda um modelo de IA treinado e transforma pedidos em respostas. Ele decide como o modelo é dividido entre os chips, como os pedidos são agrupados em lotes e com que rapidez os tokens saem. Esse trabalho define em grande parte o custo de um serviço de IA.
"O DeepInfer é o framework de inferência de alto desempenho que move os serviços de produção em larga escala da DeepSeek", diz a página do projeto no GitHub. O repositório diz que ele foi construído originalmente, em grande parte, com base no vLLM, um motor de código aberto popular, com ideias do SGLang e do TensorRT-LLM da Nvidia.
Por enquanto, ele suporta um modelo: o DeepSeek-V4.1-Flash, com a atualização V4.1-Flash-1017 como padrão. A DeepSeek planeja colocar o código de modelos futuros no mesmo framework, segundo o anúncio repassado pelo TechFlow.
Hardware da Nvidia e da Huawei
O DeepInfer roda em dois tipos de chips: as GPUs de data center da geração SM100 da Nvidia e as NPUs Ascend 950 da Huawei. Uma NPU é um processador feito para tarefas de IA. O suporte aos chips da Huawei importa porque a DeepSeek planejou grandes pedidos deles.
| Requisito | Detalhe |
|---|---|
| Sistema operacional | Linux |
| Compilador | GCC 13 ou mais recente |
| Python | 3.12 |
| Software da Nvidia | CUDA 13 |
| Software da Huawei | CANN 9.2 |
| Licença | Apache 2.0 |
A configuração é curta, segundo o README. Você define DEEPINFER_ACCELERATOR como nvidia ou ascend, roda ./build.sh e depois roda python examples/offline_inference.py. O modelo padrão é baixado do Hugging Face na primeira execução.
Recursos da versão
O README lista as principais peças:
- Kernels próprios. Código de chip ajustado à mão, incluindo FlashMLA, DeepGEMM, DeepEP e kernels escritos em TileLang.
- Paralelismo. O trabalho é dividido entre os chips por dados e por especialistas. Os modelos da DeepSeek usam o design mixture-of-experts, que envia cada token para algumas sub-redes especializadas.
- Decodificação especulativa. Um recurso chamado DSpark adivinha vários tokens à frente e os confere, o que acelera a saída.
- Saídas estruturadas. As respostas podem ser forçadas a seguir uma expressão regular, um esquema JSON ou uma gramática.
- Resultados repetíveis. Em chips da Nvidia, um modo invariante ao lote com sementes fixas gera saídas idênticas para entradas idênticas.
A DeepSeek também lançou o deepseek-recipe, uma ferramenta que converte texto em tokens e de volta, feita para bater com a API oficial, informa o Crypto Briefing.
O que está faltando
A versão não é um serviço completo. "Esta versão de código aberto oferece inferência offline com os recursos essenciais necessários para servir em larga escala", diz o README. Ele cita três partes necessárias para um serviço completo que "não estão incluídas nesta versão":
- Um sistema de cache KV, que guarda trabalho anterior para que prompts repetidos saiam mais baratos.
- A desagregação de prefill e decode, que roda as etapas de leitura e de escrita em máquinas separadas.
- Balanceamento de carga entre cópias do modelo.
As alegações de desempenho também não são claras. O README mostra só gráficos, medidos em 4 GPUs SM100 para o processamento de prompts e em 64 para a saída. O Crypto Briefing cita números como 155 trilhões de tokens por dia por cluster e uma taxa de acerto de cache de 96% na entrada. Esses números não aparecem no README, e uma thread no Hacker News rastreou o número de tokens até um post no Zhihu, um site chinês de perguntas e respostas.
O que isso significa para desenvolvedores
O DeepInfer é menos um servidor pronto para usar e mais um olhar detalhado sobre como a DeepSeek roda seus modelos a baixo custo. O valor dele depende do seu hardware e de quanto você quer construir.
- Confira seu hardware primeiro. Ele mira apenas GPUs Nvidia da classe SM100 e NPUs Ascend 950. GPUs mais antigas não estão listadas, então equipes sem esse hardware não conseguem rodá-lo como está.
- Planeje construir as peças que faltam. Sem cache KV, desagregação ou balanceamento de carga, você vai precisar de uma camada de serving própria para o tráfego de produção.
- Leia os kernels, mesmo que nunca o implante. Equipes que rodam modelos mixture-of-experts no vLLM ou no SGLang podem estudar o código de paralelismo e de decodificação especulativa em busca de ideias.
- Use o modo repetível para testes. Saídas idênticas para entradas idênticas tornam os testes de regressão de mudanças de modelo muito mais fáceis em hardware da Nvidia.
- Trate as alegações de throughput como não verificadas. Rode o script de sweep do repositório nos seus próprios chips antes de compará-lo com o seu motor atual.
Fontes
- deepseek-ai/DeepInfer - GitHub
- DeepSeek open-sources DeepInfer, the inference engine behind its production models - Crypto Briefing
- DeepSeek Announces Full Open-Sourcing of Its Internal Inference Framework, DeepInfer - TechFlow via KuCoin
Artigos relacionados
NVIDIA Run:ai vira código aberto, com compartilhamento de GPU incluído
A NVIDIA lançou em 13 de outubro toda a plataforma de orquestração de GPU Run:ai como código aberto, dividida em quatro módulos que as equipes podem adotar um de cada vez.
DeepSeek Harness Desktop chega ao macOS e ao Windows
O Harness, agente da DeepSeek sob licença MIT, agora é distribuído como app de desktop oficial para Macs com Apple silicon e Windows de 64 bits, sem precisar instalar o Node.js.
SDL3 ganha suporte a HarmonyOS, a caminho do SDL 3.6.0
A portabilidade de Ryan Gordon, patrocinada pela Outfit7 e condensada de 77 commits, foi incorporada ao repositório principal em 15 de setembro de 2026 com vídeo, áudio e toque funcionando.