DeepSeek libera como código abierto su motor de inferencia DeepInfer
El motor que hay detrás de la propia API de DeepSeek ya es código Apache 2.0. Ejecuta V4.1-Flash en GPU Nvidia SM100 y chips Huawei Ascend 950, pero sin una capa de caché KV.
3 min de lectura
En cifras
- license for the DeepInfer code
- Apache 2.0
- chip families: Nvidia SM100 and Huawei Ascend 950
- 2
- pieces of a full service left out of this release
- 3
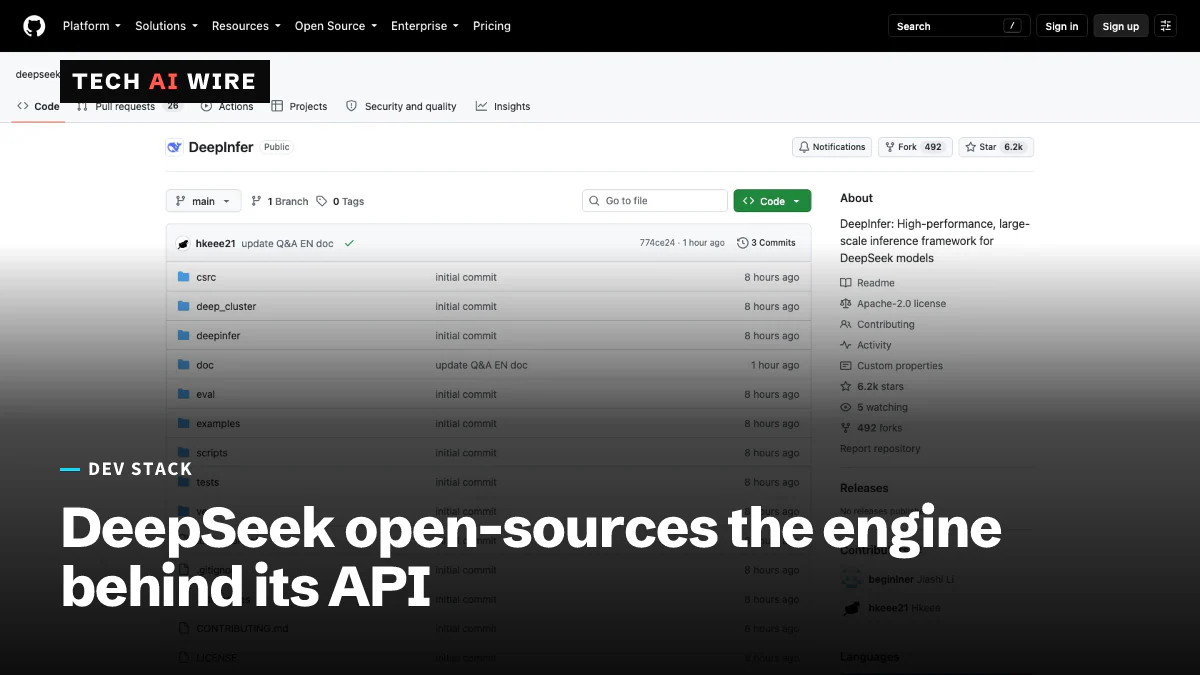
DeepSeek publicó DeepInfer como código abierto el 20 de octubre de 2026. Es el software que usa para ejecutar sus propios modelos de IA en producción. El código está bajo la licencia Apache 2.0 y es compatible con chips de Nvidia y de Huawei. Muestra desde fuera cómo sirve DeepSeek sus propios modelos, aunque la empresa se reserva algunas piezas clave.
Qué es DeepInfer
Un motor de inferencia es el software que ejecuta un modelo de IA entrenado y convierte las peticiones en respuestas. Decide cómo se reparte el modelo entre los chips, cómo se agrupan las peticiones en lotes y a qué velocidad salen los tokens. Ese trabajo determina en gran parte el coste de un servicio de IA.
"DeepInfer es el framework de inferencia de alto rendimiento que impulsa los servicios de producción a gran escala de DeepSeek", dice la página del proyecto en GitHub. El repositorio indica que originalmente se construyó, sobre todo, a partir de vLLM, un popular motor de código abierto, con ideas de SGLang y de TensorRT-LLM de Nvidia.
Por ahora admite un modelo: DeepSeek-V4.1-Flash, con la actualización V4.1-Flash-1017 como opción predeterminada. DeepSeek prevé incorporar el código de futuros modelos al mismo framework, según su anuncio recogido por TechFlow.
Hardware de Nvidia y Huawei
DeepInfer funciona en dos tipos de chips: las GPU para centros de datos de la generación SM100 de Nvidia y las NPU Ascend 950 de Huawei. Una NPU es un procesador diseñado para tareas de IA. El soporte para los chips de Huawei importa porque DeepSeek ha planeado grandes pedidos de ellos.
| Requisito | Detalle |
|---|---|
| Sistema operativo | Linux |
| Compilador | GCC 13 o posterior |
| Python | 3.12 |
| Software de Nvidia | CUDA 13 |
| Software de Huawei | CANN 9.2 |
| Licencia | Apache 2.0 |
La instalación es breve, según el README. Defines DEEPINFER_ACCELERATOR como nvidia o ascend, ejecutas ./build.sh y luego ejecutas python examples/offline_inference.py. El modelo predeterminado se descarga de Hugging Face en la primera ejecución.
Funciones de esta versión
El README enumera las piezas principales:
- Kernels propios. Código para chips ajustado a mano, incluidos FlashMLA, DeepGEMM, DeepEP y kernels escritos en TileLang.
- Paralelismo. El trabajo se reparte entre chips por datos y por expertos. Los modelos de DeepSeek son diseños mixture-of-experts, que envían cada token a unas pocas subredes especializadas.
- Decodificación especulativa. Una función llamada DSpark adivina varios tokens por adelantado y los comprueba, lo que acelera la salida.
- Salidas estructuradas. Se puede obligar a las respuestas a ajustarse a una expresión regular, un esquema JSON o una gramática.
- Resultados repetibles. En chips de Nvidia, un modo invariante al lote con semillas fijas da salidas idénticas para entradas idénticas.
DeepSeek también publicó deepseek-recipe, una herramienta que convierte texto en tokens y viceversa, hecha para coincidir con su API oficial, informa Crypto Briefing.
Qué falta
La versión no es un servicio completo. "Esta versión de código abierto ofrece inferencia offline con las funciones básicas necesarias para servir a gran escala", dice el README. Nombra tres partes necesarias para un servicio completo que "no se incluyen en esta versión":
- Un sistema de caché KV, que guarda trabajo anterior para que los prompts repetidos salgan más baratos.
- La desagregación de prefill y decode, que ejecuta las fases de lectura y de escritura en máquinas separadas.
- El balanceo de carga entre copias del modelo.
Las cifras de rendimiento tampoco están claras. El README solo muestra gráficos, medidos en 4 GPU SM100 para el procesamiento de prompts y en 64 para la salida. Crypto Briefing cita cifras como 155 billones de tokens al día por clúster y una tasa de aciertos de caché del 96 % en la entrada. Esas cifras no aparecen en el README, y un hilo de Hacker News rastreó la cifra de tokens hasta una publicación en Zhihu, un sitio chino de preguntas y respuestas.
Qué significa esto para los desarrolladores
DeepInfer es menos un servidor listo para usar que una mirada detallada a cómo DeepSeek ejecuta sus modelos a bajo coste. Su valor depende de tu hardware y de cuánto quieras construir por tu cuenta.
- Revisa primero tu hardware. Solo apunta a GPU de Nvidia de clase SM100 y a NPU Ascend 950. Las GPU más antiguas no figuran, así que los equipos sin ese hardware no pueden ejecutarlo tal cual.
- Prevé construir las piezas que faltan. Sin caché KV, desagregación ni balanceo de carga, necesitarás tu propia capa de servicio para el tráfico de producción.
- Lee los kernels, aunque nunca lo despliegues. Los equipos que ejecutan modelos mixture-of-experts en vLLM o SGLang pueden estudiar el código de paralelismo y de decodificación especulativa en busca de ideas.
- Usa el modo repetible para hacer pruebas. Las salidas idénticas para entradas idénticas facilitan mucho las pruebas de regresión de cambios de modelo en hardware de Nvidia.
- Trata las cifras de throughput como no verificadas. Ejecuta el script de barrido del repositorio en tus propios chips antes de compararlo con tu motor actual.
Fuentes
- deepseek-ai/DeepInfer - GitHub
- DeepSeek open-sources DeepInfer, the inference engine behind its production models - Crypto Briefing
- DeepSeek Announces Full Open-Sourcing of Its Internal Inference Framework, DeepInfer - TechFlow via KuCoin
Artículos relacionados
NVIDIA Run:ai pasa a ser de código abierto, con el reparto de GPU incluido
NVIDIA publicó el 13 de octubre toda su plataforma de orquestación de GPU Run:ai como código abierto, dividida en cuatro módulos que los equipos pueden adoptar de uno en uno.
DeepSeek Harness Desktop llega a macOS y Windows
Harness, el agente de DeepSeek con licencia MIT, ya se distribuye como app de escritorio oficial para Mac con Apple silicon y Windows de 64 bits, sin necesidad de instalar Node.js.
SDL3 gana soporte para HarmonyOS, rumbo a SDL 3.6.0
El port de Ryan Gordon, patrocinado por Outfit7 y condensado desde 77 commits, se fusionó en el repositorio principal el 15 de septiembre de 2026 con vídeo, audio y tacto funcionando.