DeepSeek publie en open source son moteur d'inférence DeepInfer
Le moteur qui fait tourner la propre API de DeepSeek est désormais du code sous Apache 2.0. Il exécute V4.1-Flash sur les GPU Nvidia SM100 et les puces Huawei Ascend 950, sans couche de cache KV.
3 min de lecture
En chiffres
- license for the DeepInfer code
- Apache 2.0
- chip families: Nvidia SM100 and Huawei Ascend 950
- 2
- pieces of a full service left out of this release
- 3
DeepSeek a publié DeepInfer en open source le 20 octobre 2026. C'est le logiciel que l'entreprise utilise pour faire tourner ses propres modèles d'IA en production. Le code est sous licence Apache 2.0 et prend en charge les puces Nvidia comme celles de Huawei. Il montre de l'extérieur comment DeepSeek sert ses propres modèles, même si quelques éléments clés restent réservés.
Ce qu'est DeepInfer
Un moteur d'inférence est le logiciel qui exécute un modèle d'IA entraîné et transforme les requêtes en réponses. Il décide comment le modèle est réparti entre les puces, comment les requêtes sont regroupées en lots et à quelle vitesse les tokens sortent. Ce travail détermine en grande partie le coût d'un service d'IA.
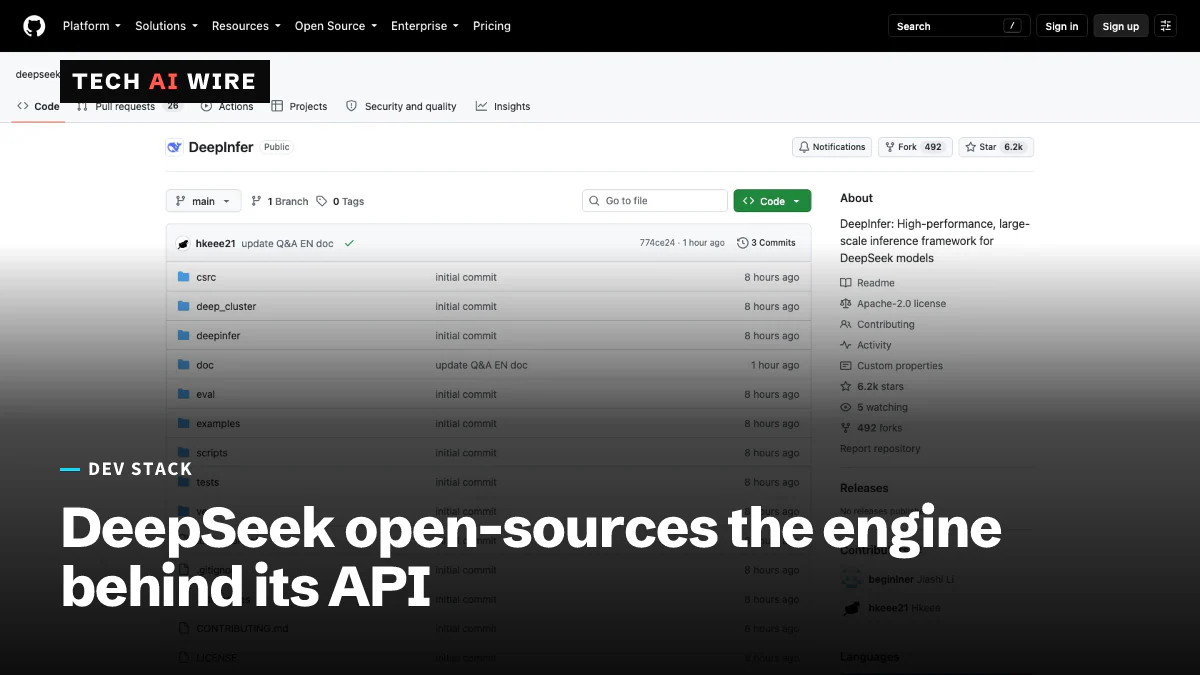
« DeepInfer est le framework d'inférence haute performance qui fait tourner les services de production à grande échelle de DeepSeek », indique la page GitHub du projet. Le dépôt précise qu'il a d'abord été construit principalement sur vLLM, un moteur open source populaire, avec des idées tirées de SGLang et de TensorRT-LLM de Nvidia.
Pour l'instant, il prend en charge un seul modèle : DeepSeek-V4.1-Flash, avec la mise à jour V4.1-Flash-1017 par défaut. DeepSeek prévoit d'intégrer le code de ses futurs modèles dans le même framework, selon son annonce relayée par TechFlow.
Matériel Nvidia et Huawei
DeepInfer fonctionne sur deux types de puces : les GPU de centre de données Nvidia de génération SM100 et les NPU Ascend 950 de Huawei. Un NPU est un processeur conçu pour les tâches d'IA. La prise en charge des puces Huawei compte, car DeepSeek a prévu d'en commander en grande quantité.
| Exigence | Détail |
|---|---|
| Système d'exploitation | Linux |
| Compilateur | GCC 13 ou plus récent |
| Python | 3.12 |
| Logiciel Nvidia | CUDA 13 |
| Logiciel Huawei | CANN 9.2 |
| Licence | Apache 2.0 |
L'installation est courte, d'après le README. Vous réglez DEEPINFER_ACCELERATOR sur nvidia ou ascend, lancez ./build.sh, puis lancez python examples/offline_inference.py. Le modèle par défaut se télécharge depuis Hugging Face au premier lancement.
Les fonctions de cette version
Le README liste les principaux éléments :
- Kernels personnalisés. Du code optimisé à la main pour les puces, dont FlashMLA, DeepGEMM, DeepEP et des kernels écrits en TileLang.
- Parallélisme. Le travail est réparti entre les puces par données et par experts. Les modèles de DeepSeek sont des architectures mixture-of-experts, qui envoient chaque token vers quelques sous-réseaux spécialisés.
- Décodage spéculatif. Une fonction appelée DSpark devine plusieurs tokens à l'avance et les vérifie, ce qui accélère la sortie.
- Sorties structurées. Les réponses peuvent être contraintes à respecter une expression régulière, un schéma JSON ou une grammaire.
- Résultats reproductibles. Sur les puces Nvidia, un mode invariant au batch avec des graines fixes donne des sorties identiques pour des entrées identiques.
DeepSeek a aussi publié deepseek-recipe, un outil qui convertit le texte en tokens et inversement, conçu pour correspondre à son API officielle, rapporte Crypto Briefing.
Ce qui manque
Cette version n'est pas un service complet. « Cette version open source fournit l'inférence hors ligne avec les fonctions de base nécessaires pour servir à grande échelle », indique le README. Il cite trois éléments nécessaires à un service complet qui ne sont « pas inclus dans cette version » :
- Un système de cache KV, qui stocke le travail déjà fait pour que les prompts répétés coûtent moins cher.
- La désagrégation du prefill et du decode, qui exécute les phases de lecture et d'écriture sur des machines séparées.
- La répartition de charge entre plusieurs copies du modèle.
Les performances annoncées sont elles aussi floues. Le README ne montre que des graphiques, mesurés sur 4 GPU SM100 pour le traitement des prompts et sur 64 pour la sortie. Crypto Briefing cite des chiffres comme 155 000 milliards de tokens par jour et par cluster et un taux de succès du cache de 96 % en entrée. Ces chiffres n'apparaissent pas dans le README, et un fil Hacker News a fait remonter le chiffre des tokens à un post sur Zhihu, un site chinois de questions-réponses.
Ce que cela signifie pour les développeurs
DeepInfer est moins un serveur prêt à l'emploi qu'un aperçu détaillé de la façon dont DeepSeek fait tourner ses modèles à bas coût. Son intérêt dépend de votre matériel et de ce que vous acceptez de construire vous-même.
- Vérifiez d'abord votre matériel. Il vise uniquement les GPU Nvidia de classe SM100 et les NPU Ascend 950. Les GPU plus anciens ne figurent pas dans la liste, donc les équipes sans ce matériel ne peuvent pas l'exécuter tel quel.
- Prévoyez de construire les éléments manquants. Sans cache KV, sans désagrégation et sans répartition de charge, il vous faudra votre propre couche de service pour le trafic de production.
- Lisez les kernels, même si vous ne le déployez jamais. Les équipes qui font tourner des modèles mixture-of-experts sur vLLM ou SGLang peuvent étudier le code de parallélisme et de décodage spéculatif pour y trouver des idées.
- Utilisez le mode reproductible pour les tests. Des sorties identiques pour des entrées identiques facilitent beaucoup les tests de régression sur les changements de modèle avec du matériel Nvidia.
- Considérez les chiffres de débit comme non vérifiés. Lancez le script de balayage du dépôt sur vos propres puces avant de le comparer à votre moteur actuel.
Sources
- deepseek-ai/DeepInfer - GitHub
- DeepSeek open-sources DeepInfer, the inference engine behind its production models - Crypto Briefing
- DeepSeek Announces Full Open-Sourcing of Its Internal Inference Framework, DeepInfer - TechFlow via KuCoin
Articles liés
NVIDIA Run:ai passe en open source, partage de GPU compris
NVIDIA a publié le 13 octobre l'intégralité de sa plateforme d'orchestration GPU Run:ai en open source, découpée en quatre modules que les équipes peuvent adopter un par un.
DeepSeek Harness Desktop arrive sur macOS et Windows
Harness, l'agent de DeepSeek sous licence MIT, est désormais proposé en application de bureau officielle pour les Mac Apple silicon et Windows 64 bits, sans installer Node.js.
SDL3 prend en charge HarmonyOS, en route pour SDL 3.6.0
Le portage de Ryan Gordon, financé par Outfit7 et condensé de 77 commits, a été fusionné en amont le 15 septembre 2026, avec la vidéo, l'audio et le tactile fonctionnels.