NVIDIA Run:ai vira código aberto, com compartilhamento de GPU incluído
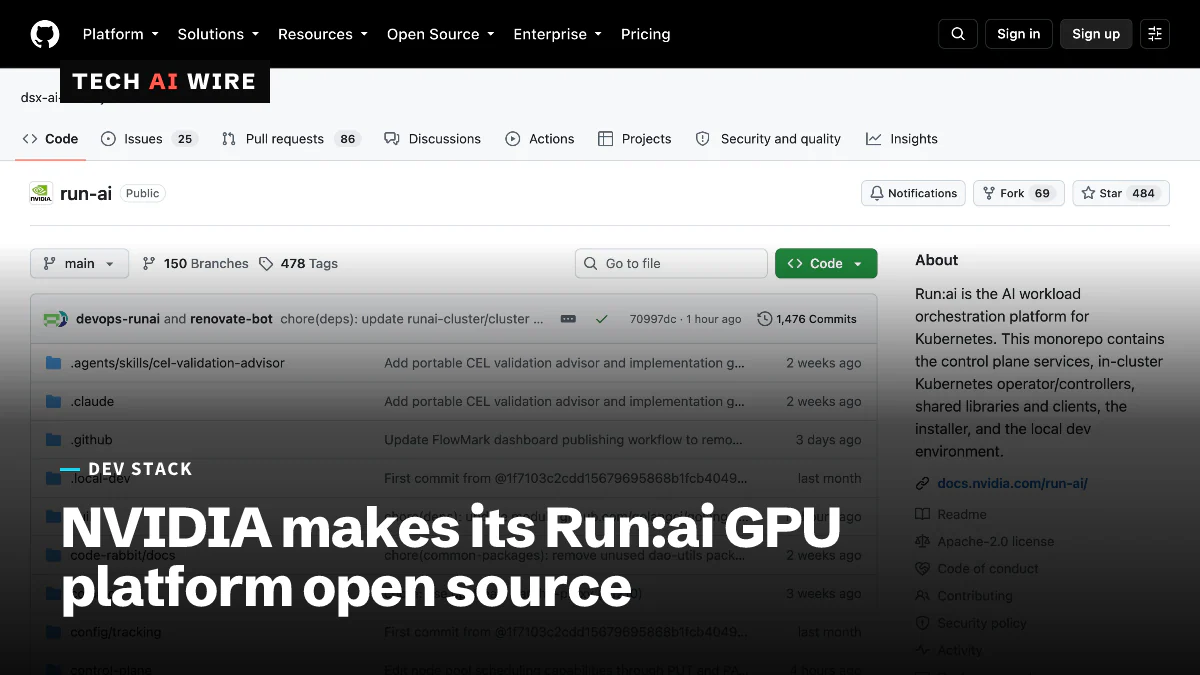
A NVIDIA lançou em 13 de outubro toda a plataforma de orquestração de GPU Run:ai como código aberto, dividida em quatro módulos que as equipes podem adotar um de cada vez.
4 min de leitura
Em números
- modules that can be adopted one at a time
- 4
- partner platforms integrating it at launch
- 8
- of full-GPU throughput at half a GPU, in Nebius tests
- 77%
- subscription needed; NVIDIA support not included
- $0
A NVIDIA lançou toda a sua plataforma Run:ai como código aberto em 13 de outubro de 2026. O Run:ai é um software que decide quais tarefas de IA rodam em quais GPUs de um cluster. Até agora, a maior parte dele era um produto pago. Qualquer equipe que rode GPUs da NVIDIA no Kubernetes agora pode instalá-lo sem assinatura.
Isso importa porque GPUs são caras e muitas vezes ficam ociosas. A principal função do Run:ai é encaixar mais trabalho nos mesmos chips.
O que a NVIDIA lançou
Segundo o anúncio da NVIDIA, toda a plataforma agora é de código aberto como parte da sua DSX AI Factory Platform. A NVIDIA comprou o Run:ai no fim de 2024, observa o Techstrong.ai.
A plataforma roda no Kubernetes, o sistema amplamente usado para executar software em muitos servidores. A NVIDIA a dividiu em quatro partes que as equipes podem adotar separadamente: KAI Scheduler, o GPU Fractioning Operator, KAI Resource Management e Workload Map.
| Item | Detalhe |
|---|---|
| Lançamento | 13 de outubro de 2026 |
| Módulos | KAI Scheduler, GPU Fractioning Operator, KAI Resource Management, Workload Map |
| Onde obter | NGC Community Product, instalado com um Helm chart |
| Preço | Nenhuma assinatura paga exigida |
| Suporte | Suporte empresarial da NVIDIA não incluído |
| Licença do KAI Scheduler | Apache 2.0, um projeto Sandbox da CNCF |
| Parceiros de lançamento | 8 |
NGC é o catálogo de software da NVIDIA. Um Helm chart é um pacote de instalação pronto para o Kubernetes.
O KAI Scheduler em si não é novidade no código aberto. Ele está disponível sob a licença Apache 2.0 desde abril de 2025 e foi doado à CNCF, a fundação por trás do Kubernetes, como projeto Sandbox em estágio inicial. O código do restante fica na organização DSX AI Factory da NVIDIA no GitHub. O post da NVIDIA diz que ele é distribuído sob “licenças de código aberto aplicáveis”, sem nomear uma para a plataforma inteira.
Como funciona o compartilhamento de GPU
O principal recurso é o fracionamento, ou seja, dividir uma GPU entre várias tarefas. Um modelo pequeno que atende um chatbot raramente precisa de uma GPU de data center inteira. Sem compartilhamento, ele recebe uma mesmo assim, e o resto fica sem uso.
O Techstrong.ai informa que o fracionamento passa da versão proprietária da NVIDIA para suporte nativo no CUDA 13.4, o kit de programação de GPU da NVIDIA. O operador de código aberto adiciona a camada do Kubernetes por cima.
A Nebius, provedora de nuvem e parceira de lançamento, publicou resultados de testes. Os testes usaram a versão comercial 2.24 do Run:ai, não a nova versão aberta:
- Com meia GPU, as cargas de trabalho mantiveram 77% da vazão de uma GPU inteira.
- Com meia GPU, mantiveram 86% dos usuários que uma GPU inteira conseguia atender: 8.768 contra 10.200.
- Rodar juntos modelos de chat, raciocínio e embeddings em GPUs compartilhadas atendeu cerca de três vezes mais usuários do que dar a cada um a sua própria GPU.
“Se meia GPU entrega 77% da vazão, a alocação de tudo ou nada está deixando capacidade ociosa”, escreve a Nebius.
Quem está apoiando
Oito parceiros integram a plataforma no lançamento, segundo a NVIDIA: Crusoe, Mirantis, Nebius, OpenNebula Systems, Rafay, Saturn Cloud, Spectro Cloud e vCluster. A Nebius a oferece no seu serviço gerenciado de Kubernetes.
A NVIDIA também cita resultados do Model Streamer, uma ferramenta relacionada que carrega arquivos de modelos nas GPUs mais rápido. O Microsoft Azure relata carregamento de três a seis vezes mais rápido, a 80 Gbps constantes contra cerca de 40 Gbps no caminho padrão.
O porém: ainda roda sobre CUDA
O Techstrong.ai aponta o limite. O compartilhamento de GPU depende do CUDA, então só funciona em hardware da NVIDIA. O Run:ai já disse que daria suporte a chips da AMD e da Intel, e este lançamento não trata disso.
“Código aberto não é sinônimo de neutralidade de hardware, e os compradores devem julgar este lançamento por esse critério”, disse Mitch Ashley, do The Futurum Group. “O teste de verdade vem quando um segundo fornecedor de aceleradores entrar no data center.”
O que isso significa para os desenvolvedores
Para equipes de plataforma que rodam GPUs no Kubernetes:
- Comece por um módulo. O KAI Scheduler é a peça mais madura, com mais de um ano como código aberto. Teste-o em um cluster de testes antes de adicionar o compartilhamento de GPU.
- Faça benchmark do compartilhamento com seus próprios modelos. O número de 77% veio dos testes da Nebius com a versão comercial. Tarefas de inferência com tráfego estável e pequeno são as melhores candidatas. Grandes tarefas de treinamento costumam ainda precisar de GPUs inteiras.
- Planeje o suporte por conta própria. A versão gratuita vem sem o suporte empresarial da NVIDIA. Reserve tempo de engenharia para operá-la ou use um dos oito parceiros.
- Confira as licenças repositório por repositório. A NVIDIA cita Apache 2.0 para o KAI Scheduler, mas nenhuma licença única para a plataforma inteira. Peça ao jurídico que revise cada componente que você implantar.
- Calcule o aprisionamento. O fracionamento nativo exige CUDA 13.4. Se você pretende adicionar AMD ou outros aceleradores, mantenha opções de agendamento que não dependam dele.
Fontes
Artigos relacionados
ZLUDA agora roda cuFFT em GPUs AMD via hipFFT
Um pull request já mesclado adiciona a biblioteca cuFFT da NVIDIA ao ZLUDA, permitindo que GPUs AMD rodem unidades do Folding@Home baseadas em CUDA sem alterar o código.

Nouveau inicializa no DGX Spark GB10 da Nvidia, de forma não oficial
Um engenheiro da Red Hat conseguiu rodar o driver aberto Nouveau e o NVK no DGX Spark GB10 da Nvidia. Foram necessários cerca de 100 patches, e ainda não está definido como integrar isso oficialmente.
Microsoft teria deixado o data center da Nscale em Loughton
A Microsoft teria desistido do acordo para ser a inquilina âncora do local da Nscale em Loughton, onde a energia pode só chegar nos anos 2030, semanas antes de um IPO de US$ 3 bilhões.