TorchTPU: Google abre o código de um PyTorch nativo para TPUs
O TorchTPU roda PyTorch nativamente nas TPUs do Google e passou em 98% dos 4.917 modelos do Hugging Face testados. O PyTorch/XLA foi descontinuado e será arquivado em 15 de novembro.
3 min de leitura
Em números
- of 4,917 Hugging Face models passed Google's first test tier
- 98%
- PyTorch core operations implemented
- ~450
- the date the PyTorch/XLA repository is archived
- Nov 15
O Google abriu o código do TorchTPU em 20 de outubro de 2026, um backend que executa código PyTorch nativamente em seus chips TPU. Isso importa porque ele substitui o PyTorch/XLA, o caminho mais antigo e mais difícil até as TPUs, que será arquivado em 15 de novembro. O Google diz que o código existente deve migrar com pouco mais do que uma troca do nome do dispositivo.
O que é o TorchTPU
TPUs são os chips de IA que o Google projeta e aluga pelo Google Cloud. PyTorch é a biblioteca mais usada para criar e treinar modelos de IA. Até agora, o PyTorch chegava às TPUs pelo PyTorch/XLA, que transforma um modelo em um grafo compilado antes da execução.
O TorchTPU, em vez disso, transforma a TPU em um dispositivo PyTorch comum. “Portar uma carga de trabalho para TPU deve ser tão simples quanto trocar model.to("cuda") por model.to("tpu")”, escreve a equipe no anúncio no blog do PyTorch. O Google o desenvolveu com a equipe do PyTorch da Meta, a partir de meados de 2025.
O repositório no GitHub do projeto lista a versão 0.2.0 no PyPI, a licença Apache 2.0 e Python 3.11 ou mais recente. O Crypto Briefing informa que o lançamento abrange quatro repositórios e foi apresentado na PyTorch Conference. O blog os nomeia como TorchTPU, vLLM-TorchTPU, SGLang-TorchTPU e TorchTitan, que cobrem o backend principal, dois motores para servir modelos e uma biblioteca de treinamento.
Como ele executa o código
O TorchTPU implementa cerca de 450 operações ATen, as funções matemáticas básicas das quais todo modelo PyTorch é feito. Por padrão, o código roda linha por linha no modo “eager”, como no PyTorch normal. O blog descreve três modos eager:
| Modo | Como ativar | O que faz |
|---|---|---|
| Strict | Padrão | Executa cada operação como foi escrita |
| Debug | TORCH_TPU_LAUNCH_BLOCKING=1 | Espera cada operação, para facilitar a depuração |
| DeferAndFuse | TORCH_TPU_DEFER_AND_FUSE=1 | Agrupa as operações; “50% ou mais rápido que o Strict Eager” |
Para mais velocidade, torch.compile(backend="tpu") transforma um modelo em um único programa de TPU. Código personalizado para o chip pode ser escrito com o Pallas, do JAX, ou com o Helion. O blog lista integrações com vLLM, SGLang, TorchTitan, Ray e TorchRec. O blog também diz que alguns dos maiores clientes do Google Cloud já usam o TorchTPU em produção.
Como os modelos se saem
Por enquanto, os únicos números vêm dos testes do próprio Google. O blog relata estes resultados:
| Teste | Resultado |
|---|---|
| Modelos do Hugging Face executados | 4.917, de mais de 500 famílias de modelos |
| Passaram no primeiro nível de testes | 98% (4.821 de 4.917) |
| Saída igual à de uma GPU | 97% (638 de 657 verificados) |
| Treinamento do Qwen3 235B em 64 chips TPU v7 | 1.828 tokens/s no PyTorch, ante 1.937 na stack JAX do Google |
O Crypto Briefing cita o número do Google de 52% de utilização de FLOPs do modelo no treinamento do Qwen 3 8B em até 8.192 chips TPU v7x. Essa medida é a fração da capacidade máxima de cálculo de um chip que o modelo realmente usa.
O PyTorch/XLA está sendo aposentado
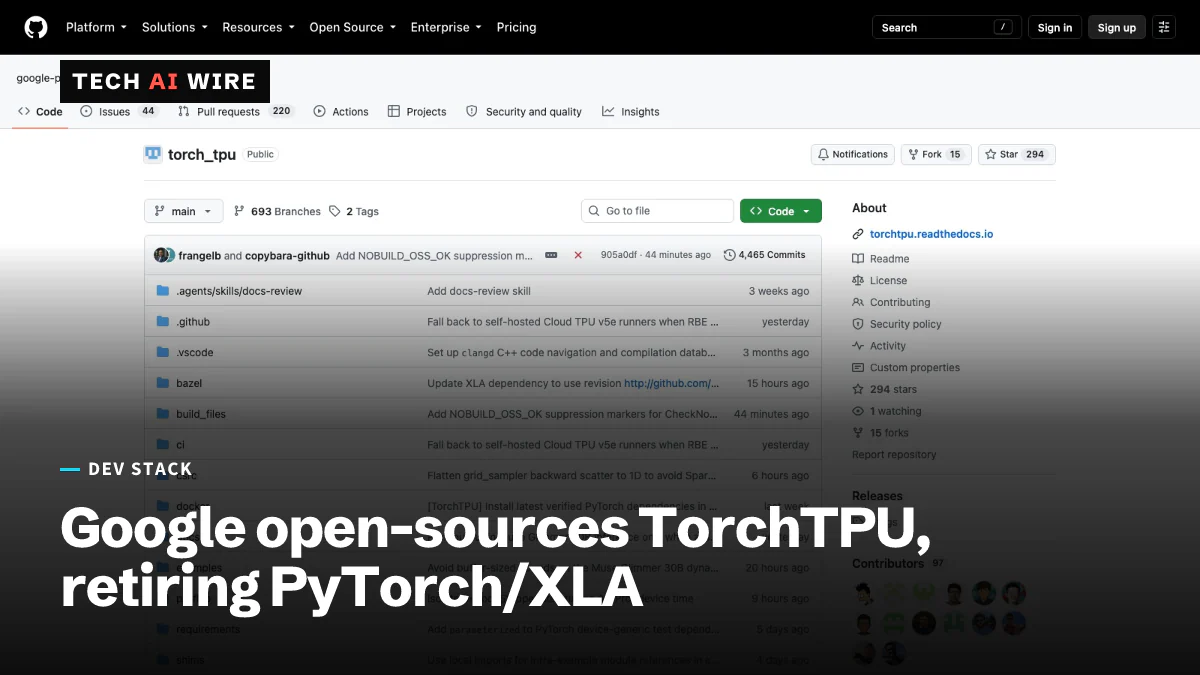
O repositório do PyTorch/XLA agora abre com um aviso: “Este projeto foi descontinuado e substituído pelo TorchTPU.” Ele acrescenta que o repositório “será arquivado em 15 de novembro de 2026”, o que o torna somente leitura. A recomendação é “começar novas cargas de trabalho PyTorch em TPU com o TorchTPU e migrar as cargas de trabalho PyTorch/XLA existentes”. A última instalação estável listada fixa torch e torch_xla na versão 2.8.0.
No mesmo dia, o backend TorchNeuron da Amazon para seus chips Trainium entrou em beta pública e abandonou a mesma abordagem XLA. Os dois provedores de nuvem agora tratam seus chips de IA como dispositivos PyTorch comuns.
O que isso significa para desenvolvedores
O TorchTPU faz de uma TPU apenas mais uma string de dispositivo, o que coloca os chips do Google na mesma comparação de preços que as GPUs.
- Planeje agora sua saída do PyTorch/XLA. Depois de 15 de novembro, o repositório não recebe mais correções. Fixe o
torch_xla2.8.0 para jobs em execução e teste o TorchTPU em uma máquina v6e, que o README sugere como o ponto de partida mais fácil. - Verifique primeiro os 2%. O próprio teste do Google ainda falha em cerca de um modelo a cada cinquenta. Rode um job curto de treinamento ou inferência com o seu modelo exato antes de planejar uma migração.
- Reserve tempo para kernels CUDA personalizados. Código de GPU escrito à mão não é aproveitado. Ele precisa ser reescrito em Pallas ou Helion, então inclua esse trabalho no orçamento.
- Fixe a versão. Esta é a versão 0.2.0. Trave-a nos arquivos de requirements e confira os resultados de novo após cada atualização.
- Faça seus próprios benchmarks. Todos os números de velocidade aqui vêm do Google. Compare o custo por token na sua própria carga de trabalho, contra GPUs e chips de outras nuvens.
Fontes
- Introducing TorchTPU - PyTorch Blog
- google-pytorch/torch_tpu - GitHub
- pytorch/xla - GitHub
- Google open-sources TorchTPU to bring native PyTorch support to its TPUs - Crypto Briefing
Artigos relacionados
DuckDB 2.0 LTS adiciona modo servidor, gatilhos e VARIANT
O DuckDB 2.0.0, uma versão de suporte de longo prazo lançada em 21 de outubro, adiciona modo servidor, gatilhos e VARIANT. Versões anteriores à 2.0 não conseguem ler seus arquivos.
PyTorch 2.15 acelera em até 6,5 vezes a decodificação MoE em Macs
O PyTorch 2.15 adiciona tensores FP8 nas GPUs da Apple e novos kernels Metal. A decodificação do Qwen3.6-35B-A3B em um M3 Ultra salta de 9,4 para 61,3 tokens por segundo.
Beta do TorchNeuron leva PyTorch nativo ao AWS Trainium
89% dos 100 principais modelos de geração de texto agora rodam no AWS Trainium sem ajustes, ante 46%, com a entrada do backend PyTorch TorchNeuron em beta pública.