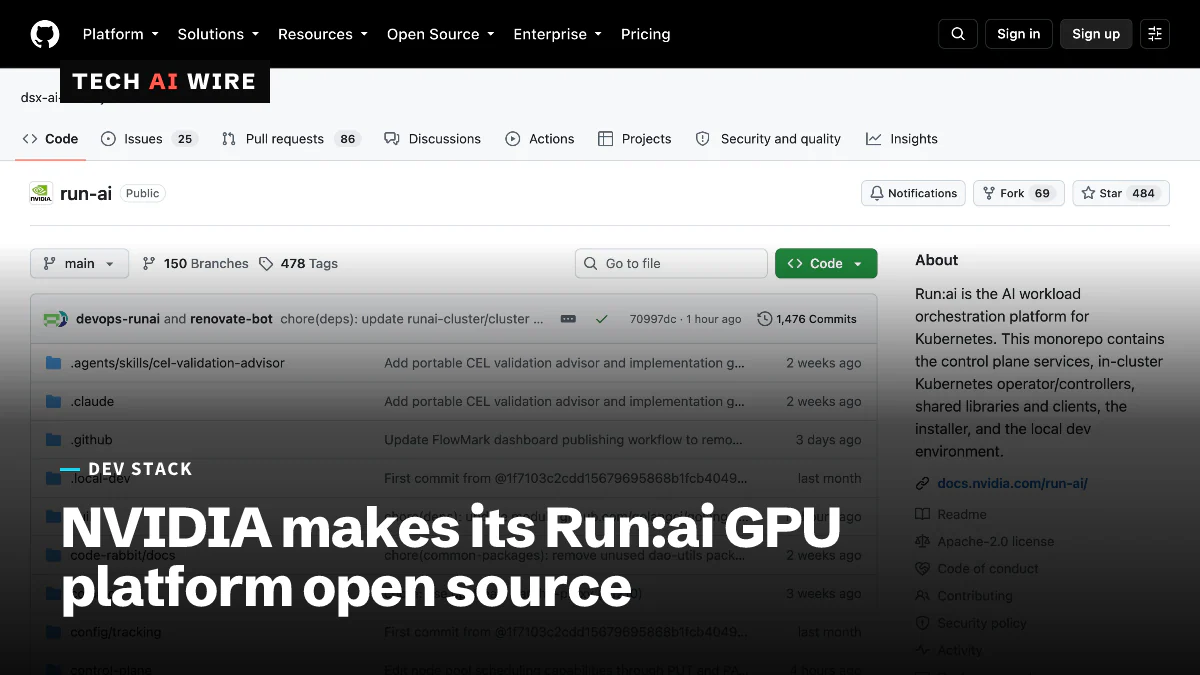
NVIDIA Run:ai passe en open source, partage de GPU compris
NVIDIA a publié le 13 octobre l'intégralité de sa plateforme d'orchestration GPU Run:ai en open source, découpée en quatre modules que les équipes peuvent adopter un par un.
4 min de lecture
En chiffres
- modules that can be adopted one at a time
- 4
- partner platforms integrating it at launch
- 8
- of full-GPU throughput at half a GPU, in Nebius tests
- 77%
- subscription needed; NVIDIA support not included
- $0
NVIDIA a publié l'intégralité de sa plateforme Run:ai en open source le 13 octobre 2026. Run:ai est un logiciel qui décide quelles tâches d'IA tournent sur quels GPU dans un cluster. Jusqu'ici, l'essentiel en était un produit payant. Toute équipe qui exploite des GPU NVIDIA sur Kubernetes peut désormais l'installer sans abonnement.
C'est important, car les GPU coûtent cher et restent souvent inactifs. Le rôle principal de Run:ai est de faire tenir plus de travail sur les mêmes puces.
Ce que NVIDIA a publié
Selon l'annonce de NVIDIA, toute la plateforme est désormais open source dans le cadre de sa DSX AI Factory Platform. NVIDIA a racheté Run:ai fin 2024, rappelle Techstrong.ai.
La plateforme fonctionne sur Kubernetes, le système très répandu pour faire tourner des logiciels sur de nombreux serveurs. NVIDIA l'a divisée en quatre parties que les équipes peuvent adopter séparément : KAI Scheduler, le GPU Fractioning Operator, KAI Resource Management et Workload Map.
| Élément | Détail |
|---|---|
| Publication | 13 octobre 2026 |
| Modules | KAI Scheduler, GPU Fractioning Operator, KAI Resource Management, Workload Map |
| Où l'obtenir | NGC Community Product, installé avec un Helm chart |
| Prix | Aucun abonnement payant requis |
| Support | Support entreprise de NVIDIA non inclus |
| Licence de KAI Scheduler | Apache 2.0, un projet CNCF Sandbox |
| Partenaires au lancement | 8 |
NGC est le catalogue de logiciels de NVIDIA. Un Helm chart est un paquet d'installation prêt à l'emploi pour Kubernetes.
KAI Scheduler lui-même n'est pas nouveau dans l'open source. Il est disponible sous licence Apache 2.0 depuis avril 2025 et a été confié à la CNCF, la fondation derrière Kubernetes, en tant que projet Sandbox à un stade précoce. Le code du reste se trouve dans l'organisation DSX AI Factory de NVIDIA sur GitHub. Le billet de NVIDIA indique qu'il est distribué sous des « licences open source applicables », sans en nommer une pour l'ensemble de la plateforme.
Comment fonctionne le partage de GPU
La fonction phare est le fractionnement, c'est-à-dire la division d'un GPU entre plusieurs tâches. Un petit modèle qui fait tourner un chatbot a rarement besoin d'un GPU de centre de données entier. Sans partage, il en reçoit quand même un, et le reste demeure inutilisé.
Techstrong.ai rapporte que le fractionnement passe de la version propriétaire de NVIDIA à une prise en charge native dans CUDA 13.4, la boîte à outils de programmation GPU de NVIDIA. L'opérateur open source ajoute la couche Kubernetes par-dessus.
Nebius, fournisseur cloud et partenaire de lancement, a publié des résultats de tests. Ces tests ont utilisé la version commerciale 2.24 de Run:ai, et non la nouvelle version ouverte :
- Avec un demi-GPU, les charges de travail ont conservé 77 % du débit d'un GPU entier.
- Avec un demi-GPU, elles ont conservé 86 % des utilisateurs qu'un GPU entier pouvait servir : 8 768 contre 10 200.
- Faire tourner ensemble des modèles de chat, de raisonnement et d'embedding sur des GPU partagés a permis de servir environ trois fois plus d'utilisateurs que de donner à chacun son propre GPU.
« Si un demi-GPU fournit 77 % du débit, une allocation du tout ou rien laisse de la capacité inutilisée », écrit Nebius.
Qui la soutient
Huit partenaires intègrent la plateforme dès le lancement, selon NVIDIA : Crusoe, Mirantis, Nebius, OpenNebula Systems, Rafay, Saturn Cloud, Spectro Cloud et vCluster. Nebius la propose sur son service Kubernetes managé.
NVIDIA cite aussi des résultats pour Model Streamer, un outil connexe qui charge plus vite les fichiers de modèles sur les GPU. Microsoft Azure fait état d'un chargement trois à six fois plus rapide, à un débit constant de 80 Gbit/s contre environ 40 Gbit/s par la voie par défaut.
Le hic : tout repose encore sur CUDA
Techstrong.ai pointe la limite. Le partage de GPU dépend de CUDA, il ne fonctionne donc que sur du matériel NVIDIA. Run:ai avait un jour annoncé la prise en charge des puces AMD et Intel, et cette publication n'aborde pas ce point.
« Open source ne veut pas dire neutre vis-à-vis du matériel, et les acheteurs devraient juger cette publication sur ce critère », a déclaré Mitch Ashley, de The Futurum Group. « Le vrai test viendra quand un deuxième fournisseur d'accélérateurs entrera dans le centre de données. »
Ce que cela signifie pour les développeurs
Pour les équipes plateforme qui exploitent des GPU sur Kubernetes :
- Commencez par un seul module. KAI Scheduler est la brique la plus mûre, avec plus d'un an en open source. Essayez-le sur un cluster de test avant d'ajouter le partage de GPU.
- Mesurez le partage sur vos propres modèles. Le chiffre de 77 % vient des tests de Nebius sur la version commerciale. Les tâches d'inférence au trafic stable et faible sont les meilleures candidates. Les gros entraînements demandent généralement encore des GPU entiers.
- Prévoyez le support vous-même. La version gratuite est fournie sans le support entreprise de NVIDIA. Budgétez du temps d'ingénierie pour l'exploiter, ou passez par l'un des huit partenaires.
- Vérifiez les licences dépôt par dépôt. NVIDIA indique Apache 2.0 pour KAI Scheduler, mais aucune licence unique pour toute la plateforme. Faites examiner par le service juridique chaque composant que vous déployez.
- Évaluez la dépendance. Le fractionnement natif nécessite CUDA 13.4. Si vous prévoyez d'ajouter des accélérateurs AMD ou autres, gardez des choix d'ordonnancement qui n'en dépendent pas.
Sources
Articles liés
ZLUDA prend en charge cuFFT sur les GPU AMD via hipFFT
Une pull request fusionnée ajoute la bibliothèque cuFFT de NVIDIA à ZLUDA, permettant aux GPU AMD de faire tourner des unités Folding@Home basées sur CUDA sans modification de code.

Nouveau démarre sur le DGX Spark GB10 de Nvidia, officieusement
Un ingénieur de Red Hat a fait fonctionner le pilote open source Nouveau et NVK sur le DGX Spark GB10 de Nvidia. Il a fallu environ 100 correctifs, et l'intégration en amont n'est pas encore réglée.
Microsoft se retirerait du centre de données de Nscale à Loughton
Microsoft aurait renoncé à son accord de locataire d'ancrage sur le site de Nscale à Loughton, où l'électricité pourrait n'arriver que dans les années 2030, à quelques semaines d'une IPO de 3 milliards de dollars.